
RecSys Summer School, часть 4.
Michael Ekstrand (которого я уже упоминал в контексте прошлого рексиса) выступил дважды. Одно выступление было вечернее, вне основной программы (как разогрев перед пивной вечеринкой). Сначала он сослался на книжку Long tail от Chris Andersen. Я в своих лекциях часто упоминаю, что проблема тяжелого хвоста (в первую очередь айтемов) — это фундаментальная проблема рекомендаций, которую мы пытаемся решать, и Майкл это очень хорошо подсветил. Грубо говоря, до существования рексистем количество реально потребляемого контента было довольно маленькое. Все слушали, читали, смотрели примерно одно и то же. И без рекомендательных систем “тяжелый хвост” контента банально никто бы не заметил. Вернее, не заметил бы никто из тех, кому бы он понравился. Это своего рода магия, что мы позволяем тяжелому хвосту нормально реализовываться :)
Был и другой пример необходимости персонализации — в социальных сетях можно довольно легко сделать рекомендательную ленту, показывая все посты друзей в хронологическом порядке. Но тогда если ваш лучший друг 6 часов назад выложил свой великолепный пирог с дня рождения, вы с большой вероятностью об этом никогда не узнаете, потому что за эти 6 часов ваша лента уже забьется кучей других постов. И здесь возникает необходимость персонализации — показывать вам в первую очередь посты от близких друзей, делать так, чтобы вы могли увидеть даже слегка устаревшие посты от них при заходе в ленту.
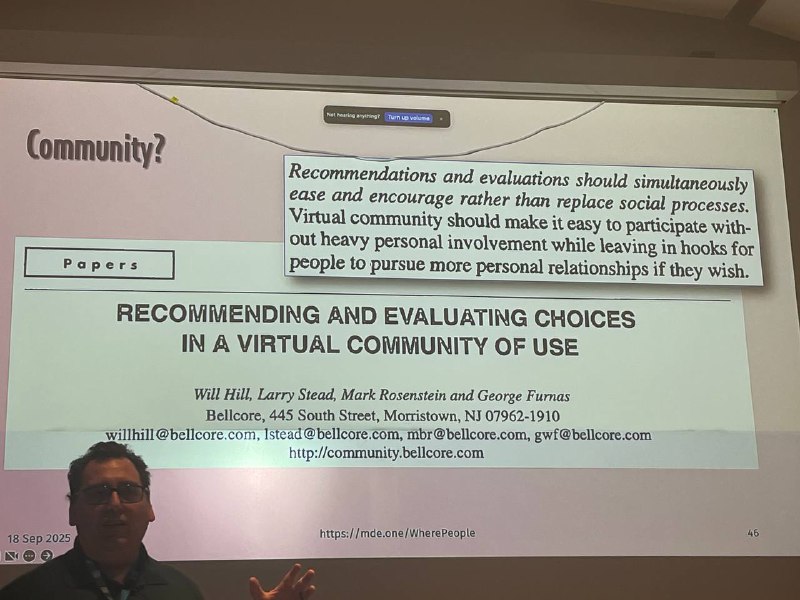
Еще упоминался термин “Enshittification” (от Cory Doctorow) — сначала онлайн-платформа набирает пользовательскую базу, предлагая хорошую функциональность; затем смещает фокус с юзеров на бизнес (рекламодателей, продавцов) и начинает постепенно ронять качество контента; и затем , когда пользователям и бизнесу уже сложно перейти на другую платформу, начинает активно максимизировать прибыль для инвесторов (любой ценой). Майкл это привязал к генеративному AI — раньше рексистемы в том числе помогали налаживать связи между людьми (кто-то напишет блогпост, сделает трек, нарисует картину, и другие люди это увидят; ну и не забываем про соцсети конечно), а сейчас генеративный AI вбирает в себя весь функционал, становясь основным интерфейсом для пользователя. Соответственно, связи между людьми теряются.
Но основная цель рексистем по мнению Майкла — это все же information access, то есть предоставлять людям доступ к информации. Привел интересную аналогию с библиотекарями, которые занимаются примерно тем же самым. И у которых тоже есть вопросы типа “а должны ли мы предоставлять любую информацию, или ее нужно как-то ограничивать?”. Они этот вопрос решают следующим образом — обеспечивать доступ к любой информации действительно нужно (грубо говоря, книги сжигать не нужно), но при этом помогать искать потенциально вредоносный контент (например, таковым они считают контент, которые демократические ценности не поддерживает) — они не обязаны :) В их code of conduct вшита небольшая демократическая политическая повестка. Также Майкл показал code of conduct ACM, в котором, кстати, такой повестки нет совсем (все взгляды одинаково уважаются).
Вторая лекция была более формальная. Понравилось, что Майкл ввел строгое определение bias’а через статистику (через мат ожидание) и сказал, что большая часть статей этот термин используют неправильно, для обозначения какой-то математически нестрогой несправедливости (unfairness).
Разобрали на примере Movielens’а почему типичный рекомендательный датасет bias’нут и не репрезентативен относительно общей популяции:
* он отражает фидбек только тех пользователей, который пользуются самой платформой
* при этом сама платформа довольно специфична (на ней нельзя ничего посмотреть, только поставить рейтинг)
* когда в древние времена собирали соцдем пользователей, основная демография была — мужчины 20+ лет; то есть студенты, которых заставили проставлять рейтинги =)
* средний рейтинг фильмов на платформе — 3.6 - 3.7; он завышен. Мы не смотрим и не проставляем рейтинги тем фильмам, которые нам точно не понравятся. Если бы мы совсем случайно смотрели фильмы, тогда было бы корректней
Post #288
1.57K




- ❤ 10
- 🔥 6