
RecSys Summer School, часть 3.
1. Рассказ про лекцию по психологии давайте скипнем :)
2. Лекция по GNN была хорошая, но очень академическая. Ничего не было про web-scale, про то как работать с большими графами и тд. TLDR: графовые модели очень выразительны, задачу рекомендаций удобно моделировать в виде графа, с помощью графовой структуры легко учитывать коллаборативный сигнал, графовые свертки по сути представляют из себя фильтры низких частот (если рассматривать каждую вершину в графе как сигнал).
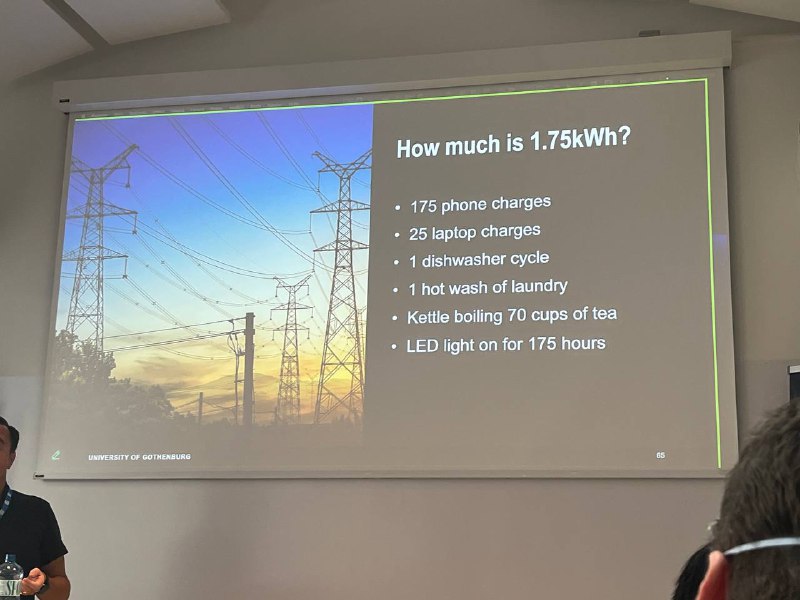
3. Также выступал один из авторов статьи про CO2 в рексистемах с прошлого рексиса, Alan Said. Привел пример, когда в статье предложили алгоритм, увеличивающий ndcg на 0.05, но при этом также увеличивающий потребление энергии на 1.75kWh (что равносильно одному запуску посудомойки). Предложил выключить дип лернинг в стриминге, но оставить в екоме. Сказал, что нужно запускать эксперименты в первую очередь в странах с renewable energy, и что в этом плане худшая страна для экспериментов — это Австралия (а хорошие — это Дания, Швеция). Про еком логика следующая: каждый возврат вещи — это большое количество логистики, много езды на машине. Привел пример, что в Австрии у Заландо 400к активных пользователей и миллион покупок в год, из которых 35% возвратов.
Также чуть-чуть упомянул fairness, что у всех пользователей и групп должен быть одинаковый доступ к “благам” рексистемы. Упомянул статью, в которой показали, что равенство для групп может приводить к неравенству для отдельных людей. Также говорил про то, что у fairness очень много разных определений, у научного сообщества нет консенсуса как его определять, и что это нормально.
4. Была хорошая лекция про генеративный рексис, но тоже довольно академическая. Мне точно пригодится, чтобы доделать собственную лекцию (в прошлом году я эту тему постарался покрыть в финальной лекции recsys курса, про тренды). В рамках лекции было два рассказчика, второй рассказывал что-то про агентов и стартапы. Был слайд с лабубу :) Упоминал “The society of mind” от Marvin Minsky в контексте мульти-агентности.
5. Kim Falk попиарил свою книжку Practical Recommender Systems и заодно побеседовал про специфику индустриальных рексистем. Лекция была довольно поверхностная (скорее очередная вступительная лекция) и при этом видно, что Ким не сильно много работал с дип лернингом в индустрии и скорее много занимался классическими алгоритмами.
Был кусочек про то, как правильно работать с датасетами: что датасеты нужно фиксировать, обновлять их пореже; только когда нужно что-то добавить. Что при обновлении датасета мы теряем валидность сравнения экспериментов. Но и что когда близится внедрение, датасет конечно же надо обновить.
Рассказал забавный пример про LLM — спрашивал у чатгпт рекомендации книжек по рексистемам, она выдала список, в котором не было его книги. После комментария про то, что его книга тоже хорошая, попросил рекомендации снова. И тогда LLM выдала список уже и с его книгой тоже =)
В общем и целом лекция скорее напоминала набор разрозненных не сильно связанных тезисов: в рексистемах никогда нет GT (истинных меток), клик на менее популярный айтем несет больше ценности, что персонализация — это по определению дискриминация, и тд.
6. Morten Arngren прочитал лекцию про A/B тестирование, в частности про Bayesian методы и про бандитов для A/B. В лекции не было recsys специфики (например, не проговаривалось что обычно деление на группы происходит по пользователям). Были довольно красивые визуализации, основанные на симуляциях, наглядно показывающие как меняются распределения оцениваемых величин с ростом размера выборки.
7. Лекцию про CRS (conversational recommender systems) от Li Chen лично мне было тяжело слушать :). Вообще, некоторые лекции были очень “энциклопедические” — происходило сухое безэмоциональное перечисление каких-то подходов, методов, их категоризаций. Часто не было единого нарратива через всю лекцию, глубоких инсайтов.
Символы кончились, продолжение следует :) Пишу для вас посты в поезде, пока еду из Вены в Прагу :)
Post #283
1.63K



- ❤ 25
- 😁 7