Qwen3.8-2.4T-A95B: открытые веса флагмана для сложных задач
👋 Qwen3.8-2.4T-A95B — текстовая MoE-модель для программирования, исследований и длительных агентных сценариев. Из 2,4 трлн параметров на каждом токене активируются около 95 млрд. Контекст составляет 262 144 токена с возможностью расширения до 1 млн.
Что важно:
▪️ Гибридное внимание
Архитектура чередует три слоя Gated DeltaNet с одним слоем Gated Attention. Такое сочетание линейного и полного внимания снижает требования к памяти для KV-кэша при работе с длинными текстами.
▪️ Планирование и выполнение задач
Главное развитие новой версии — усиление агентных возможностей. Модель ориентирована на многошаговую работу: планирование действий, анализ результатов и пересмотр решений с учетом обратной связи от инструментов и среды.
▪️ Управляемая глубина рассуждений
Параметр reasoning_effort задает глубину анализа, а preserve_thinking сохраняет историю рассуждений между сообщениями. Это помогает продолжать сложную задачу с учетом предыдущих этапов. Режим мышления остается обязательным даже при снижении глубины анализа.
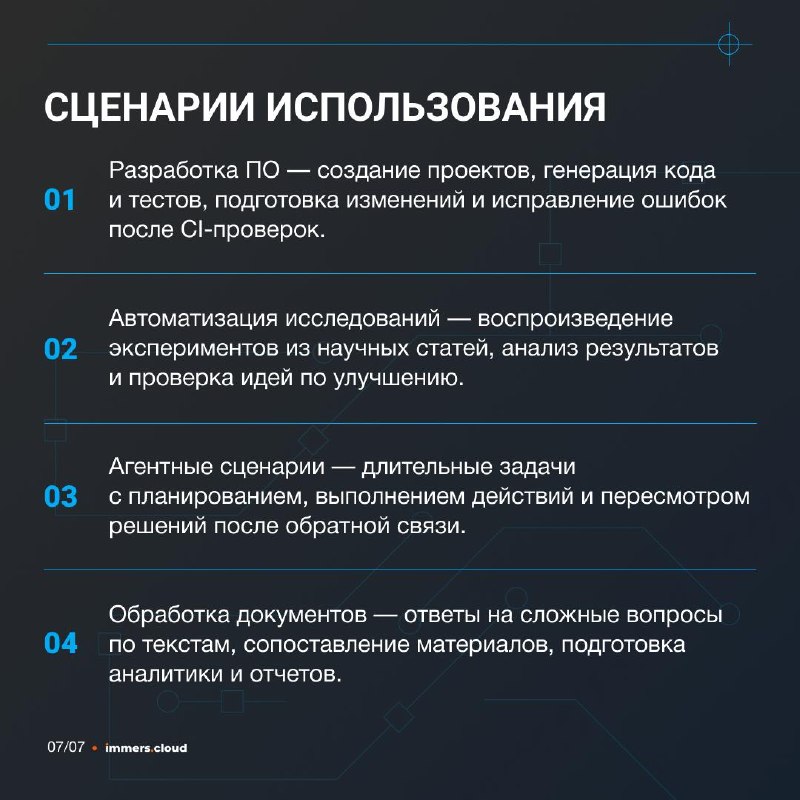
📲 Подробнее об архитектуре, настройках, бенчмарках и сценариях использования смотрите в слайдах.
💬 Для знакомства можно бесплатно попробовать Qwen3.8-Max в официальном чате Qwen.
Post #1430
109


- 👍 2
- 🔥 2
- ❤ 1
- ⚡ 1