



Мы все видели таких коллег 😎😎 — только что изучили горутины и сразу решили «распараллелить всё!» Особенно так любят делать новички:
«Оо, я недавно изучил пакет unsafe и concurrency, сейчас распараллелю вычисления в этом запросе и уберу лишние копии».
В лучшем случае код становится менее читаемым.
В худшем — станет медленнее 🫡🫡
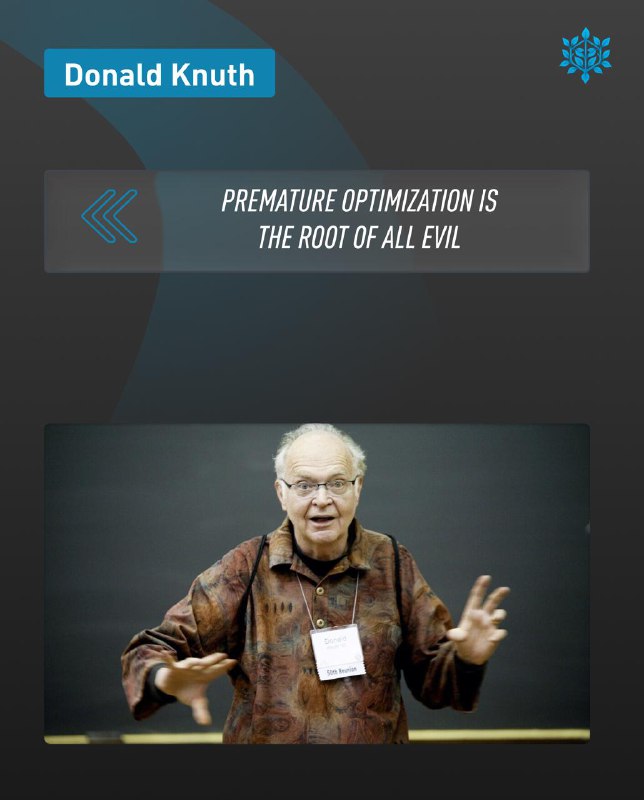
Как однажды сказал Дональд Кнут — один из отцов информатики:
«Преждевременная оптимизация — корень всех зол»
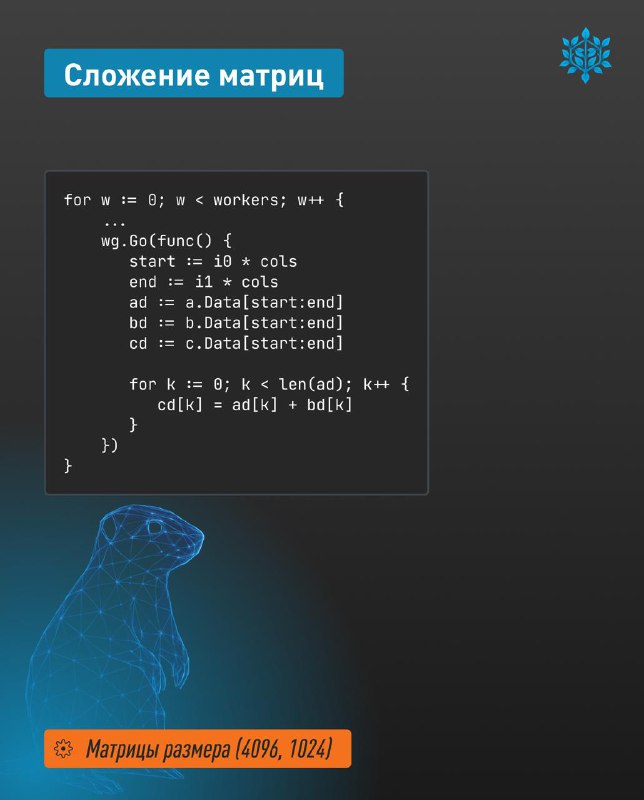
Особенно наглядно это работает для CPU-bound задач — например, сложение матриц, хэширование, кодирование. Интуитивно кажется, что «больше горутин = быстрее», но это ловушка.
Закон Амдала отлично иллюстрирует, насколько сложно получить ускорение в этом случае. Например, при 60% параллельного кода разницы между 100 и 1000 ядрами практически нет 💔. В задаче из поста выше ответ по формуле 5.263.
С точки зрения практики, всегда лучше сделать бенчмарк. Как видим, ответ почти сошёлся.
BenchmarkAdd/par/w=1-12        168
BenchmarkAdd/par/w=10-12       776
При этом важно понимать, что с IO-bound задачами всё иначе — там другие принципы и прирост может быть на порядки выше.
Кстати, как раз сегодня на канале вышло видео про устройство атомиков и распараллеливание CPU-bound задач.
Если же хочется разобраться в этих принципах глубже, 25 ноября стартует 2 поток курса The Nature of Concurrency. Это системное погружение в базу многопоточности: от устройства атомиков, мьютексов до модели памяти, устройства race detector'a и lock-free алгоритмов.
Курс закрывает 100% вопросов про Concurrency на собеседованиях, видеоотзывы можно посмотреть на сайте. В честь распродажи 11.11 до конца недели действует скидка на PREMIUM тариф, на нём есть возможность поработать со мной 1 на 1, осталось всего 2 места.