bf16 для DFlash: где matmul живёт, а softmax — нетDFlash — block-diffusion draft: параллельно предсказывает блоки по 16 токенов, внимание через FlexAttention, loss — cross-entropy по огромному словарю.Веса в bf16 — нормально. Проблема в другом: на каждом шаге DFlash делает
два тяжёлых редукшена (softmax-подобных), и bf16 там систематически теряет точность.
> Экспонента с мантисой вышли покурить.
> Вернулись — а softmax уже другой.
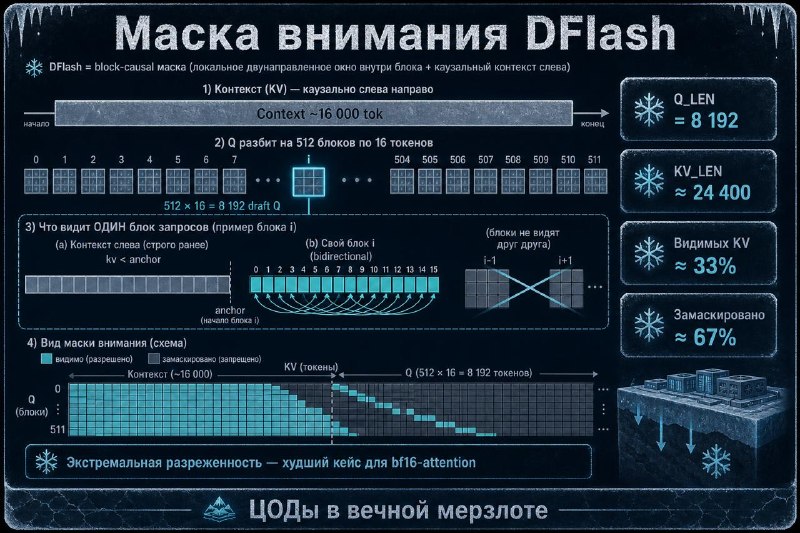
1. FlexAttention + разреженная block-causal маска512 draft-блоков. Каждый видит только:
— контекст до своего anchor (~половина последовательности)
— 16 своих draft-токенов
Остальное в маске. Видимых KV-позиций ~30–35% — экстремальная разреженность.
Softmax в Flash/FlexAttention считается
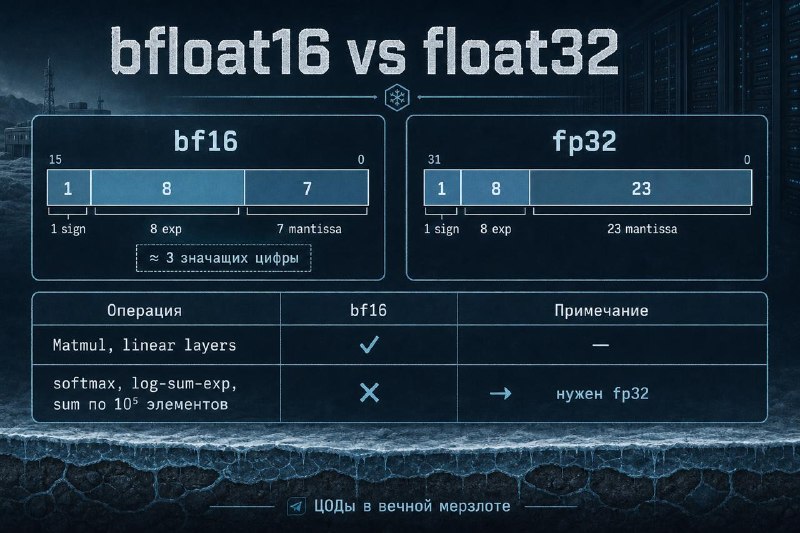
онлайн: бежит max m, сумма l, перескалировка через exp(m_old − m_new). В bf16 (7 бит мантиссы ≈ 3 десятичных цифры) эти перескалировки округляются. Чем агрессивнее маска — тем меньше «коррекций» и тем сильнее дрейф.
> Маска выкинула 67% KV.
> Ядро сделало меньше перескалировок.
> bf16 округлил — и attention уже не тот.
PyTorch upstream ([#163588](
https://github.com/pytorch/pytorch/issues/163588)): bf16 + маска → до нескольких % ошибки; fp32 → <0.001%.
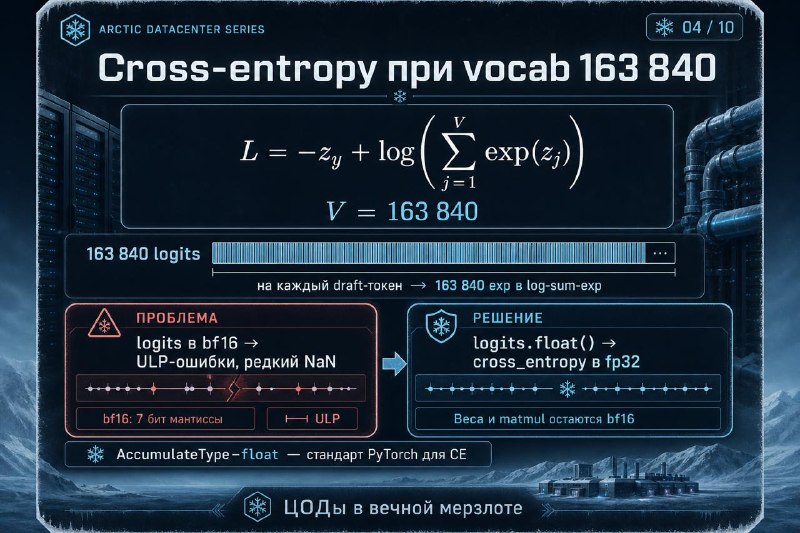
2. Cross-entropy по словарю ~164kCE = −z_y + log Σ exp(z_j) — log-sum-exp по
163 840 logits на каждый draft-токен.
Суммировать 164k экспонент в bf16 — прямой путь к ULP-ошибкам и редким NaN. PyTorch для log_softmax/CE давно аккумулирует в float — не из прихоти.
> 164 тысячи exp на один токен.
> Мантисса на семь бит.
> Кто-то из них обязан потеряться — вопрос только, когда это станет NaN.
Что делаемНе «переходим на fp32-тренинг». Точечно:
→ FlexAttention: q, k, v в fp32, output cast обратно в bf16
→ CE: logits.float() перед cross_entropy
Matmul и веса — bf16. Редукции — fp32. Стандартный приём для LLM; RMSNorm в DFlash уже так работает.
> fp32 не на всё — fp32 только там, где exp, max и sum решают судьбу градиента.
МоральКогда тренируешь draft с block-sparse attention и большим словарём — смотри не на distributed, а на
редукции. Экспонента тут не декорация: softmax и CE буквально живут на exp, max и sum.
DFlash собирает оба болевых места в одном forward. fp32 на этих двух участках — не перебор, а минимально необходимая страховка.
Кто найдет ошибки — тот молодец. Ему за это ничего не будет