TGViewer
Channel Public Channel
IASAedu 🇺🇦

IASAedu 🇺🇦

@iasa_edu

Освітній проєкт для початківців у ІТ від @IASA_Student_Council
Зворотний зв'язок: @IASAsuggestionBot
Проблеми з навчанням: @iasa_stud_support_bot

#Edu_recommends
#Edu_professions
#Edu_preparation
#Edu_quiz
#Edu_Academic
#Edu_internship
#IASA_stars
Subscribers
1K
Photos
19
Videos
0
Links
592
Recent Posts 20 shown
Post #1204 201
  • 🆒 4
  • 👎 2
Post #1203 201
#Edu_quiz Python
import itertools

nums = [1, 2, 3, 4, 5]
acc = list(itertools.accumulate(nums))
print(acc[-1:1:-2])
Post #1202 278
Junior Data Engineer interview: ETL/ELT
#Edu_preparation

У чому різниця між підходами ETL та ELT в інженерії даних?

ETL (Extract, Transform, Load) та ELT (Extract, Load, Transform) — це два класичні підходи до інтеграції та переміщення даних з різних джерел до єдиного сховища. Головна відмінність між ними полягає у порядку виконання операцій: а саме в тому, де і коли відбувається етап трансформації (перетворення) даних.

Основні відмінності та сфери застосування цих підходів:

• Місце трансформації (Processing Location):
У класичному ETL-пайплайні дані витягуються з джерела і трансформуються на окремому проміжному сервері обробки перед тим, як потрапити до фінального сховища. В ELT "сирі" дані завантажуються безпосередньо в цільову систему, а трансформація відбувається вже всередині неї з використанням обчислювальних потужностей самого сховища.

• Типи даних та сумісність (Data Types & Storage):
ETL найкраще підходить для традиційних реляційних баз та сховищ (Data Warehouses), оскільки він оперує переважно структурованою інформацією. Зі свого боку, гнучкий підхід ELT дозволяє завантажувати й обробляти величезні масиви як структурованих, так і неструктурованих даних, що робить його ідеальним вибором для сучасних хмарних екосистем (наприклад, Snowflake, BigQuery) та Data Lakes.

• Швидкість та гнучкість (Speed & Time to Value):
Процес ETL може бути повільнішим через те, що трансформація є "вузьким місцем" до завантаження, і структура даних має бути чітко спланована заздалегідь. В ELT необроблені дані миттєво завантажуються у сховище, що дозволяє аналітикам одразу мати до них доступ і формувати логіку перетворень за запитом, значно прискорюючи отримання бізнес-результатів.

• Безпека та комплаєнс (Privacy & Compliance):
Якщо компанія працює з конфіденційною інформацією (наприклад, PII), ETL забезпечує кращий контроль. Він дозволяє очистити, замаскувати або видалити чутливі дані ще до їх потрапляння у фінальне сховище. В ELT уся "сира" інформація відразу потрапляє до бази, що вимагає суворіших політик безпеки всередині самого цільового середовища.

• Інструменти та екосистема (Tools & Skillset):
ETL — це зріла технологія, для якої часто потрібні інженери з сильними навичками програмування (наприклад, Python або Spark) та специфічні зовнішні інструменти. ELT-підхід став стандартом завдяки сучасним інструментам на кшталт dbt, які дозволяють виконувати всю трансформацію за допомогою звичного SQL, що ідеально підходить для команд із сильною SQL-експертизою.
  • ❤ 3
Post #1201 383
Mature optimization
#Edu_recommends

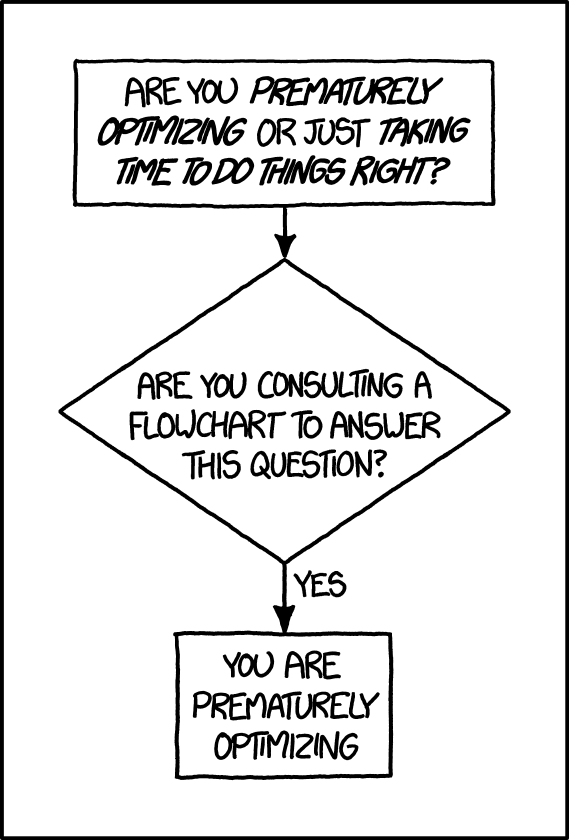
Що уявляє середній ММСАшник, коли чує слово «оптимізація»? Мабуть задачу лінійного програмування і підтягує в кеш формулу для Δ з симплекс-методу? Ми не перевіряли! Як і те, чи подумає СПшник про «root of all evil». Та якщо аби вберегти ментальне здоров'я від першого, досить «посміхнутись і заварити собі чаю», то з другим все складніше. Тримай дві протилежні думки, щодо того, як запобігати premature optimization, яка «is the root of all evil»:
• Оптимізувати до вимірів.
• Вимірювати до оптимізації.
  • ❤ 2
Post #1200 396
Спринт (sprint)
#Edu_ITvocab

Що каже гугл?
Спринт — це короткий, фіксований період часу, зазвичай від 1 до 4 тижнів, протягом якого команда розробників працює над виконанням певного набору завдань.

Складно? Пояснюємо простіше
Наприклад, ти розробляєш програмне забезпечення і маєш на це 4 тижні: щоб не хапатися за все одразу, ти щотижня береш одну конкретну функцію і реалізуєш її повністю «під ключ» — від кнопки в інтерфейсі до робочої логіки всередині, щоб наприкінці кожного тижня мати закінчену версію програми, яку вже можна реально запустити й протестувати.

Кілька прикладів використання
• «Перед фінальним релізом команда запустила короткий однотижневий спринт, присвячений виключно виправленню багів та оптимізації коду».
• «На плануванні нового спринту команда вирішила взяти в роботу лише чотири критичні задачі, щоб уникнути перевантаження».

Бажаєш дізнатися більше? Читай про спринт тут.
  • 🔥 5
Post #1199 463
  • 😁 4
  • 👍 2
  • 👎 1
Post #1198 433
#Edu_quiz OOP
Post #1197 512
Junior Data Engineer interview: Change Data Capture (CDC)
#Edu_preparation

Що такe Change Data Capture (CDC) і як цей патерн використовується в інженерії даних?

CDC (Change Data Capture) — патерн, який у реальному часі фіксує та передає зміни в даних (INSERT, UPDATE, DELETE). Замість періодичного копіювання всього масиву (batch processing), CDC миттєво обробляє лише змінені записи, забезпечуючи високу швидкість та актуальність інформації.

Використання CDC в інженерії даних базується на таких підходах та перевагах:

• Робота на основі логів (Log-based CDC):
Це найпопулярніший і найефективніший метод. Інструменти (наприклад, Debezium) безпосередньо читають транзакційні логи бази даних (WAL у PostgreSQL або Binlog у MySQL). Це дозволяє захоплювати події без виконання SQL-запитів і майже не створює додаткового навантаження на production-базу.

• Синхронізація у реальному часі (Real-time Data Replication):
CDC забезпечує постійну та швидку реплікацію даних з операційних баз (OLTP) до аналітичних сховищ (Data Warehouse або Data Lake). Це гарантує, що бізнес-аналітики та BI-інструменти працюють із найактуальнішою інформацією без затримок, характерних для нічних ETL-завантажень.

• Подієво-орієнтована архітектура (Event-Driven Architecture):
Кожна зміна в базі даних перетворюється на стрімінгову подію (event), яка відправляється до брокера повідомлень, найчастіше Apache Kafka. Це дозволяє десяткам незалежних мікросервісів та пайплайнів паралельно підписуватися на ці зміни та миттєво на них реагувати.

• Повний аудит та збереження історії (Audit & Historical Tracking):
CDC фіксує не лише фінальний стан запису, але й зберігає контекст транзакції: тип операції, старе значення, нове значення та час. Це ідеально підходить для наповнення таблиць фактів та реалізації Slowly Changing Dimensions (SCD) для відстеження еволюції даних у часі.

• Відмова від ресурсоємних опитувань (Eliminating Polling):
Традиційний підхід вимагає регулярних запитів до бази за міткою часу. CDC повністю усуває необхідність такого "опитування", оскільки зміни надсилаються автоматично (push-модель), що кардинально знижує навантаження на джерело.
  • ❤ 4
  • 👍 1
Post #1196 510
Суцільна невизначеність
#Edu_recommends

Топ 3 факти, щоб розповісти одногрупникам на фреші:
1. Гай Марій був обраний консулом 7 разів.
2. Якби Карфаген не передав частину своїх військових кораблів торговому флоту, він виграв би Першу Пунічну війну.
3. Нескінченні цикли без сторонніх ефектів — це невизначена поведінка в C++.

Та візьми до уваги: третій пункт скоро застаріє — в новому стандарті C++26 поведінка визначена, скажуть що баян. Крім того, може змінитись поведінка компіляторів і в попередніх стандартах, так як це оновлення можна запроваджувати ретроспективно. Але 2-3 роки це ще буде актуально.
Що ж змінилось, читай в короткому огляді або в оригінальній пропозиції.

Став вподобайку, якщо писав такий цикл на першому курсі
  • ❤ 9
  • 👎 1
  • 🔥 1
Post #1195 483
MVP (Minimum Viable Product)
#Edu_ITvocab

Що каже гугл?
MVP або мінімально життєздатний продукт — це тестова версія програми, сервісу чи продукту з мінімальним, але достатнім набором функцій, яка несе цінність для клієнта. Створюється для перевірки бізнес-гіпотез та збору зворотного зв'язку від перших користувачів із найменшими витратами ресурсів.

Складно? Пояснюємо простіше
Створення застосунку чи сервісу з нуля є дуже ресурсозатратним процесом для розробників. Розробляти відразу повноцінний продукт — не найкраща стратегія, оскільки є ризик, що користувачам він не сподобається. Для цього існує MVP. Компанії спочатку розробляють тестовий проєкт, що містить основні фічі, необхідні клієнту. Він оцінює його, надає відгук, а розробники за необхідності удосконалюють продукт. Такий підхід не вимагає завеликих витрат і підвищує шанси вийти на ринок.

Кілька прикладів використання
• «Команда вирішила спочатку випустити MVP, щоб перевірити ідею перед повноцінним запуском».
• «Давайте не будемо зараз прикручувати сюди складну систему авторизації, для MVP вистачить простого входу через Google».

Бажаєш зрозуміти, як будувати MVP крок за кроком? Читай гайд тут.
  • ❤ 3
  • 🔥 3
Post #1193 535
#Edu_quiz Machine Learning
Post #1192 647
Junior Data Engineer job description
#Edu_professions

У нашому нещодавньому опитуванні беззаперечним лідером став напрямок Data Engineering, зібравши 61% ваших голосів. Тому сьогодні детально розбираємо особливості цієї професії.

Data Engineer (Інженер даних) — це фахівець, який виступає архітектором та будівельником інфраструктури даних. Без його роботи неможлива ефективна діяльність Data Scientist'ів, аналітиків чи ML-інженерів, адже саме він відповідає за те, щоб розрізнені, «сирі» масиви інформації перетворювалися на надійний і чистий актив. По суті, дата-інженер створює та підтримує системи автоматизованих пайплайнів, якими дані безпечно та швидко переміщуються від джерела до кінцевого сховища.

Для старту в професії ключовими є впевнене знання SQL, розуміння архітектури баз даних та володіння мовою програмування (найчастіше Python або Scala). Крім того, необхідно знати принципи побудови Data Warehouses (сховищ даних) і мати базові навички взаємодії з хмарними екосистемами (AWS, GCP, Azure).

Основні завдання на цій позиції:
• Проєктування, розробка та підтримка ETL/ELT-конвеєрів для вилучення, трансформації та завантаження даних.
• Налаштування інструментів оркестрації (наприклад, Apache Airflow) для контролю та автоматичного запуску процесів за розкладом.
• Оптимізація складних SQL-запитів та взаємодія з різними типами баз даних.
• Моніторинг якості даних (Data Quality), виявлення дублікатів, аномалій та запобігання втратам інформації.
• Робота з інструментами екосистеми Big Data (наприклад, Apache Spark, Kafka) для надійної обробки великих обсягів інформації.

Медіанна заробітна плата для Junior-рівня на українському ринку становить близько $1000, тоді як у Європі цей показник знаходиться на рівні ~3500€.
  • 👍 4
  • 🆒 2
  • 🤯 1
Post #1191 664
Чому ревуть воли, як запускаються програми?
#Edu_recommends

Підписнику, чи усвідомлюєш ти те, скільки роботи відбувається, коли ти просиш корову сказати му? Якщо ні — читай статтю (відносно) простою мовою про те, як процесор і операційна система передають їй твоє прохання.
  • 🤩 6
Post #1190 668
Бенчмарк (Benchmark)
#Edu_ITvocab

Що каже гугл?
Бенчмарк — це контрольне завдання, необхідне для визначення порівняльних характеристик продуктивності комп'ютерної системи.

Складно? Пояснюємо простіше
Наприклад, твій алгоритм знаходить число у відсортованому масиві за 0.1 секунди, для 10 елементів це повільно, а для мільйона — швидко. Щоб оцінити його реальну ефективність, проводять бенчмарк: на одному й тому ж тестовому масиві й процесорі порівнюють твій код із еталонним бінарним пошуком. Лише таке зіставлення в однакових умовах показує, наскільки розв'язок насправді швидкий.

Кілька прикладів використання
«Модель покращила показники на 80% на цьому бенчмарку.»
«Ми переписали модуль серіалізації; бенчмарк показав падіння затримки з 45 мкс до 12 мкс на запит.»

Зацікавило? Читай про бенчмарк тут.
  • ❤ 4
  • 🔥 2
  • 🤔 1
Post #1188 672
#Edu_quiz Discrete Mathematics
Post #1186 787
Музика
#Edu_recommends

Шо ти, підписнику? Сесія ще далеко, саме час згадати музичну школу. До твоєї уваги стаття «Music theory for programmers» — інтерактивний гайд по музичній теорії, без заглиблення в деталі.
  • ❤ 6
  • 👍 2
Post #1185 813
Рефакторинг (refactoring)
#Edu_ITvocab

Що каже гугл?
Процес зміни внутрішньої структури програмного коду без зміни його зовнішньої поведінки та додавання нової функціональності, спрямований на покращення читабельності, зниження складності та полегшення підтримки системи.

Складно? Пояснюємо простіше
Уяви собі, що ти працюєш з іншими програмістами чи Claude Code. Щоб у команді не виникало непорозумінь щодо коду, важливо покращувати його та робити чистішим. Головні правила рефакторингу: не додаємо нової функціональності, очищуємо від дублювань чи надто довгих функцій та робимо код очевидним для інших. Фінальним етапом є його успішне (чи не дуже) проходження автотестів.

Кілька прикладів використання
• «Цей код працює, але перед тим як додавати нові фічі, нам потрібен жорсткий рефакторинг».
• «Я вчора пів ночі рефакторив той модуль, тепер хоч не страшно тімліду показати».

Бажаєш дізнатися більше? Читай про рефакторинг тут.
  • 🔥 7
  • ❤ 1
  • 🤡 1
Older posts →

About this channel

How can I read @iasa_edu without a Telegram account?
TGViewer shows the public web preview Telegram publishes for IASAedu 🇺🇦: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does IASAedu 🇺🇦 have?
IASAedu 🇺🇦 (@iasa_edu) has 1K subscribers on Telegram, refreshed roughly every 30 minutes.
Does IASAedu 🇺🇦 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →