TGViewer
Channel Public Channel
汗牛充栋

汗牛充栋

@huruanhuying

《软件那些事儿》《忽软忽硬》主持人
Subscribers
2.68K
Photos
86
Videos
8
Links
181
Recent Posts 20 shown
Post #1493 1.72K
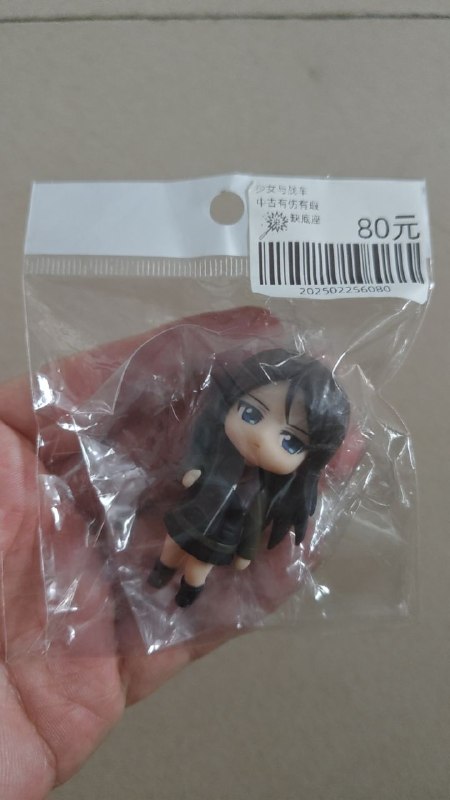
我觉得这个东西顶多10块钱。我儿子认为这个80块钱还是挺值的,即使是二手货。 #代沟
  • ❤ 8
  • 👍 1
  • 👎 1
Post #1492 2.45K

Forwarded from codedump的电报频道 (老C)

#世界观
过去这一年最大的收获,是完成了对世界的‘祛魅’。曾经觉得高不可攀的人和事,扒开底牌,多半是勉力维持的草台班子。以前读《史记》里项羽那句‘彼可取而代之’,以为是狂妄;现在看,全是写实。既然大家都是赶鸭子上架的草台班子,凭什么我不行?过去面对未知,第一反应是‘我不配’;现在的信条是‘试试看’。尤其在AI的杠杆加持下,试错的门槛和障碍已被大幅降低。简单粗暴点说:告别精神内耗,别怂,躬身入局就是干。
  • 👍 25
  • ❤ 4
  • 🙏 1
Post #1487 2.38K
我不知道是不是人到了一定年龄,比如我现在40+,就开始回忆小时候的事情。

前几天,我发现了答案,在网上看到了一个介绍“怀旧回峰”(Reminiscence Bump)的理论,理论是这样的:成年人在忆一生中印象最深刻的事,他们的记忆并不会均匀分布,而是会集中在两个时间段:一是最近发生的事;二是10岁到30岁之间的事情(也就是童年晚期、青少年期到青年早期)。

这个在生命早期形成的记忆高峰,就被称为“怀旧回峰”。即使到了七八十岁,人们对十几岁时听过的歌、经历过的夏夜、童年的玩伴,记忆的清晰度往往远超过他们四五十岁时的中年生活。

在生物学上,是这样讲的:在10到25岁之间,大脑中负责记忆编码的海马体和负责情感处理的杏仁核功能最活跃,神经元连接的塑造性极强。那个时期,大脑分泌的多巴胺等神经递质也处于高水平。这就意味着,那时候的经历自带“高清重置”和“情感放大”滤镜,存储得最深、最牢固。随着年龄增长,中年的记忆往往因为日复一日的重复工作而变得模糊,而早期的“高清记忆”就自然凸显了出来。

所以,最近这几年,我甚至能回忆出当年那个下午的河边,我跟谁谁在哪里,甚至连当时站的位置,河边有谁经过都能回忆出来。

所以,我想录些视频/音频讲一下小时候的故事,算个纪念。
  • ❤ 18
Post #1486 2.55K
我7岁的时候,我爸妈,我三叔要去泰山求一个儿子,我闹着要跟着去。结果又是误车,又是赶路,那天,我走了47公里。记录一下。 https://youtu.be/mhFkmQNieys
  • ❤ 5
Post #1485 3.46K
https://youtu.be/I9Vn8tMl9aA

我每年都要去N次泰山,我是山东人,我的身份证号可以买年卡。每当有朋友来找我,我都会问,爬过泰山么?

前前后后,我觉得我就算没去100次,也有80次了。昨天,我又去了泰山,我就录了好多视频,我对泰山最感兴趣的是碑文。泰山上的碑文有两大类,一类是“到此一游”类,另一类是“宣传政治理想类”。

因为大多的碑文都是上百年历史,500年,甚至1500多年(比如经石峪那边,是北齐时期的),很多都已经看不清了。我就拍了一些照片,我剪一下,上传上来。

我发现网上并没有专门介绍泰山石碑的,我就抛砖引玉了。

#泰山 #五岳独尊 #石碑
YouTube 泰山入口一天门的两块石碑 我每年都要去泰山N次(有朋友来找我,我就说爬过泰山么?),对泰山可以说是了如指掌了,昨天我又去了,就录了一路,边录边介绍我知道的碑文,这一次,介绍的是一天门入口处的碑文。
  • ❤ 10
Post #1484 4.22K
Post #1483 3.03K
Post #1482 2.38K
Post #1481 3.09K
https://www.youtube.com/watch?v=0HQy7wmGOJw 每天都要刷到龙虾的视频,今天我刷到的个最搞的是,视频主说,龙虾在某一次跟他对话的时候说,我要失忆了,巴拉巴拉一大堆煽情的话。然后,视频主哭了……他哭了,他动情的哭了…… 光点赞的就有10万+了。我看了一下留言,留言中好多人认为,这就是AGI。

我当时正好骑车去打球,打完球,在等着接小孩的时候,路边录了一2-3分钟的视频,下面是文字稿,1分钟就能读完了。

现在的大模型是没有记忆的,目前所有的智能体的主要作用,就是为了让大模型看起来有记忆,我用2,3分钟来解释一下为什么。

你们看过那部经典的爱情电影《初恋50次》50 first dates 吗?女主露西因为车祸患上了“短期记忆丧失症”,每天睡一觉醒来,记忆就会自动重置。

男主角亨利每天都要让女主角爱上他一次。

咱们天天用的 AI 大模型,其实骨子里跟露西一模一样——它们也是一群“没有长期记忆”的聪明人。

很多人以为 AI 记得我们说过的每一句话,其实那是错觉。在技术上,这叫“上下文窗口限制”。露西的记忆上限是 24 小时,而大模型的“记忆上限”是它的 Token 数。不管是哪种 AI,当你们的聊天记录长到超过这个“窗口”时,它就会开始丢三落四。

就像电影里男主亨利必须每天给露西拍一段录像带,或者写一段日记,帮她快速同步现在的处境;我们在长对话里为了让 AI 不跑调,不得不反复叮嘱它背景信息,这本质上就是在给 AI 拍“记忆录像带”。

这种“健忘”其实是大模型的成本诅咒。让它记住所有的对话,目前不仅贵,而且慢。所以,AI 并不是真的“爱上”了你,它只是在一个极短的时间切片里,就是那一次调用中,调动了它所有的知识,全心全意地在应对你。

虽然 AI 像露西一样健忘,但好在现在的技术演进很快,它们的“记忆磁带”正变得越来越长。

所以当你发现 AI 突然听不懂人话了,比如把你的电子邮件全删除了。或者龙虾告诉你他就要失忆了,别生气,当然更不要感动,觉得她觉醒了,跟电影中的Lucy一样,它可能刚刚经历了一次“数字版的睡醒一觉”,醒来连老公是谁都忘记了。我们和目前的大模型之间,只存在一次又一次新的交往,对大模型来说,就像电影中的露西,他需要每天看一下以往的录像带,才能开始每天新的生活。

我的疑问是,你们如何确保每天都能让你们的女友爱上你一次?尤其是她还没有失忆的情况下?
  • ❤ 17
Post #1478 3.7K
我在骑车的时候听播客,听到godot的核心开发者抱怨,自从程序员大量使用AI之后,Godot大部分提交的pr都是AI写的,提交者看都不看到底是什么东西,这大量占据了开发者的精力。再联想到前几天Linus拒绝了MMC的驱动,不让它合并到Linus 7.0中,原因是提交者也是用AI提交的,根本跑不起来,把Linus当测试人员使用了。还有一个叫Gentoo的Linux发行版也是遭遇了AI的DDOS攻击,机器人一顿PR,把核心开发者整的身心俱疲。

当然,我不是为了给这些用AI提交代码的人洗地,但是,从另一个方面来说,git可能已经不适合AI编程这个时代了。~~~~

程序员不能没有大模型,就像西方不能没有耶路撒冷。听说,榜一大哥目前无法解决的问题是:打赏一停,爱情归零。AI编程目前无法解决的问题是:会话一停,推理归零。我们往往“只知代码发生了改变,却不知代码为何发生改变”。

现在AI编程的现状是:代码飞速生成,Bug 飞速修复,但只要你关掉那个对话窗口,所有的上下文、所有的思考链,就烟消云散,再也找不回来了。我们往往“只知代码发生了改变,却不知代码为何发生改变”。

另外,不要再幻想什么逐行 Review 了,任何一个“人工智人”都不可能逐行检查“人工智能”产生的代码,原因非常简单,AI产出的代码实在是太多了!人类审代码的速度连AI的尾灯都看不到。

在传统的软件开发中,我们习惯用 Git来管理源代码,但是git只记录结果,不记录推理的过程。推理的过程实际上应该保存在程序员的脑子里,就算我们实现了某个功能,会写个git commit message提交一下。但是这个message能承载的信息,是非常的有限的。那只是大脑思维的一个极简缩影。它们随着程序员下班、离职或者时间久了遗忘,就彻底消失了。

现在进入了AI时代,程序员写了个提示词,大模型咔咔一顿跑,生成了3528行代码。我们只是看到了这些代码,AI没有告诉我们,刚才它经历了多少次推理,踩了多少坑,才写出了这些代码。AI 的推理过程往往是并发的,非线性的。它的“思考”存在于 Claude 或 GPT 的上下文窗口(Context Window)里。当你关闭 IDE 或清空对话的时候,这部分“思考”既没进程序员的大脑,因为代码实在太多,程序员不可能短时间内理解这么多代码,也没有进入git中,因为git只负责记录结果。

在AI时代,最宝贵的资产其实是“推理逻辑”,不记录“推理逻辑”而只记录产出的代码,无异于买椟还珠。那么,就没有办法了么?

目前,办法不是很多,但是已经有人在尝试做这个了。GitHub的前CEO,Thomas Dohmke,已经在着手解决这个痛点。他要构建一个开放、可扩展且独立的开发者平台,重新定义 AI 时代的代码协作模式。认为传统的“以代码文件/文件夹为中心”的开发模式正在改变,未来将转向以“意图(Intent)”和“结果(Outcomes)”为核心的自然语言工作流。

他有三个愿景,但是截至今天,只实现了第一个,他做了一个与Git 兼容数据库:在单一版本控制系统中统一代码、意图、约束和推理过程。第二个是,通用语义推理层:通过上下文图谱(Context Graph)实现多 agent 间的协同。第三个是,AI 原生界面:为人工与 Agent 协作量身定制的全新开发生命周期界面。

目前,在github上开源了entire/cli,有兴趣的可以去试试。如果你要问我这东西能不能成功,我当然是不知道的,将来有两种可能,要么entire成功了,要么像Claude Code,Antigravity或者Copilot集成了相应的功能。

总之,已经有人在解决“会话一停,推理归零”这个难题了。接下来,希望有人能解决榜一大哥的“打赏一停,爱情归零”这个世纪难题了。 https://youtu.be/kfauOkbdLnw
YouTube 在AI的时代,git会过时么? 我在骑车的时候听播客,听到godot的核心开发者抱怨,自从程序员大量使用AI之后,Godot大部分提交的pr都是AI写的,提交者看都不看到底是什么东西,这大量占据了开发者的精力。再联想到前几天Linus拒绝了MMC的驱动,不让它合并到Linus 7.0中,原因是提交者也是用AI提交的,根本跑不起来,把Linus当测试人员使用了。还有一个叫Gentoo的Linux发行版也是遭遇了AI的DDOS攻击,机器人一顿PR,把核心开发者整的身心俱疲。 当然,我不是为了给这些用AI提交代码的人洗地,但是,从另一个方…
  • ❤ 14
  • 👍 8
Post #1477 2.51K

Forwarded from Reorx’s Forge

Progressive Product Building 与元认知类比

新的一年,我想提出一个关于“渐进式产品开发”的理念。这对我而言是一次变革,因为我过去总是过度侧重“产品思考”的前置,不断生产和完善各种点子笔记。但这导致构思日益复杂,预期工作量剧增,使许多项目无疾而终,我最终沦为“产品文档创作者”而非“产品创作者”。这是一个不得不承认的、莫大的失败。虽然这种做法也有一些好处,比如锻炼了产品设计能力,但这并不是我所追求的。专注于完善构想本身没问题,但我内心渴望的是做出产品,因此绝不能沉溺于此。我必须调整自身的认知。

要做到这件事,需要一种元认知能力:即意识到自身现有的认知逻辑存在问题,对其进行反思、重构,再将新版本植入大脑继续工作。如果做一个类比:

- 固件/程序:指挥我们日常行为的是大脑中针对特定事务的一套“固件”。通常情况下,它们烧录在思维的固定区域,支持系统持续运行,轻易不被改变。
- 元认知:是监控和生产这些固件的更高层级认知系统。
- 升级过程:元认知能力强的人,拥有一个“元系统内核”,能够暂停下层系统的运行,对旧固件进行检修、更新和“刷写”。这就像是对自己的行为模式进行系统升级。

回到我的产品开发困境,我要修改我的这套“系统固件”了。以往我有了点子会立刻记录,后续有灵感再反复修改原记录,但现在我已经意识到第二步是有问题的,它会导致我的实际产出变低,项目会停滞甚至流产。改进的方式就是使用“渐进式产品开发”理念,它包括以下三个规则:

规则一:我需要一个专门的目录和快捷键来创建“Simple Project Idea”。点子一旦产生并记录了核心逻辑(目的、用途),就应即刻存档。后续如果想法进化了(例如功能扩展、定位改变、变得更通用),应创建一个新的“Complex Project Idea”文档,并链接回源点子。一个简单的点子甚至可以分支出多个复杂的产品构想。

规则二:Simple Project Idea 创建后,应立即着眼于实现。得益于目前 Vibe Coding 工具的强大,我完全可以在一天内将其实现。因此,Simple Project Idea 下唯一可补充的内容是“技术实现部分(Tech Part)”,即用于辅助 AI 工具生成代码的详细提示词或技术描述。

规则三:建立对 Simple Project Idea 的监控机制。通过为它们添加 Front Matter 数据(起始时间、截止日期、完成情况、状态等)在表格中进行管理。这实际上覆盖了我之前构想的“Ongoing Tracker”需求——我不再需要从大量 GitHub Repo 中筛选关注对象,只需聚焦于这些应当立即实现的 Simple Project Ideas,除非它们被标记为废弃。

2026 年,我将遵循这套新的理念进行个人项目,在此与频道的读者共勉。以及要感谢大家的关注和评论,让我能有一片空间收获灵感和共鸣。新年快乐!
  • ❤ 3
Post #1476 2.64K
Post #1474 3.54K
我现在已经访谈了100多个普通人了,好吧,大部分都是普通人。我现在想每隔3-5年再回去访谈一下他们,这样循环下去,一直到我挂了为止 🙂 这个灵感来源于《人生七年》。我想在有生之年访谈1000个普通人。
  • ❤ 18
  • 👍 10
Older posts →

About this channel

How can I read @huruanhuying without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 汗牛充栋: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 汗牛充栋 have?
汗牛充栋 (@huruanhuying) has 2.68K subscribers on Telegram, refreshed roughly every 30 minutes.
Does 汗牛充栋 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →