
Как создаются картинки из текста🤔
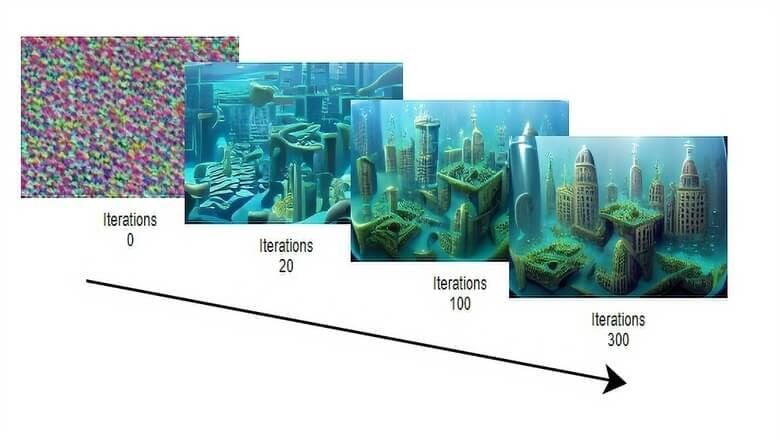
Когда мы пишем Midjourney или Stable Diffusion текстовый запрос, то через несколько секунд получаем картину, которой раньше не существовало. Выглядит, будто нейросеть где-то нашла подходящее изображение и подправила его. НО на самом деле картинка создается из чистого «визуального шума».
Чтобы понять, как это работает — надо посмотреть, как модель учится:
• Ей дают миллионы фотографий и медленно портят: подсыпают случайный шум.
• Затем заставляют делать наоборот — по «шумной» картинке угадывать, как она выглядела на шаг раньше.
• За много-много повторов сеть учится одному универсальному умению: смотреть на мешанину пикселей и понимать, какой шум надо убрать.
Теперь сама генерация. Модели дают набор помех — абсолютно случайные пиксели — и просят постепенно их «очищать». С каждым повтором из хаоса всё чётче проступают формы.
А как текст перевести в шум? Промт отдельная нейросеть переводит в набор чисел. Эти числа подмешивают в модель, и они работают как компас: на каждом шаге сеть убирает шум сторону промта.
Поэтому качество зависит от того:
1) насколько точно ваш текст лёг в эти «смысловые координаты».
2) сколько шагов очистки было у модели.
Меньше шагов — быстрее, но грязнее; больше — дольше, зато чище. Та же логика сегодня двигает и генерацию видео вроде Sora.
@HotCodeIT
Post #3326
4.75K
- 👍 9
- ❤🔥 4
- 🔥 2