
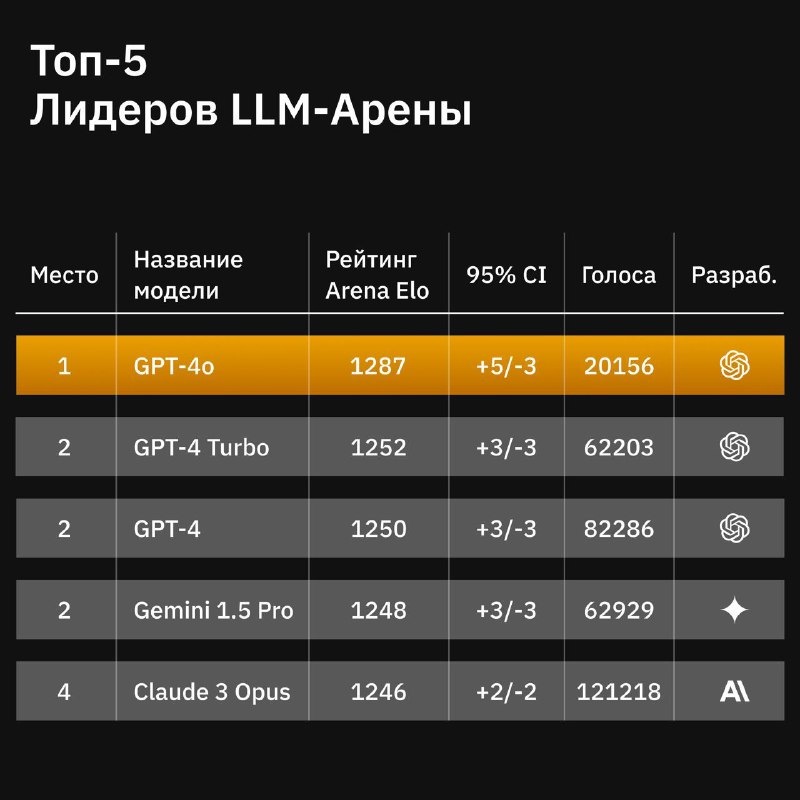
🏆 GPT-4o лидирует в рейтинге Arena и в тестах на кодинг, математику и мультизадачность
Через пару недель после запуска GPT-4o прочно заняла лидирующие позиции в самых популярных тестах языковых моделей ИИ, обогнав предыдущие модели OpenAI и конкурентов — Gemini 1.5 Pro (Google) и Claude 3 Opus (Anthropic). Успех GPT-4o впечатляет.
Мы уже рассказывали, как составляется рейтинг Arena и как туда попадают большие языковые модели (LLM). Чтобы не повторяться, посмотрим, какие еще бенчмарки используются для оценки LLM.
❓ Что такое бенчмарки?
Это специализированные тесты для проверки эффективности языковых моделей.
🔣 Популярные бенчмарки
MMLU — способность понимать естественный язык в условиях многозадачности. Охватывает 57 задач, включая математику, историю и информатику.
MATH — тест, включающий набор данных из 12 500 сложных математических задач.
HumanEval — задачи по программированию на Python.
HellaSwag — измерение здравого смысла. Тест проверяет, может ли LLM завершить предложение, выбрав правильный из 4 вариантов рассуждения.
GSM-8K — математика для начальной школы.
1️⃣ GPT-4o уверенно лидирует, как на Arena, так и в бенчмарках на понимание языка, математику и программирование.
На видео можно проследить, как с выходом новых моделей менялся список лидеров Arena.
🔠 GPT-4o, GPT-4 Turbo и Claude 3 Opus есть в @GPT4Telegrambot.
#OpenAI #Claude @hiaimedia
Post #761
101K


- ❤ 70
- 👍 40
- 🔥 8
- ✍ 4
- 😍 4
- 😁 3
- 🏆 3
- ❤🔥 2
- 🤷 2