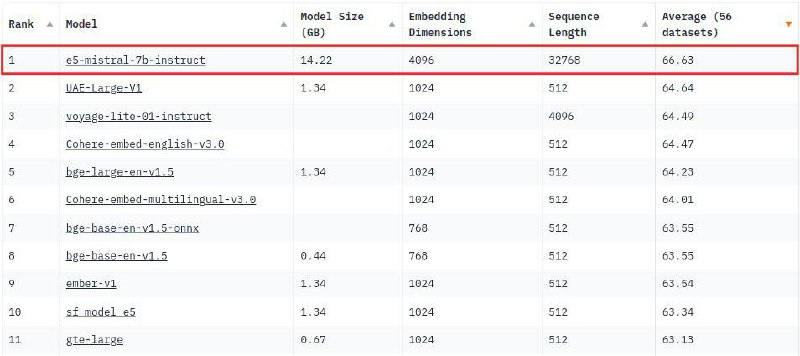
Microsoft побили SOTA эмбеддиг-моделей
Главный камень преткновения современных подходов – данные: собрать хороший датасет для «fetching tasks» очень сложно и дорого. Поэтому часто модели сначала обучают на неразмеченный general данных, а потом файнтюнят на датасетах поменьше. Производительность таких моделей неплохая, но для RAG-систем без дополнительных танцев с бубном они обычно слабоваты.
Но в Microsoft придумали простой и действенный способ обойти эти ограничения. Они решили попросить LLM саму составить датасет, то есть сгенерировать триплеты «задача - релевантный документ - нерелевантный документ», а после обучать эмбеддинги с помощью парного лосса.
Итог – новая SOTA. Этот простой и гениальный подход теперь в топе Huggingface Leaderboard, и может стать поворотной точкой для RAG.
Статья | Модель | Датасет
Post #16
30
Forwarded from Data Secrets