TGViewer
Channel Public Channel
Вася Сизов | grok ML

Вася Сизов | grok ML

@grok_ml

Lead DS нескольких команд. Здесь авторские заметки об ML, работе лидом и факапах, которые тоже случаются
Subscribers
64
Photos
62
Videos
1
Links
16

Showing posts older than #36 · Back to latest

Older Posts 18 shown
Post #35 144
Продолжаем! Сегодня был первый день Data Fusion! Эмоций много, идей еще больше.

Сегодня выступал ds из нашего кластера Гончар Роман и рассказывал про RAG для центра клиентской поддержки КИБ.

В будущих постах я обязательно расскажу об этом проекте, а пока держите фото с выступления.
  • ❤ 4
Post #34
Вася Сизов | grok ML pinned «#о_себе Всем привет! Хочется начать с поста-знакомства. Можно сказать, что я «перекатившийся» айтишник, так как основное образование - стартовые ракетные комплексы. Если коротко - инженер конструктор. И я вообще никогда не хотел заниматься программированием.…»
Post #32 91
В предыдущих постах я рассказывал про PR-стратегию, а теперь делюсь ее первыми плодами
Post #30 86
PR стратегия DS команды, часть 3

В первой части мы разобрали классические каналы — конференции, статьи, TG-каналы. Они работают. Но есть каналы, о которых редко думают как о PR-инструменте, хотя эффект от них бывает не меньше, а иногда и сильнее.

🔵 Обучение и менторство

Записать курс, провести мастер-класс или стать ментором на образовательной платформе — это не просто альтруизм. Каждый студент, который прошёл через вас, становится частью вашего профессионального круга. Площадки вроде Stepik, Skillfactory, внутренних корпоративных академий или даже собственного мини-курса в Notion — всё это работает на экспертный образ команды. Вспомните специализацию на Coursera или курсы от HSE.

🔵 Участие в DS-соревнованиях

Kaggle, Yandex Cup, Alfa Battle, внутренние хакатоны — участие в соревнованиях сигнализирует рынку: команда не просто делает проекты, она готова мериться результатами публично. Даже без призового места сам факт участия и разбор решения после — это готовый контент для статьи или поста.

🔵 Организация DS-соревнований

Это следующий уровень. Когда команда сама готовит задачу для хакатона — она автоматически становится экспертом в глазах всех участников. Плюс это реальная возможность поработать с интересными внешними решениями и, возможно, найти людей в команду.

🔵 Рецензирование и экспертиза

Стать рецензентом программного комитета конференции — это почти незаметная снаружи активность, которая очень хорошо считывается внутри профессионального сообщества. Люди, которые отбирают доклады, хорошо знают друг друга.

🔵 Совместные исследования с вузами

Курсовые и дипломные работы на реальных данных и задачах команды — взаимовыгодная история. Вуз получает практику для студентов, команда — дополнительные руки и свежий взгляд, а в итоге — совместная публикация или доклад, под которым стоят два логотипа.

🔵 Участие в стандартизации и рабочих группах

ГОСТы по AI, рабочие группы при Сбере, Яндексе, ЦБ или отраслевых ассоциациях — звучит скучно, но это прямой доступ к людям, которые формируют повестку индустрии. Один человек от команды в такой группе — это весомый сигнал компетентности.

Объединяет все эти каналы одно: они требуют чуть больше смелости, чем написать статью, но дают то, что статья даёт редко — живой контакт с сообществом и репутацию команды, которая не просто делает, но и участвует в жизни профессии.
  • ❤ 2
  • 🔥 2
Post #29 82
PR стратегия DS команды, часть 2

Конференции — флагман технического PR. Один доклад на правильной площадке может дать больше для узнаваемости команды, чем другая активность. Но «правильная площадка» — это не самая большая, а та, где сидит нужная аудитория. Поэтому разбираем каждую отдельно.

🔵 Data Fusion (8–9 апреля)

Одна из крупнейших data-конференций в России — 60+ сессий, 2700+ участников в прошлом году, спикеры от Росатома до Сколтеха.. Плюс в рамках конференции проходит Data Fusion Contest с призовым фондом 3 млн рублей.

🔵 ScorFest (17 апреля)

Очень нишевая история. Аудитория — риск-менеджеры, скоринговые аналитики, DS из банков и финтеха. Если у команды есть кейсы в кредитном скоринге — это самая целевая аудитория. Маленький зал, но очень плотный нетворкинг.

🔵 AINL Conf (17–18 апреля, Томск)

Академическая конференция по AI и NLP, с 2012 года. Идти стоит, если есть исследовательские результаты или NLP-кейсы — здесь можно получить честный фидбек от учёных, а не только от коллег по индустрии.

🔵 AiConf (20 апреля)

Крупнейшая независимая DS-конференция. В 2026-м меняет формат: вместо привычных докладов — экспертные зоны, факап-митапы, case clinic, брейнштормы. Хочешь не просто выступить, а стать частью живой дискуссии — сюда.

🔵 Data Fest (28 мая)

Конференция ODS — одного из сильнейших DS-комьюнити в России. Высокая планка отбора, очень профессиональная аудитория.

🔵 Saint Highload (22–23 июня)

Конференция про архитектуру и высокие нагрузки. Идти стоит, если у команды есть инфраструктурные кейсы: масштабирование ML-систем, оптимизация пайплайнов, работа с большими объёмами данных в проде.

🔵 Conversations AI (25–26 июня, СПб)

GenAI в бизнесе, продуктах и технологиях. 4 трека, 65+ спикеров, 700+ участников из 300+ компаний. Плюс в рамках конференции — церемония Generation AI Awards. Хороший повод прийти сразу с докладом и номинацией.

🔵 Turbo ML Conf (июль)

Конференция Т-Банка для практиков. 1000+ участников, пять тематических залов: LLM, NLP, CV & Speech, RecSys, Research. Спикеры — из Т-Банка, Яндекса, Сбера, Авито, VK, МФТИ. Хорошая площадка, если есть технический кейс и хочется показать его аудитории, которая сразу понимает о чём речь.

🔵 Practical ML Conf Яндекс (19 сентября)

Крупнейшая в России конференция по прикладному ML. Высокая планка отбора, сильный программный комитет. Попасть в программу — уже само по себе сигнал качества для рынка. Если есть сильный технический кейс — подаваться обязательно.

🔵 Scoring Days (24 сентября)

Финальная точка года в скоринговой теме. Если ScorFest весной — про тренды, то Scoring Days — про методологию и регуляторику. Аудитория консервативнее, зато очень целевая для финтех-кейсов.

Это и есть основа PR через конференции — не погоня за количеством выступлений, а осознанный выбор площадок под конкретные задачи команды. Где-то нужна широкая узнаваемость, где-то — точечный контакт с нужными людьми, где-то — академическая валидация. Если распределить лидов по этим точкам в течение года, к декабрю у команды будет не просто «мы выступали», а настоящее присутствие в профессиональном пространстве.
  • 🔥 2
  • ❤ 1
Post #28 76
PR стратегия DS команды, часть 1

Когда становишься лидером нескольких команд, хочется растить команду, развивать их проекты и всячески им помогать.

Только если раньше приходилось развивать линейных специалистов, то сейчас это нужно сделать с лидами. Мне кажется, что самый понятный рост для лида команды — это повышение ответственности и увеличение портфеля важных для бизнеса проектов.

Конечно, хорошо жить в мире, когда задачи прилетают со всех сторон и их больше, чем людей. Но это вообще не всегда так. Именно здесь и помогает PR-стратегия, основная цель которой — показать и рынку, и бизнесу наш профессионализм и реализованные проекты.

Наш DevRel Инна Гринько подготовила для нас материалы, которыми я и хочу с вами поделиться.

Конечно, основа PR — это каналы, через которые мы заявляем о себе. И их куда больше, чем кажется на первый взгляд:

🔵 Официальные пресс-релизы — формируют репутацию на уровне компании и попадают в отраслевые СМИ
🔵 Статьи на Хабре — один из самых сильных инструментов для технического сообщества: хорошая статья работает годами
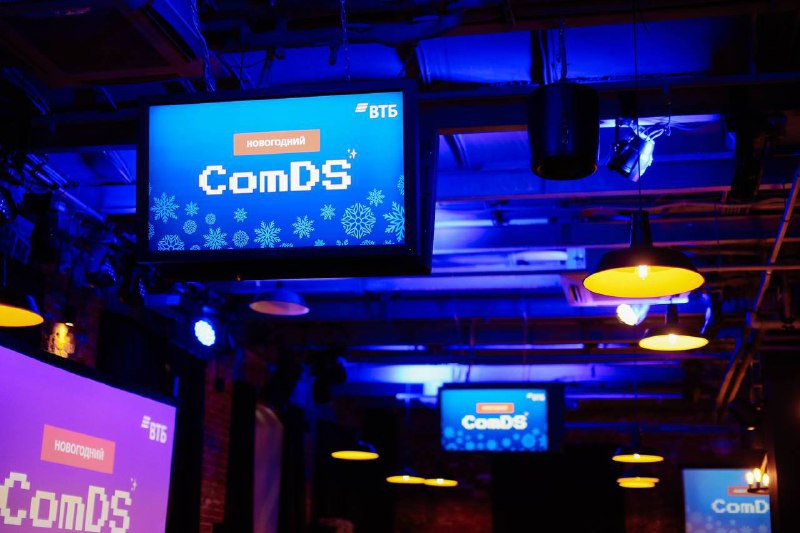
🔵 ComDS — внутреннее сообщество DS в ВТБ, куда мы приглашаем и внешних докладчиков, и слушателей; отличный способ строить мосты между внутренней экспертизой и рынком
🔵 Подкасты — формат, который хорошо заходит тем, кто не читает лонгриды, но слушает в дороге
🔵 Open Source — публикация кода или инструментов говорит о команде больше, чем любой пресс-релиз
🔵 TG-каналы ВТБ (например, Data Fusion) — быстрый способ держать профессиональное сообщество в курсе наших разработок
🔵 Личный TG-канал — лид с живым каналом становится лицом экспертизы, это работает и на внешний рынок, и внутри компании
🔵 Внешние премии (например, FinNext Award) — победа или даже номинация — это готовый инфоповод и знак качества для бизнеса
🔵 Выступления в вузах — строим отношения с будущими специалистами и параллельно прокачиваем навык доносить сложное просто
🔵 Конференции — флагман технического PR; один доклад на крупной конференции может сделать больше для узнаваемости команды, чем полгода другой активности
🔵 Внутренний портал компании — часто недооценённый канал: новость о разработке внутри корпорации формирует репутацию у стейкхолдеров, которые напрямую влияют на портфель проектов


Каналов много, и это хорошая новость — не нужно быть везде сразу. Главное — выбрать два-три, которые дают наибольший охват именно вашей аудитории, и работать с ними системно. PR-стратегия работает не когда мы появляемся ярко и редко, а когда нас видят регулярно и узнают по качеству.
  • 🥰 1
Post #27 54
А какой ты выбрал путь?
  • ❤ 1
Post #26 60
Graph RAG и «Гарри Поттер»

На новогодних праздниках у меня появился доступ к внешней H100. Пройти мимо такого подарка я не мог, поэтому взялся экспериментировать


На горизонте маячил проект рага со сложными вопросами и сотнями документов (к слову, решили мы этот кейс без графового рага), поэтому хотелось проверить “продвинутый” подход.


Когда я изучил библиотеку от Microsoft , то понял, что на работе что-то подобное мы уже делали.


Если на пальцах, то идея в следующем:


⚪️ Давайте каждый чанк пропустим через LLM
⚪️ Выделим сущности (а также их описание)
⚪️ Выделим отношения между сущностями (а также проставим силу связи между сущностями, это пусть тоже делает LLM)


Вот и готово! По сути у нас есть узлы, ребра, и даже сила связей. Построим граф, и будем по нему искать контекст.


Я думал, что будет работать из коробки, но не тут то было. 3 дня я потратил, чтобы завести графовый раг на банковском документе, скачанном из интернета. Но возникла другая проблема - я не знал, как оценить работу. Поэтому я выбрал книгу о Гарри Поттере. Пришлось даже отойти от графового рага и сделать temporal rag (проблема была в том, что классический графовый раг не учитывает временную компоненту == развитие сюжета).


В итоге, я тестировал подходы, подавая простые и сложные многокомпонентные вопросы. Например, я просил перечислить всех учителей Хогвартса и их предметы. Или перечислить все испытания, которые проходили ученики на пути к философскому камню.


Какие выводы я сделал:


⚪️ Графовый раг - концепция хорошая. Она позволяет искать контекст по всем документам, выделять только нужные сущности и отношения. Также зачастую не упускает мелкие важные детали.


⚪️ Сам граф очень сложно готовить:


🔴 Первая причина - LLM. Если модель слабая и часто галлюцинирует, то граф конечно же развалится. Например, модель одни и те же сущности называет по-разному (в моем случае qwen 3 30b), что только мешает построить граф.
🔴 Вторая причина - количество запросов к LLM. Представьте, что через LLM нужно пропустить все чанки. Это тысячи запросов к языковой модели. Построение индекса довольно долгое (хоть я и запускал в 8 потоков).
🔴 Третья причина - узлы с огромным количеством связей. Представьте, что весь документ про кредит. В итоговом графе у сущности “кредит” будет очень много связей. Это означает, что граф нужно будет преобразовать, перед тем как в нем искать.


Выбрал бы я такой подход для прода? Если данные изначально более менее структурированные и не представляют из себя подобие графа, то нет. Мои эксперименты показали, что классический раг уже хорошо справляется с задачей. А затраты на подготовку графового подхода просто несоизмеримы по сравнению с классическим рагом.


Я бы выбрал что-то среднее, например agentic rag или self rag.


Красивые слайды и примеры можно посмотреть здесь.
  • ❤ 2
  • 👍 1
Post #25 67
Пропал на 6 месяцев — и вот что изменилось

Пропал из ленты на 6+ месяцев — и это оказалось самым насыщенным периодом за последние годы.


Хотел подвести итоги в конце 2025, но все ключевые изменения случились уже в первом квартале 2026.


За это время:
— стал лидером нескольких DS-команд
— впервые как кросс-функциональная команда вывели модель в прод
— закрыли несколько пилотов с высокими результатами


Но самое важное — сильно выросли и я, и команда.


Многое оказалось сложнее, чем ожидал: например, заставить RAG работать на сотнях документов с ситуационными вопросами на входе.


За эти месяцы накопилось много опыта, которым хочется делиться: про внедрение, про команды, про ошибки и успехи.
Похоже, пауза затянулась — постараюсь больше так не пропадать.


PS: а выше был на новогоднем ComDS - наша внутренняя площадка ВТБ, где мы обкатываем наши доклады и приглашаем ds-ов из других компаний.
  • ❤ 2
  • 🔥 2
  • 👍 1
Post #22 70
Data Fest 2025

Также совсем недавно я выступил на data fest с докладом «Структура вместо хаоса: практика внедрения процессов».

Я искренне верю, что практически в любой компании можно выстроить процессы и сделать работу команды лучше и комфортнее, если подходить к этому системно.

Посмотреть доклад можно здесь (на 6.28): https://vk.com/video-164555658_456241376
  • ❤ 2
Post #21 69
Многорукие бандиты в банке

Давно не было постов, но мы не сидели сложа руки, а занимались кучей разных задач. Одна из них - применение многоруких бандитов.

Про сами алгоритмы рассказывать не буду, про них куча информации в сети. А вот про основную проблему скажу: проверка алгоритмов до внедрения.

Представьте ситуацию, вы внедрили алгоритм, алгоритм выдает вам руку (предложение для клиента), вы отправляете это предложение клиенту и он его берет или не берет. То есть какая бы рука не была, мы точно получим ответ от клиента.

А что делать, если мы только тестируем алгоритм без клиентов? Верно, нужен симулятор клиентов.

О самих алгоритмах и о симуляторе подробнее можно почитать в нашей статье: https://habr.com/ru/companies/vtb/articles/915698/
  • ❤ 2
  • 🔥 1
Post #20 58
Как попасть в точку при общении с заказчиком?

Думаю многие знают, что в крупных компаниях бизнес и IT - часть отделены. Отделены в том плане, что бизнес выступает заказчиком, а IT - исполнителем. Вот и наша команда делает кучу всего для бизнеса.

В начале этого года стартанули несколько крупных проектов, но забуксовали мы сильно на самой первой части - сбор и согласование требований.

Думаю, все уже знаю, что есть функциональные и нефункциональные требования к сервису. Но объяснить бизнесу что мы от них хотим - та еще задача.

Что не помогло:
- Сразу рисовать всю схему работы сервиса. Слона надо есть по частям, а мы вывалили сразу весь объем информации на заказчика
- Не помогли и большие списки вопросов к заказчику, они остались без ответа
- Переходы в детали на начальном этапе - лучше вообще так не делать. Только затягивает процесс, а результата нет

Что помогло:
- Слайд с определениями ФТ/НФТ и примерами требований по каждой группе. Здесь заказчик понял, что мы от него хотим.
- Слайд с простыми примерами online работы сервиса, batch работы сервиса и слайд с примером работы очереди (в качестве примера рассказывал про озон). Данный слайд помог собрать нам правильные НФТ.
- Больше всего помог слайд с образом результата: мы разделили слайд на две части, на левой половине показали упрощенную схему работы сервиса, а на правой - то, что получит заказчик. Если дашборд, то картинка дашборда. Если таблица в Hadoop - то пример таблицы с несколькими заполненными строками исходя из задач заказчика. Здесь мы смогли собрать ФТ и стали двигаться дальше.

Еще помогло выделение ЛПР (лица, принимающие решения) со стороны заказчика. Отмечу, что на разных этапах проработки это могут быть разные люди. Но если «бить» в них, то договариваться получается намного быстрее.

Кажется, что все просто и очевидно. Но зафиксировать требования по большому проекту с кучей людей - тот еще квест. Надо точно прокачивать скилл «переговорщика»)
  • 🔥 2
Post #19 54
Data Fusion Contest 2025

Мы с командой причастны ко второй задаче, присоединяйтесь!

Итаааак, мы объявляем регистрацию на Data Fusion Contest 2025 открытой!

Призовой фонд соревнования увеличен — 3 000 000 рублей

В этом году вас ждёт три задачи:

1️⃣Label Craft — про предсказание категории товаров на основе полученных данных о названиях товаров и их описаний. Призовой фонд задачи — 2 000  000 рублей.

2️⃣4cast — про  предсказание динамики платежей на последующие 12 недель. Призовой фонд задачи — 1 000 000 рублей.

3️⃣Distribution — образовательная задача, где участникам необходимо на основе полученных на входе данных признаков и накопленных статистик счетов клиентов банка,  предсказать распределение суммарных остатков на всех накопительных счетах клиента. За эту задачу будем дарить мерч 💙

В каждой из задач будет специальная номинация за лучшие публичные решения!

🔜 Stay tuned!

Регистрация доступна на платформе соревнования 🎉
  • ❤ 1
Post #18 50
RAG за 40 минут или VS CODE на "максималках"

До нового года я начал погружаться в построение RAG-ов. Простыми словами - а давайте в контекст промпта для LLM будем добавлять свои локальные данные. Но не все данные, а максимально подходящие под запрос. Звучит не очень сложно, но вот написать такое руками даже с библиотеками - все равно время.

Примерно в то же время я узнал о Cursor - это тот же VS CODE, в котором есть две дополнительные функции:
- Chat - обычный чат с LLM, которой можно задавать вопросы по коду и не только
- Compose - на вход подаем промпт, а на выходе код. И не просто код - автоматически создаются все файлы и проект в целом. Далее можно просто уточнять требования и принимать или не принимать изменения в коде.

Мне показалось это очень интересным, и я решил использовать Cursor для написать простого RAG в виде web приложения. Требования у меня были следующие:
- Стек - django, langchain, faiss, небольшая llm для локального использования
- В django - три страницы - просто чат с llm, вкладка для загрузки pdf документа и окно для вопросов по этому pdf, и третья страница - визуализация разбиения документов на части

Здесь нужно остановиться поподробнее про разбиение pdf документа. Идея следующая: загружаем pdf документ, парсим его, разбиваем текст на кусочки. Далее задаем вопрос, по этому вопросу с помощью faiss ищем похожие на вопрос кусочки из pdf, добавляем эти кусочки в контекст промпта для llm рядом с вопросом, получаем ответ на основе этого контекста. В итоге, можно задавать вопросы по любому pdf документу!

Думаю, идея понятна. Переходим к реализации, а точнее, к написания промптов в Cursor. Из интересного:
- РАБОЧИЙ прототип был готов через 40 минут
- Используемая модель в cursor - claude 3.5 sonnet
- Я промпты писал исключительно на русском
- Если возникали ошибки - я просто копировал их из командной строки без комментариев. Если были сложные ошибки, то добавлял в контекст файлы с кодом (в cursor так тоже можно)
- Один раз возникла ошибка при отображении элемента в django-приложении - я просто сделал скриншот и отправил его cursor

Если коротко - это восторг! Я не написал ни одной строки кода. Но есть и некоторые тонкости:
- Я заранее понимал какие промпты писать, так как с темой был знаком (да и с django на базовом уровне тоже)
- Код, очевидно, не оптимальный. Иногда даже рабочий, но не правильный. После подготовки прототипа нужно будет потратить много времени на рефакторинг и анализ

Но главный вывод - для прототипов на коленке просто must have. С моим кодом ознакомиться можно здесь: https://github.com/Vasily-Sizov/simple_rag. Я специально не вносил никаких своих изменений, чтобы можно было понять, на что способен cursor.

PS: Cursor на данный момент бесплатный и нет ограничений на создаваемые аккаунты!
GitHub GitHub - Vasily-Sizov/simple_rag Contribute to Vasily-Sizov/simple_rag development by creating an account on GitHub.
Post #17 41
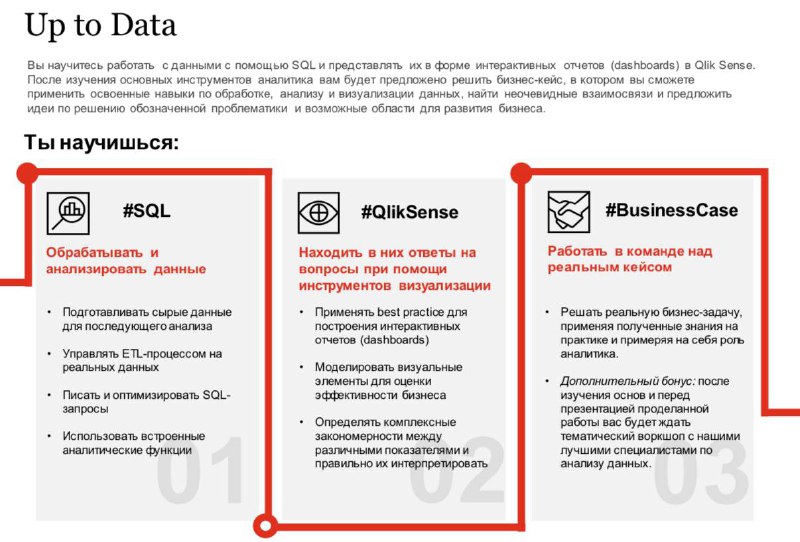
Up To Data в PWC

Ранее я рассказывал о том, как я не попал в PWC. В этом посте я расскажу, а что же было дальше.

2019 год.

Хоть я и не попал в PWC, для меня это была маленькая победа, так как ML и python на тот момент и изучал всего несколько месяцев. Замотивированный я вышел вновь на рынок и начал искать работу. Но на рынке было вообще не радужно. Я прошел десятки собеседований, чтобы попасть на позицию младшего аналитика в одну небольшую компанию (опыта то не было, да и знаний глубоких тоже).

Работал я в основном с Oracle и внутренними инструментами. Даже решал задачку тематического моделирования. Но я хотел именно в DS. Поэтому я постоянно мониторил рынок и наткнулся на аналитическую программу Up To Data. Да, это аналитика, но программа проходила в PWC. Участие должно было украсить мое резюме.

Прошел туда я без проблем. После этого началась упорная работа: sql, BI, и вот это вот все. Если кто-то когда-нибудь участвовал в соревнованиях по решению кейсов, то это был именно тот случай, только нужно было дополнительно проанализировать данные с помощью SQL и построить дашборд, показывающий найденные инсайты для решения задачи.

Сначала мы больше месяца учились, а уже потом разбились на команды и стали решать кейс.
Саму задачу я уже не помню (почти 6 лет прошло), но наши командные посиделки по решению кейса я помню до сих пор!

В самом конце было два этапа: 8 команд разбили на 2 большие группы, и каждая команда презентовала свое решение. А далее финал, где уже соревновались 2 команды, прошедшие во второй тур. Кстати, как раз во время всех этих этапов я ушел с предыдущего места работы в свободное плавание и посвятил себя решению кейса.

В итоге, мы без проблем прошли во второй тур, классно презентовали свое решение (спасибо команде), но все же заняли второе место!

Вывод после всего этого я сделал очень простой: хотя я и потратил много времени на эту активность, получил дополнительные навыки и знания, рынок был неумолим - опыт, опыт, и еще раз опыт. Поэтому следующий заход по поиску работы был точно такой же - долгий и сложный. Но после работы аналитиком выбор компаний был уже намного интереснее.

PS: Кажется, что ситуация на текущем рынке еще сложнее.
Post #16 40
Пожелания на 2025 год

Я работаю лидом уже несколько лет. Работы и активностей много, особенно с бумом LLM. И я стал замечать, что моя эффективность с ростом проектов постепенно падает.

Я долго рефлексировал по этому поводу и пришел к следующему - я выделил четыре компонента: люди, процессы, инструменты, база знаний.

- Люди: это основа, без них ничего не получится. Здесь важно самому оставаться человеком и думать о свое команде. Например, это мотивация, комфорт, рост и soft и hard скиллов. Нельзя об этом забывать.
- Процессы: для меня вообще стало откровением, что можно не ждать, что кто-то сверху о чем-то подумает, а менять что-то на своем уровне. Я говорю о процессах в самой работе DS-а, о процессах найма, процессах взаимодействия с другими командами.
- Инструменты: здесь в основном это инфраструктура и ее доступность. Например, чтобы у каждого была хорошая среда разработки, всегда хватало GPU, если что-то ломается, то это быстро чинилось.
- База знаний: очень важный компонент. Намного проще, если все инструкции, подходы, описания, заявки, документации собраны в одном месте и структурированы. Это позволяет команде быстро вникать в новые процессы, делиться своими подходами и так далее.

Про каждый компонент и то, как я с ним работаю, я напишу в следующий раз.

А сейчас я вам желаю работать в крутых командах с настроенными процессами и стабильной инфраструктурой.

С Наступающим!
Post #12 40
Когда-то наше внутреннее DS-сообщество в ВТБ начиналось с простого созвона в «Zoom», а теперь это вот такая DS-тусовка с гостями из разных компаний!)
  • 😍 1
  • 😭 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →