
AReA
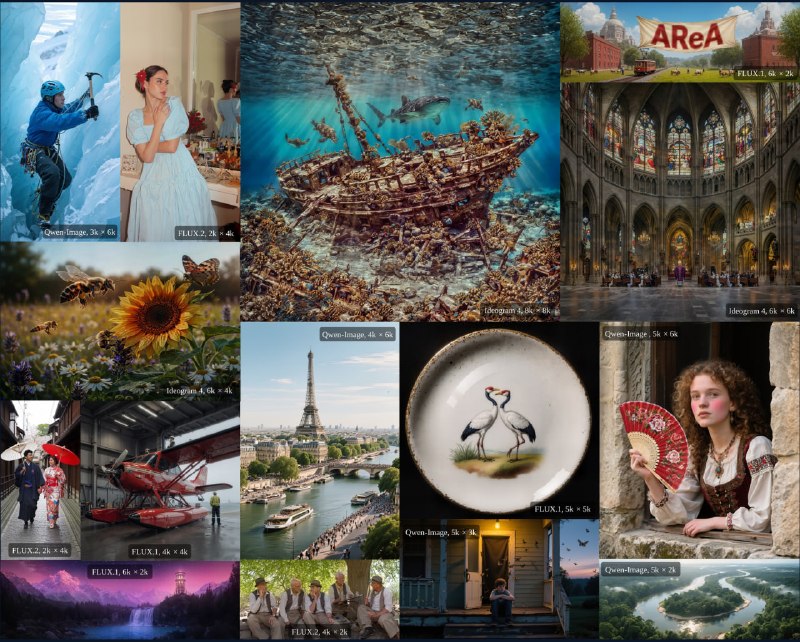
Метод внимания для диффузионных трансформеров. Дает генерацию в высоком разрешении без обучения на FLUX.1, Qwen-Image, FLUX.2 и Ideogram 4.
• До 3.2х быстрее полного внимания на 6144² у FLUX.1, 2.9х у Qwen-Image
• До 6х к нативной стороне, 67 МП
• Без обучения, веса не трогаются
Эффект нарастает с разрешением, где внимание и становится узким местом
Поддержка FLUX.1-Krea-dev есть, остальные ждем
Гитхаб
Спасибо @m_franz
#4k #t2i
MAX
Post #15138
926

- 🔥 4
- 👍 3
- ❤ 1