
Завел наконец свою коробку для нейровычислений
Спустя неделю метаний нейрострелки осциллографа я получил более-менее рабочий сетап под рабочие и бытовые задачи
По крайней мере, новенький Qwen 3.8 27B только что закончил ревью правок в моем сайд-проекте, и оно весьма похоже на правду
Локальные модели воображение, ясен-красен, не поражают, но в целом делают то, что велено, в приемлемый срок
Я еще не гонял бенчи, но субъективно, в августе 2026 дома на 128 гигабайтах памяти можно развернуть то, что год назад продавалось только по подписке и считалось только на серверном железе
Домашние тачки за год так сильно не выросли - просто появились нормальные MoE-модели, и новая архитектура позволила порезать стоимость токена
Если тренд на отставание локальных моделей от фронтира в год сохранится, я буду крайне рад и доволен
Что получилось
За неделю я перенес домой кучу задач, которые раньше отдавал Opus и Sol:
- Практически весь линейный кодинг и агентские сессии, которые не требуют особо думать и сводятся к «братан, ну вот как там сделай, да»
- Чатики с нейронкой уровня «нужно ли мыть фарш»: рецепты, расчеты и прочее, с чем справилась бы прошлогодняя ChatGPT
- Исследование домашней инфры уровня «скажи, почему отвалилась интеграция Home Assistant с посудомойкой, и почини»
- Все, с чем подписочные модели отказываются работать из-за встроенной цензуры: найти модель с пошатанными весами все еще проще, чем убеждать Fable, что тебе только спросить
Все, что требует серьезного исследования вроде «докажи NP-полноту змейки» или «спроектируй бекенд пивоварни на сто тысяч рабочих мест», на локалки не ложится никак - разве что как на простых исполнителей
На чем это все запускается
У меня дома последние 10 лет нет ни одного нормального компьютера, который не сервер и не ноутбук, так что вариант с 5090 в готовой сборке отпал сразу, а на маке с 16GB далеко не уедешь
Так что мы с @liekkilull скинулись и вперли домой вот это
Внутри у железки 128 гигабайт унифицированной памяти и интегрированная Radeon 8060, которая по мощности близка к 4090
Такая штуковина может целиком вгрузить хоть gpt-oss-120b и считать ее не очень быстро, зато бесплатно
На практике производительность такая
Qwen3.6-35B-A3B с квантованием в «аж Q8_X_XL» дает около 30 токенов декодинга и 300+ промпт-процессинга при окне в 262К
Laguna-S-2.1, которая внезапно бьет Qwen в кодировании по качеству, дает стабильные 23/200 токенов и почти не деградирует при забивании контекста
Свежий Qwen3.8-27B в Q6 пока дает жалкие 10/120, но квантование сделано «день в день» и без MTP, так что жду около 25/200
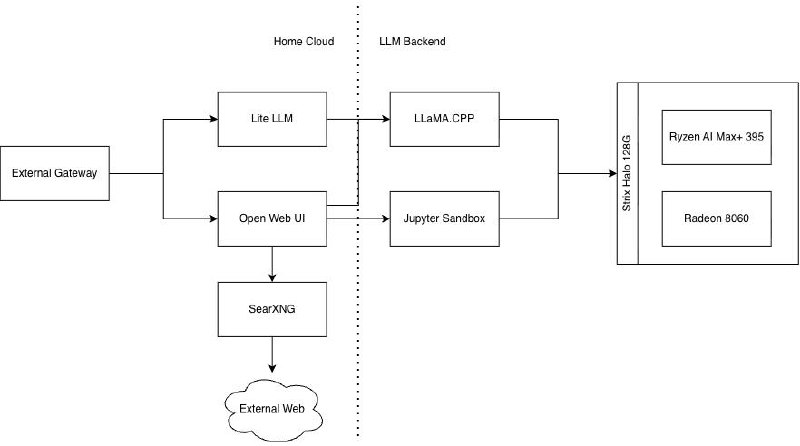
Как это все собрано, видно на картинке к этому посту
Запросы приходят на гейт и оттуда уходят либо в LiteLLM, либо - Open Web UI
Open Web UI - это чатик, чтобы поболтать с нейронкой, прямо как с ChatGPT
К нему прикручены SearXNG и Jupyter - поиск в сети и запуск кода, чтобы чатик был полезным
LiteLLM - это прокси для агентов, чтобы можно было писать код и запускать длинные цепочки рассуждений
Дальше запросы уходят на Evo X2, где LLaMA CPP гоняет модельки и возвращает ответы назад
Все это дело стоит у меня дома, потребляет 150 ватт электричества и не требует ни подписок, ни даже внешнего Интернета
Зачем мне это все
Разумеется, я не фанатик и бросать Fable 5 ради домашнего Qwen не собираюсь - это модели разного уровня для разных задач
Но использовать того же Qwen как глупого исполнителя при умном Opus-оркестраторе - это получится
Кроме того, я хочу поиграться с технологиями
Одно дело - заплатить сотню баксов и получить готового агента, настроенного инженерами, закончившими Гарвард
Совсем другое - набить себе шишки, выясняя, чойта у нас загрузка второй модели в память вызывает отказ хоста с OOM и не чинится ничем, кроме перезагрузки
Драйв вокруг всего этого нейрозоопарка подозрительно напоминает ранние 00-е, когда быть инженером было весело, а нехватка мощности заставляла искать решения
Только теперь за возможность кутить, перемножая матрицы с утра до ночи, еще и платят до фени, так что не вижу причин пропускать праздник
Пойду что-нибудь сгенерирую
Post #817
334
- 🔥 6
- 👍 2
- ❤ 1