TGViewer
Градиентное погружение Градиентное погружение @gradientdip · 4.2K subscribers
Post #218 6.05K
Kaggle Accelerator

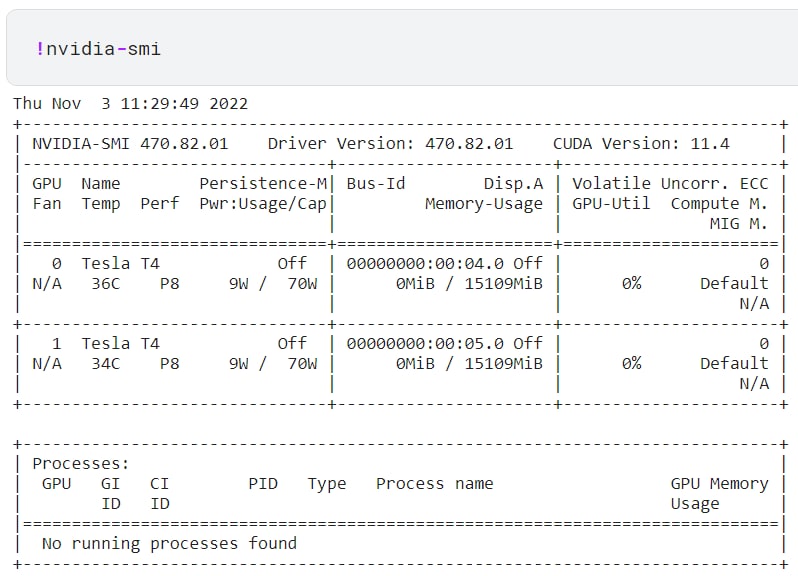
Ещё неделю назад заметил новую фичу на Kaggle, помимо конфигураций P100 (16 гб), TPU v3-8, теперь доступны T4×2 (15 + 15 гб видеопамяти).

P100 они не заменят и будут уступать, но позволят:

1) При должном желании (сложно) запускать 2 эксперимента вместо одного, при этом недельная квота GPU (30-40 часов) общая для T4×2 и P100, а это дополнительные гпу часы.

2) Ускорить инференс/обучение (в некоторых случаях).

3) Тюнить параметры параллельно.

4) Запускать большие модели (до 30 гб).
Кажется что это самый большой плюс.
Да, все ещё неудобно, но лучше чем zero-offload.

Training using 2 T4 with Pytorch DataParallel
Single-Machine Model Parallel Best Practices
  • 👍 23
More from @gradientdip
  1. Feb 3, 2025Инженер LLM (Оптимизация и RL Alignment) Стартап в области безопасности ИИ Чем предстоит з…
  2. Oct 24, 2023🔥TensorRT-LLM 👉Ваш любимый нейронный ускоритель получил расширение! TensorRT - движок, к…
  3. Oct 15, 2023🧹Scrapper Инструмент для парсинга страниц с JS. Работает в докере, можно обращаться по ап…
  4. Oct 6, 2023🏅А кто сегодня молодец и взял Trending paper на Hugging Face, обогнав Google DeepMind и C…
  5. Oct 6, 2023Всем привет, мы строили строили и наконец построили! Первая супер-библиотека по spelling c…
  6. Oct 3, 2023⚡️Началось открытое голосование за номинантов премии HighLoad++. Среди прочих достойных но…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →