
PaddleOCR-VL-1.5.
Только что Baidu мощно опенсорснули новое поколение модели для парсинга документов: PaddleOCR-VL-1.5.
Всего 0.9B параметров, и она заняла первое место в глобальном рейтинге OmniDocBench V1.5. По совокупной производительности обходит Gemini-3-Pro, DeepSeek-OCR-2 и GPT-5.2.
В повседневной работе и жизни фото контрактов или счетов, снятые на телефон, часто получаются с перекосом, изгибом или деформацией.
Если распознавать такое классическими OCR-инструментами, нередко бывает пропуск контента или вообще полный провал распознавания.
С PaddleOCR-VL-1.5 эти проблемы решаются.
Это первая в мире OCR-модель, которая поддерживает “позиционирование по нестандартным рамкам”. Она точно распознаёт трапециевидные, сложенные, изогнутые и другие нерегулярные формы документов.
Даже если документ смяли или он сильно исказился из-за угла съёмки, модель может восстановить структуру таблиц и текста “ячейка за ячейкой” с точностью, близкой к сканеру.
Плюс добавили распознавание печатей и автосклейку таблиц, которые идут на нескольких страницах. Ещё отдельно прокачали редкие иероглифы, древние тексты и 109 языков, чтобы заметно повысить стабильность в сложных рабочих сценариях.
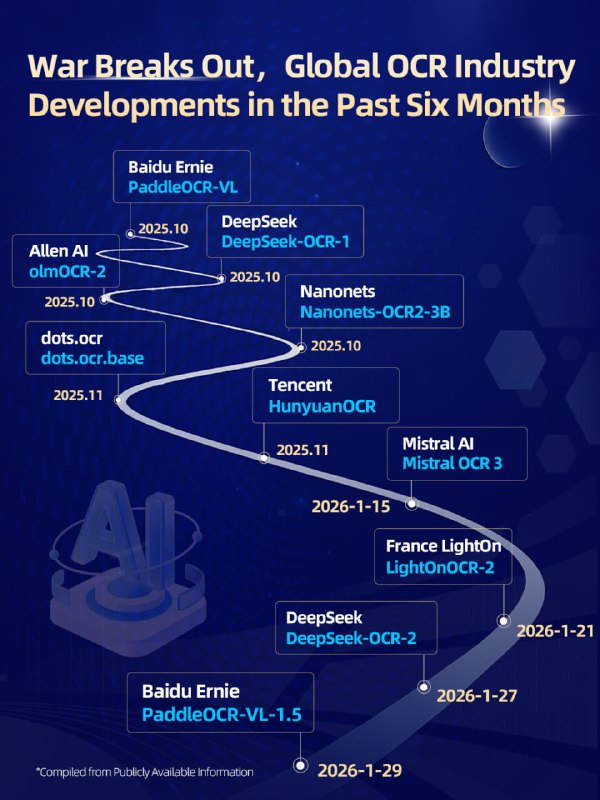
За последние полгода OCR-гонка реально стала очень жёсткой: крупные компании активно выкатывают новые модели и пытаются занять нишу документ-парсинга.
А релиз Baidu PaddleOCR-VL-1.5 попал ровно в боль разработчиков: распознавание “нестандартных документов”, которые обычно хуже всего даются.
То есть OCR перестаёт быть штукой только для идеальных сканов и начинает нормально работать в сложных бизнес-сценариях.
Сейчас веса модели полностью открыты. Разработчики могут скачать или протестировать онлайн на Hugging Face.
Онлайн демо, Скачать модель
📁 Language: #Python 76.3%
⭐️ Stars: 61.9k
➡️ Cсылка на GitHub
📱 @git_developer
Post #1369
3.03K


- 👍 7
- ❤ 2
- 🔥 1