
plexe
Чтобы натренировать ML-модель, обычно надо шарить в алгоритмах, писать код и бесконечно тюнить гиперпараметры. Для большинства это входной барьер, который сразу отбивает желание.
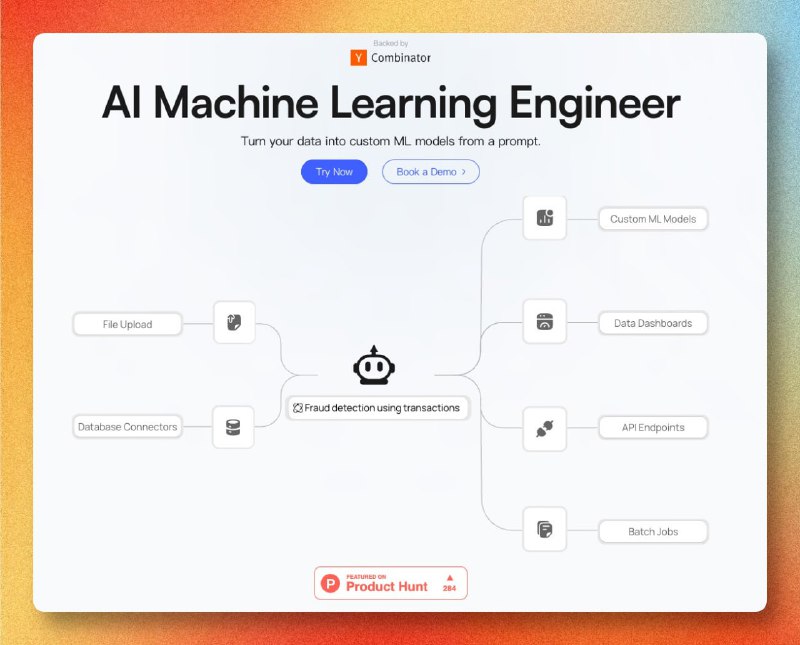
На GitHub есть Plexe, опенсорсный проект, который сильно снижает порог: ты описываешь задачу обычным языком, а он автоматически собирает машинное обучение под это.
Достаточно по-человечески объяснить, что именно хочешь предсказать, какие данные на входе и что должно быть на выходе. Дальше система через связку нескольких агентов сама проходит весь пайплайн: анализ данных, план решения, генерация кода, тесты и оценка качества.
Поддерживает разных провайдеров LLM: OpenAI, Anthropic, Ollama и другие. Плюс умеет автоматически выводить структуру данных или даже генерировать синтетический датасет.
Еще внутри есть распределенное обучение на Ray: можно параллельно прогонять несколько вариантов моделей и сильно ускоряться.
Если тебе нужно быстро проверить ML-идею или дать возможность строить модели не технарям, штука выглядит реально полезной.
📁 Language: #Python 92.0%
⭐️ Stars: 2.3k
➡️ Cсылка на GitHub
📱 @git_developer
Post #1367
3K
- 👍 7
- ❤ 3
- 🔥 3