PDF Document Layout Analysis
Когда возишься с PDF и нужно точно определить, где заголовок, где таблица, где картинка, большинство инструментов либо мажут мимо, либо перегружены до абсурда.
Нашёл на GitHub проект PDF Document Layout Analysis. Это опенсорс, заточенный под разбор сложной структуры документов.
Он различает больше 11 типов элементов: заголовки, основной текст, таблицы, формулы, изображения и так далее. Плюс сам выстраивает корректный порядок чтения.
Есть экспорт в Markdown и HTML. OCR завёрнут через Tesseract, из коробки поддерживается 150+ языков.
Помимо этого, встроен автоперевод — можно выгнать документ сразу в другую языковую версию, сохранив формат и структуру.
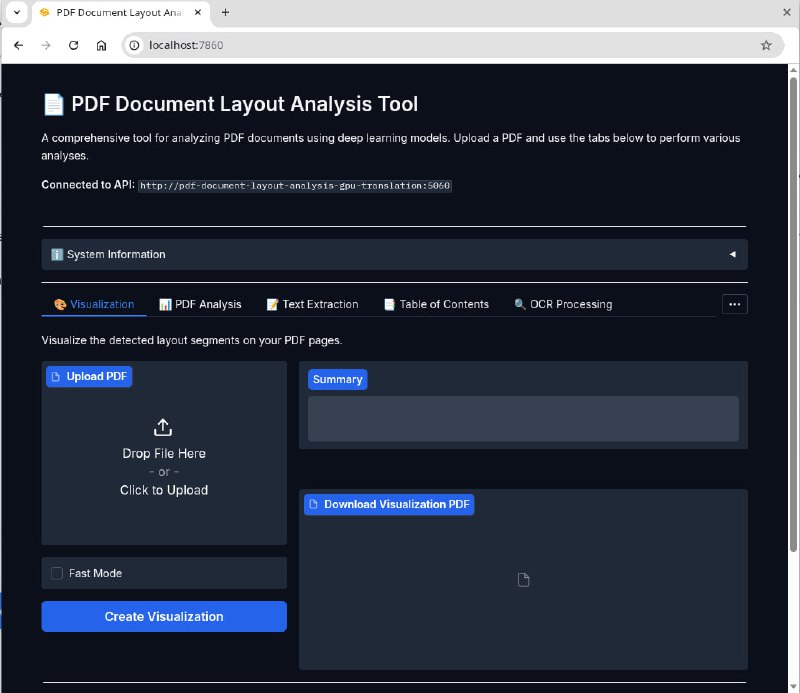
Для работы есть визуальный Web UI, а ещё доступен REST API. Весь стек можно поднять локально через Docker одной командой.
📁 Language: #Python 89.2%
⭐️ Stars: 1k
➡️ Cсылка на GitHub
📱 @git_developer
Post #1289
3.31K
- 🔥 7
- 👍 2