
github | demo | huggingface
На днях LLM команда Xiaomi опубликовала в открытый доступ MiMo-Audio — 7b LLM с нативной поддержкой понимания и генерации речи. Основные особенности модели:
- единые дискретные токены для понимания и генерации
- предобучение на 100+ миллионах часов речи (для сравнения: Kimi-Audio — 13M часов; Whisper-large-v3 — 1M часов)
В этом посте мы кратко опишем подход и полученные результаты
Токенизация аудио
Для кодирования аудио авторы используют Transformer (1.2B) с RVQ токенизацией. В нем одна секунда аудио кодируется 25 токенами в каждом из R=8 кодбуков.
Одна из проблем в токенизации аудио — компромисс между кодированием семантики и акустических особенностей. Для ее решения применяют multi-task обучение в 2 этапа
1) обучение токенизатора на реконструкцию исходной аудиозаписи (акустика) + audio captioning с помощью LLM (семантика), 11M часов
2) с замороженным энкодером и квантизатором (которые подстроились под семантическое пространство LLM) доучивают декодер и вокодер для улучшения качества реконструкции
Добавление модальностей в текстовую LLM
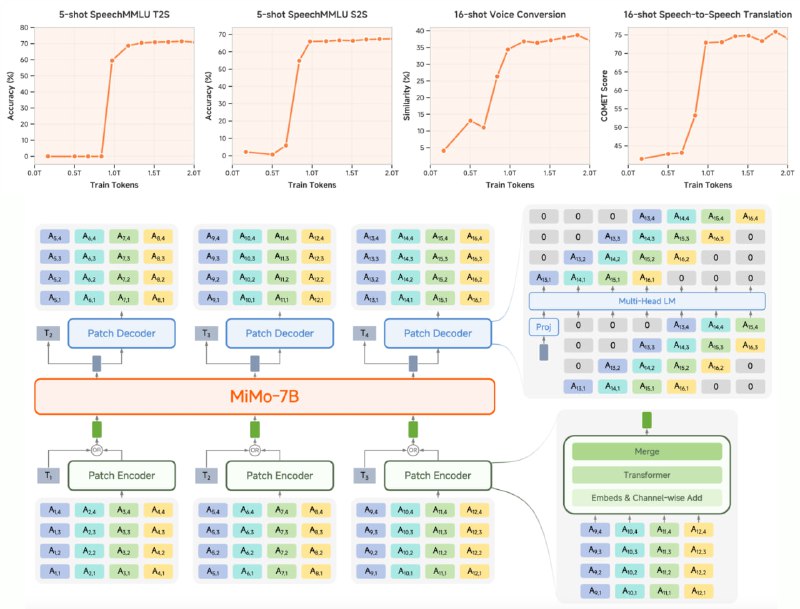
- для каждого из R=8 уровней RVQ инициализируют таблицу эмбеддингов
- аудио данные сильно разрежены, одна секунда кодируется 25 токенами, для выравнивания с токенами текста добавляют
PatchEncoder, который сжимает (seq_len=4)x(R=8) токенов в один эмбеддинг- из финального скрытого состояния LLM генерируется как текстовый токен, так и аудио токены, для последних добавляют
PatchDecoder: 16-layer Transformer, 8 lm-head'ов для каждого уровня RVQ, MusicGen-like задержка по времени между уровнями квантизацииPre-training
Про данные сказано только то, что их 100M+ часов, они разнообразные и фильтрованные
Инициализируют модель весами MiMo и учат в 2 этапа
1) Understanding Training. Добавляют к LLM
PatchEncoder и учат все веса модели. 1.2T текстовых токенов + 1.4T аудио. Loss вычисляется только по текстовым токенам. Задачи: speech-text interleaved; speech recognition (ASR); audio captioning; text pre-training2) Understanding-Generation Joint Training. Добавляют
PatchDecoder и учат все веса модели. 2.6T текстовых токенов + 2.4T аудио. Задачи: speech continuation; speech-text interleaved; ASR; text-to-speech (TTS); instruct TTS; text pre-trainingРезультаты:
- наблюдают GPT-3 moment: на масштабе ~1T токенов MiMo-Audio способна решать задачи, которых не было в обучении, во few-shot режиме (например, speech-to-speech translation; voice conversion)
- минимальная деградация MMLU в сценарии text-to-text и speech-to-speech (72.5 vs 69.1)
Post-training
Используют как фильтрованный open-source, так и внутренние данные. Суммарно 100B токенов в следующих форматах: ASR, TTS, audio understanding, spoken dialogue, instruct TTS, text dialogue
Результаты:
- обходит open-source того же размера и приближается к уровню
Gemini 2.5 Flash на бенчмарках понимания аудио (MMAU, MMAU-Pro, MMAR)- на Speech-to-Speech бенчмарке Big Bench Audio обходит open-source модели на 7+ пунктов, но отстает на 14 пунктов от
Gemini 2.5 Flash Live- на InstructTTSEval (оценка с помощью Gemini) обходит
GPT-4o-mini-tts на английском и китайскомОбсуждение
👍 первая open-source модель в audio, обученная на таком масштабе данных
👍 минимальный gap между MMLU в режиме text-to-text (72.5) и speech-to-speech (69.1)
👍 результат на Big Bench Audio уровня первых версий GPT-4o realtime
😐 нет описания пайплайна данных / распределения языков
😐 ни одного ablation study
😐
3.76% Word Error Rate на LibriSpeech-test-clean после post-train'а на 100B токенах ( ~4.5M часов речи). У мультиязычного Whisper-large-v2 — 2.7%