
code | demo
На конференции было представлено около 10 работ по speech-to-speech диалоговым моделям на основе LLM, если не считать обзорные доклады. Одной из самых интересных нам показалась работа Nvidia, которую разберем в этом посте
Модель
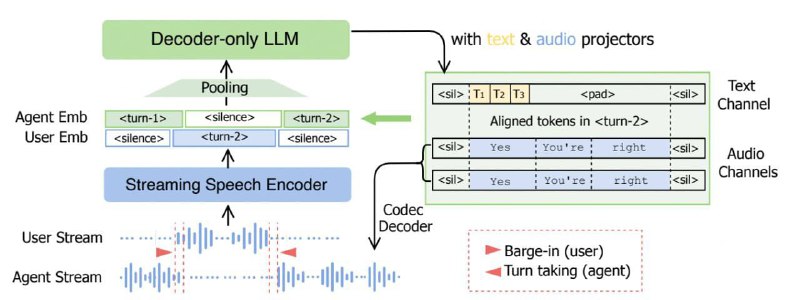
Для понимания входного аудиопотока авторы используют стриминговый энкодер аудио (FastConformer-CTC 100M) с контекстом в будущее 80 миллисекунд.
В качестве основной модели выбрали TinyLlama-1.1B-chat.
Для генерации речи используют NanoCodec — токенизатор аудио от Nvidia, который также был представлен отдельным докладом. Его основные особенности:
* использование FSQ и независимых кодбуков — в них нет иерархической структуры. Следовательно, их можно предсказывать параллельно из одного скрытого состояния LLM без задержки
* высокое качество при низком битрейте. Авторы экспериментируют с bitrate=0.6kbps и 12.5 токенами для кодирования одной секунды аудио
Для генерации токенов аудио расширяют словарь LLM + добавляют 4 головы для генерации токенов по каждому из кодбуков.
Как соединяют все вместе:
* на каждом шаге из одного скрытого состояния llm генерируется текстовый токен + 4 аудио токена из каждого кодбука
* LLM обуславливается на сгенерированные токены + входной сигнал от пользователя: эбмеддинг текстового токена складывается с эмбеддингами для генерируемых аудиотокенов и непрерывным эмбеддингом от пользователя. Таким образом, LLM говорит и слышит одновременно
* между генерируемыми текстовыми и аудио токенами нет выравнивания по времени: токены генерируются независимо, в текстовом канале токены кончаются раньше, после этого модель отдает паддинги. Авторы упоминают, что пробовали выравнивать генерируемые токены на уровне слов, но не увидели улучшений
Данные
Авторы используют исключительно синтетические данные:
* внутренний датасет распознавания речи → генерация ответа ассистента по текстовой транскрипции → синтез речи → 20 тысяч часов
* внутренний multi-turn текстовый SFT датасет → синтез речи → 3 тысячи часов
* Llama-3.1-70B-Instruct → 4-turn текстовые диалоги → синтез речи → 3.3 тысячи часов
* MS MARCO + Alpaca → TTS → 400 часов
Для обучения необходимы двухканальные аудиозаписи: реплики пользователя и реплики ассистента выравниваются с помощью семплированной тишины. Между окончанием пользовательской реплики и началом речи ассистента добавлялась задержа 640 миллисекунд.
Также авторы симулировали перебивания со стороны пользователя:
* из single-turn QA-пар составляли multi-turn с помощью конкатенации
* при конкатенации допускали перекрытие между вторым запросом пользователя и первым ответом ассистента
* в таком случае канал ассистента содержал ответ еще 640 миллисекунд, а дальше заполнялся тишиной
Оценка качества
Качество оценивают только in-domain: используют часть сгенерированных данных, которые не участвовали в обучении.
* Качество ответов: GPT score между референсом и распознанной репликой ассистента
*
Barge-in Latency — время между началом речи пользователя и прекращением речи ассистента*
1st Response Latency — время между окончанием запросом пользователя и началом ответа ассистента* Качество генерирумой речи: UTMOS
Результаты
👍 лучше популярной Moshi: GPT score ответов выше, UTMOS генерируемой речи выше, Barge-in Latency ниже
👍 без огромного претрейна, multi-stage обучения и миллионов часов речи
👍 персонализацией NanoCodec (дообучение на 21k часов целевого спикера) удалось снизить битрейт в 2 раза и улучшить качество
😐 только in-domain оценка качества
😐 деградация качества ответов по сравнению с исходной LLM: на Alpaca QA, UltraChat GPT Score упал с 6-5 до 3-3.5
😐 1st Response Latency: 0.72-0.92 секунды