TGViewer
Channel Public Channel
GetAnalyst - Навыки • Системный анализ • Бизнес-анализ

GetAnalyst - Навыки • Системный анализ • Бизнес-анализ

@getanalysts

Разбор задач на проектирование систем 🚀 Канал для системных аналитиков, бизнес-аналитиков, тестировщиков и менеджеров проектов

Админ @getanalyst
Сайт https://getanalyst.ru
Чат t.me/getanalystchat
Начинающим в IT @getanalyststart
Subscribers
22.5K
Photos
2.6K
Videos
98
Links
1.5K

Showing posts older than #3570 · Back to latest

Older Posts 16 shown
Post #3568 3.97K
😰 От Junior в 7 раз чаще требуют навыков Middle и Senior...

Это не моё ощущение. Это результат исследования PwC — одной из крупнейших консалтинговых компаний в мире.

В 2026 они разобрали больше 1 млрд вакансий и подтвердили этот факт на 2,4 млн junior-вакансий в США.


❗️При этом ИИ не отменяет Junior-позиции.
Но поднимает планку входа в профессию и требования к грейдам в целом.


Причина логичная. ИИ всё лучше делает то, на чём раньше учились начинающие:

▫️ собрать первый черновик документа
▫️ структурировать требования
▫️ написать SQL
▫️ разобрать API
▫️ построить диаграмму
▫️ найти варианты решения


👉 Ценность специалиста смещается
от «умею сделать»
к «понимаю, ЧТО нужно сделать, могу проверить результат и принять решение»


Для аналитика попросить ИИ спроектировать REST API или написать Use Case недостаточно.

Нужно самому уметь ответить:

✅ какие сценарии он пропустил
✅ корректно ли спроектирован контракт API
✅ что будет при ошибках
✅ где нарушена бизнес-логика
✅ подходит ли решение вашей архитектуре

Если не можешь это проверить — ты не контролируешь результат, а угадываешь вместе с ИИ 🤷‍♀️


LinkedIn фиксирует тот же сдвиг с другой стороны.

Растут требования:
1️⃣ к владению AI-навыками,
2️⃣ к мягким навыкам (софт-скиллам) — работа со стейкхолдерами, коммуникация, лидерство.


Я же продолжаю повторять:
👉 ИИ не заменит аналитика.
Но аналитик с ИИ будет всё сильнее выигрывать у аналитика без него.


👉 А фундаментальные знания — не менее, а более важны.
Ведь теперь надо понимать, где накосячил ИИ.
Потому что его ответы всегда красивы, но далеко не всегда верны.


📚 Источники:
PwC — Global AI Jobs Barometer 2026
LinkedIn — Skills on the Rise 2026


А вы уже видите это на собеседованиях или в требованиях к джунам? Делитесь опытом в комментариях👇


#AI_for_analysts

📱 Tg | 💙 ВК | 💬 Max
  • ❤ 29
  • 👍 4
  • 💯 1
Post #3567 3.72K
🟢 Доступ к обучению открыт: практика по ИИ и REST API 🟢

Полноформатное обучение, в котором вы практикуетесь с 10+ инструментами и погружаетесь в REST API и ИИ.


💙 Как ИИ меняет работу аналитика: практика на задачах с REST API
🗓 Доступ до 11 августа

👉 План:
1. Основы REST API — что должен знать системный аналитик
2. Для каких задач аналитику нужен ИИ при работе с API
3. Обзор ИИ-инструментов: Qwen, ChatGPT, Claude и другие
4. Практика настройки ИИ-агента для работы с задачами на API
5. Погружение в REST API на практике через Postman и Insomnia
6. Документирование REST API через Swagger

📄 Инструкция по подготовке
🕘 Время на обучение: 4.5 часа


🔗 Получить доступ*
*Если зарегистрированы, то доступ уже направили
сегодня утром и ранее, в подтверждении регистрации.


Вдохновляющих выходных!


📱 Tg | 💙 ВК | 💬 Max
  • ❤ 12
  • 🔥 3
  • 👍 2
Post #3566 3.65K
🧐 URI vs URL: кажется, что это одно и то же. Но в чём разница? 🧐

URI и URL мы встречаем постоянно:

▫️ в адресной строке браузера
▫️ в документации к API
▫️ в постановках задач API: Base URL, URI, endpoint

На первый взгляд, всё это одно и то же: просто «ссылка», «эндпоинт» или «адрес метода».

👉 Да, URI и URL часто используют как взаимозаменяемые понятия. Но технически это не одно и то же.


Коротко:
🌟 URL — это один из видов URI.
🌟 Каждый URL является URI, но не каждый URI является URL.


А ещё существует URN.


Разберёмся на простых примерах 👇


1️⃣ URI — идентификатор ресурса

Uniform Resource Identifier

Это общее понятие: строка, которая идентифицирует какой-либо ресурс.

Примеры URI:

+ https://api.example.com/v1/products/42
+ mailto:user@example.com
+ urn:isbn:9783161484100

👉 Все три записи идентифицируют ресурсы, но делают это по-разному.


2️⃣ URL — адрес ресурса

Uniform Resource Locator

Он не только идентифицирует ресурс, но и показывает, где он находится и как к нему обратиться.

Например:

https://api.example.com/v1/products/42
По этому адресу клиент может отправить HTTP-запрос и получить данные о товаре.

https://getanalyst.ru/about
Это URL, который вы вводите в браузере, чтобы перейти на страницу "О нас" на веб-сайте с доменом "
getanalyst.ru".

Здесь:
▫️ https — схема обращения
▫️ api.example.com и getanalyst.ru — домены
▫️ /v1/products/42 и /about— пути к ресурсам

👉 Поэтому данные строки являются одновременно:
✅ URI — потому что идентифицирует ресурс
✅ URL — потому что указывает его адрес и способ обращения


3️⃣ URN — имя ресурса

Uniform Resource Name

Он идентифицирует ресурс по устойчивому имени, но не указывает, где этот ресурс находится.

Например:
urn:isbn:9783161484100
urn:issn:2049-3630

Это уникальные идентификаторы книги.

Книга может продаваться в разных магазинах и храниться в разных библиотеках, но её ISBN/ISSN от этого не изменится.

URN может идентифицировать не только книгу. Например, <urn:uuid:...> задаёт устойчивый идентификатор объекта. При этом URN не сообщает, на каком сервере находится объект и как его получить.

👉 Итого по URN:
✅ является URI
❌ не является URL: сам по себе не указывает сетевой адрес ресурса и способ его получения


Главное, что нужно запомнить:

✅ URI — общее понятие: идентификатор ресурса
✅ URL — URI, который показывает адрес ресурса и способ обращения
✅ URN — URI, который задаёт устойчивое имя ресурса, но не указывает адрес

В REST API мы преимущественно работаем с HTTP(S) URL.

А слово endpoint обычно используют для обозначения точки обращения к API: сочетания HTTP-метода (GET/POST/PUT...) и адреса ресурса.


Теперь, увидев в постановке задачи Base URL, URI и endpoint, вы точно знаете, почему это не три названия одного и того же 😉


——-
P.S. А к чему относится "mailto:user@example.com"?
——-

#AI_for_analysts #RestApiGA

📱 Tg | 💙 ВК | 💬 Max
  • ❤ 23
  • 👍 14
  • 👌 2
Post #3564 3.54K
❤️‍🔥🤖 ИИ-агенты для аналитика: к концу практикума можно стать сеньором [8-11 августа] 🤖❤️‍🔥

«к концу практикума можно стать сеньором» 😄

Так один из участников комментировал количество инструментов и возможностей, которые мы разбираем за одно занятие.

Конечно, за 4 часа сеньором не стать.

Но можно настроить ИИ-агентов, исследовать реальные API и научиться использовать нейросети так, чтобы они ускоряли работу, а не добавляли проблем.


❤️‍🔥 ИИ для работы аналитика: практика на задачах с REST API

🗓 Доступ только с 8 по 11 августа

📹 Формат: в записи
🕐 На обучение: 4 часа
🟢 Участие бесплатное

🔗 Зарегистрироваться


👉 На практике вы:

➕ настроите ИИ-агента для работы с API-задачами
➕ исследуете запросы к реальным API через Postman и Insomnia
➕ разберётесь, как работать со Swagger и OpenAPI-документацией
➕ поймёте, какие задачи можно передавать ИИ, а где необходима проверка аналитика

👉 Разберём 10+ инструментов для работы с ИИ и API:

✔️ Qwen
✔️ ChatGPT
✔️ Claude
✔️ Postman
✔️ Insomnia
✔️ Swagger
✔️ и другие


👉 Этот практикум — самостоятельное полноформатное занятие, которое можно пройти и использовать отдельно от наших программ.

Он также является вводным занятием к практическим программам:

🎓 Проектирование REST API
Старт 11 августа
Завтра — последний день предзаписи по специальным условиям.

🎓 ИИ-Акселератор
Старт 29 августа
Для тех, кто хочет глубже освоить ИИ для рабочих задач.


——

P.S. Технические или организационные вопросы:
@getanalyst или info@getanalyst.ru
  • ❤ 15
  • 😁 1
Post #3562 3.87K
getanalyst-restapi-designer-skill.zip34.5 KB REST API - шаблон требований [GetAnalyst].pdf575.8 KB
🤖🔖 Бесплатный AI-скилл от GetAnalyst для постановки задач на REST API + шаблон требований 🔖🤖

Пока кто-то продаёт AI-скиллы для аналитиков, я отдаю свои бесплатно 🙌


Сегодня делюсь скиллом (навыком) по проектированию REST API.

Скилл превращает бизнес-сценарий, Use Case, макет или несколько строк про вашу задачу в полноценную постановку задачи на один REST API-метод.


👉 Что он делает:

✔️ задаёт уточняющие вопросы, если данных недостаточно
✔️ проектирует URI, параметры, headers и JSON
✔️ описывает валидации, ответы и ошибки
✔️ формирует пошаговый алгоритм Backend
✔️ добавляет маппинг с БД
✔️ учитывает кэширование, НФТ, логирование и мониторинг
➕ спорные решения и допущения выносит перед постановкой, не засоряя сам документ комментариями


📝 Самый актуальный и полный шаблон требований GetAnalyst и куча обучающих примеров были использованы при создании скилла.

Примеры постановок задач по этому шаблону показывала в этом посте.


👉 К посту прикрепляю:

🤖 скилл для Claude / OpenAI
📝 PDF-шаблон постановки задачи на REST API метод

🔗 Инструкция по установке и использованию скилла в ChatGPT Plus и Claude


👉 Также скилл можно использовать в:

+ Gemini CLI — именно CLI, не обычный Gemini в браузере
+ GitHub Copilot (например, в VS Code)
+ Cursor
+ и других инструментах.


Скачивайте, устанавливайте и используйте бесплатно ❤️‍🔥


#AI_for_analysts #RestApiGA

📱 Tg | 💙 ВК | 💬 Max
  • ❤‍🔥 25
  • 🔥 7
  • ❤ 6
Post #3560 3.75K
QUERY_products_Поиск_по_каталогу_товаров_Пример_требований_GetAnalyst.pdf2.3 MB POST_products|search_Поиск_по_каталогу_товаров_Пример_требований.pdf1.8 MB
🔥 QUERY vs POST: 2 примера постановки задачи на поиск с десятками фильтров 🔥

Что делать, если параметров фильтрации и сортировки слишком много для передачи в URL?


Раньше для таких сценариев часто использовали:
POST /products/search

Фильтры, сортировку и пагинацию передавали JSON-объектом в теле запроса.


Теперь появился отдельный HTTP-метод для безопасного и идемпотентного поиска с телом запроса, вместо "костыля" с POST:
QUERY /products


🔵 К посту прикрепляю две полноценные постановки задачи - выгрузки из Confluence:

1️⃣ Поиск товаров через POST /products/search — вариант, подготовленный до появления QUERY.

2️⃣ Поиск товаров через QUERY /products — обновлённый пример с новым HTTP-методом (в этом документе также можно посмотреть, как супер-подробно описать требования к кэшированию результатов поиска).


💾 Скачивайте оба файла и сравнивайте:

✔️ как изменился endpoint
✔️ как передаются фильтры
✔️ как описывается контракт метода
✔️ какие требования важно зафиксировать для Backend

Когда на проекте появится поиск с десятками фильтров, у вас уже будет готовый образец постановки задачи — и для привычного POST, и для нового QUERY.


🔖 Обязательно сохраняйте этот новый образец требований по REST API в личный архив и поддержите пост ❤️🔥, если это то, что вам актуально


#RestApiGA #FarmFreshGA


📱 Tg | 💙 ВК | 💬 Max
  • ❤ 30
  • 🔥 17
Post #3559 3.68K
🤖 [8 августа] ИИ может подготовить черновик требований на 70%+, если вы умеете с ним работать. Но... 🤖

Но в оставшихся 30% могут скрываться выдуманные поля, несуществующие методы и сценарии, которых нет ни в требованиях, ни в самой системе.

Как использовать ИИ так, чтобы он действительно ускорял работу аналитика, а не добавлял новые ошибки?

Разберём на бесплатном практикуме 👇


🤖 ИИ для работы аналитика:
практика на задачах с REST API

🗓 Доступ с 8 по 11 августа

📹 Формат: в записи — смотрите в удобное время
🕐 Время на обучение: 4 часа
🟢 Участие бесплатное

🔗 Зарегистрироваться


На практике вы:

✔️ познакомитесь с 10+ инструментами для работы с ИИ и API
✔️ настроите ИИ-агента для работы с API-задачами
✔️ исследуете запросы к реальным API через Postman и Insomnia
✔️ разберётесь, как работать со Swagger и OpenAPI-документацией
✔️ поймёте, какие задачи можно передавать ИИ, а где необходима проверка аналитика


Практикум подойдёт системным, бизнес- и начинающим аналитикам, которые хотят увереннее работать с REST API и современными ИИ-инструментами.
Всем, кто устал делать руками то, что уже умеет делать ИИ


Доступ откроется уже в эту субботу, 8 августа! 🔔

----—
P.S. Технические или организационные вопросы? Пишите @getanalyst или info@getanalyst.ru
  • ❤ 12
  • 👍 4
Post #3557 4.1K
GetAnalyst_Задания_REST_API_к_собеседованию_СА.pdf113.4 KB GetAnalyst_Задания_+_ответы_REST_API_к_собеседованию_СА_pdf.pdf551.9 KB
📚🤖 AI-ассистент для подготовки к собеседованию по REST API (и не только) 📚🤖

Вопросы и задачи с собеседований — это всегда отличный способ размяться перед реальным интервью и вспомнить то, что давно не использовали в работе.

Прикрепила к посту два файла:
1. Только вопросы - файл "Задания REST API"
2. Эти же вопросы, но с ответами - файл "Задания + ответы REST API"


🤖 Инструкция по подготовке к интервью с помощью AI:

👉 1. Скачайте pdf-файл с ответами из этого поста (второй по порядку).


👉 2. Откройте любой из предложенных ИИ и войдите в аккаунт,
используя свою учетную запись Google.

https://chatgpt.com/ - лучше платный, бесплатный в последнее время ведёт себя плохо

https://claude.ai/ - можно бесплатно, но есть лимиты

https://gemini.google.com/ - можно бесплатно, но есть лимиты, которые не сильно портят качество

https://qwen.ai/ - полностью бесплатный, но хуже память (контекстное окно), может забыть о чем говорили и суть документов через 15-20 сообщений

https://chat.deepseek.com/ - полностью бесплатный, но память еще хуже чем у qwen, слабее qwen


👉 3. Откройте новый диалог (New Chat в левом меню).


👉 4.1. Загрузите файл.
В зоне ввода текста есть иконка "+" или "скрепка".
Нажмите на неё и появится иконка скрепки с надписью "Добавить файл" (Add photos & files").

👉 4.2. Вставьте промпт:

Представь, что ты ведущий системный аналитик с опытом более 10 лет в IT. Ты хочешь нанять senior системного аналитика к себе в команду и я пришёл к тебе на техническое собеседование.

Ты строгий и занудный, требуешь четких ответов с примерами.

Используй файл, который я добавил, и на его основе задавай мне по одному случайному вопросу.
Чередуй вопросы по теории и практические задания, задачи, как на реальных проектах.
Старайся идти глубже и давать связанные вопросы с подвохами.
Вопросы также можно задавать в других формулировках по сравнению с документом.

После того, как я отвечу, давай оценку моим ответам по 10-бальной шкале по критериям: точность ответа, понимание вопроса. Поясняй каждый балл и предлагай как можно было бы улучшить мой ответ.

Каждый раз, когда я буду писать "следующий вопрос", ты можешь задавать мне следующий вопрос из моего документа или придумывать аналогичные, с подобными задачами.

Сразу после этого сообщения можешь задать мне первый вопрос.


👉 5. Ваше собеседование началось.
Отвечайте на вопросы.

❗️ Не печатайте текст на теоретические вопросы, а говорите ответы голосом, где возможно!
Используйте иконку "микрофон", чтобы записывать свои ответы и отдавать их на проверку Искусственному Интеллекту.
Получайте обратную связь от ИИ и улучшайтесь 😌

+ В помощь на собеседования:
JSON Editor Online


✅ Открытая база вопросов и заданий с собеседований на СА
Больше вопросов и ответов по другим темам, чтобы проверить себя и подготовиться к успешному техническому интервью
🔗 База вопросов для СА
Скачиваете в виде PDF-страницы и прикладываете в ИИ.
Либо даёте ссылку на неё в промпте из п.4.2 и готовитесь к собеседованию не только по REST, но и по другим темам.


Сохраняйте и пользуйтесь.
Сейчас или в будущем 🤝


🔥 и 🩷 приветствуются))


#RestApiGA #AI_for_analysts
  • ❤ 52
  • 🔥 23
Post #3556 4.27K
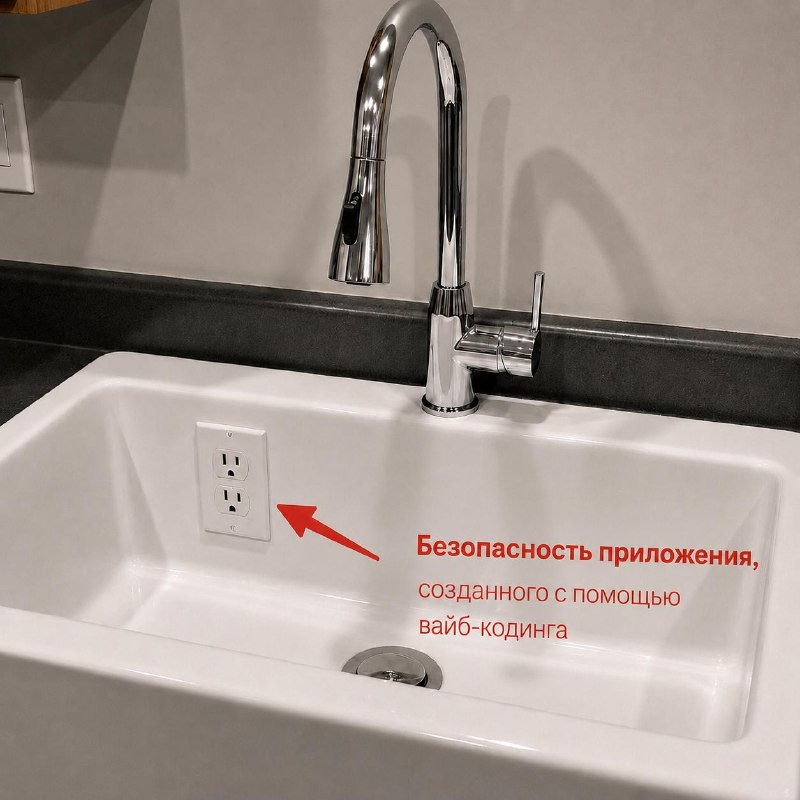
Как вайб-кодить с ИИ безопасные приложения без навыков программирования: наглядный пример 🤩
  • 🤣 59
  • 💯 7
  • 😁 6
Post #3555 4.46K
⚡️ [8-11 августа] ИИ для работы аналитика: практика на задачах с REST API ⚡️

Пока один аналитик вручную разбирает требования, API-документацию, JSON и ошибки, другой передаёт часть этой работы ИИ — и получает результат в несколько раз быстрее.

Но просто написать в ChatGPT «сделай требования» недостаточно.

Нужно уметь правильно поставить задачу, передать контекст и проверить результат. Этому и будем учиться на практикуме на следующей неделе 👇


🤖 ИИ для работы аналитика:
практика на задачах с REST API

🗓 Доступ с 8 по 11 августа

📹 Формат: практикум в записи, смотрите в удобное время
🟢 Участие бесплатное


🔗 Зарегистрироваться


На практике разберём:
▫️ какие задачи аналитика можно передать ИИ;
▫️ как настроить ИИ-агента для работы с API;
▫️ как выполнять и исследовать запросы через Postman и Insomnia;
▫️ как читать и создавать с ИИ Swagger-документацию (OpenAPI).


В результате вы:
✅ настроите ИИ-агентов под свои задачи
✅ выполните реальные API-запросы
✅ поймёте, как ускорять работу с REST API без слепого доверия к ИИ


Практикум будет полезен системным, бизнес- и начинающим аналитикам, которые хотят увереннее работать с API и современными ИИ-инструментами.


ИИ не заменит аналитика, который умеет думать.

Но аналитик с ИИ будет востребованнее того, кто продолжает всё делать вручную
🚀


Присоединяйтесь с 8 по 11 августа!


——
Вопросы? Пишите @getanalyst или info@getanalyst.ru
  • ❤ 30
  • 🔥 5
Post #3554 3.8K
🔥 10 спорных вопросов по REST API, ответы на которые важны для работы и собеседований 🔥 [ЧАСТЬ 2]

Проверьте себя 👇
Сначала ответьте на вопросы, потом раскройте ответы.

Считайте итоговый балл вместе с частью 1 в предыдущем посте.


7️⃣ Может ли POST быть идемпотентным?

Конкретная операция — может, если сделать идемпотентность искусственно, через алгоритм работы метода и проверку дубликатов.

Сам метод POST по стандартной семантике идемпотентным не считается (подробнее
тут).

Например, повторное создание платежа можно защитить с помощью:

▫️ Idempotency-Key - ключа идемпотентности
▫️ уникального идентификатора операции
▫️ бизнес-ключа заказа, который будет проверяться
▫️ проверки ранее созданного результата

POST /payments
Idempotency-Key: payment-order-123

При повторном запросе сервер не создаёт второй платёж, а возвращает результат первой операции.


Но эту гарантию необходимо явно описать в контракте API и спроектировать в алгоритме.

Без этого операция выполнится несколько раз и создаст несколько платежей.


8️⃣ Чем статус HTTP-401 отличается от 403?

401 Unauthorized — клиент не прошёл аутентификацию:
▫️ неверная пара логин+пароль
▫️ токен отсутствует
▫️ токен недействителен
▫️ токен истёк

403 Forbidden — сервер понял запрос, но не разрешает выполнить операцию из-за отсуствия прав доступа. Это ошибка авторизации.

Например, пользователь авторизован, но у него нет роли администратора.

В отдельных системах вместо 403 могут намеренно возвращать 404 (не найдено, нет данных), чтобы не раскрывать существование защищённого ресурса.


9️⃣ PUT используется только для обновления существующего объекта?

Нет.

PUT означает создание или полную замену состояния ресурса по известному клиенту URI.

Пример:
PUT /users/9991112233 - создать или изменить пользователя

В зависимости от контракта сервер может:

▫️ заменить существующий ресурс
▫️ создать его, если ресурса ещё нет
▫️ запретить создание и вернуть ошибку

Для частичного изменения обычно используется PATCH.


🔟 Некорректное значение поля: 400 или 422?

Клиент отправил корректный JSON:


POST /users
Content-Type: application/json

{
"email": "anna@example.com",
"age": -5
}


Какой HTTP-статус вернуть?


Возможны оба варианта в зависимости от принятого стандарта API внутри проекта.

400 Bad Request — неверный формат — часто используют для любых ошибок входных данных:

▫️ некорректный JSON
▫️ отсутствующее обязательное поле
▫️ неправильный формат
▫️ недопустимое значение


422 Unprocessable Content — ошибка бизнес-логики — точнее показывает, что:

▫️ JSON синтаксически корректен
▫️ сервер понял структуру запроса
▫️ но не может обработать данные из-за нарушения правил валидации


Например, возраст не может быть отрицательным.
Это может быть как ошибкой формата, так и ошибкой бизнес-логики.

Главное — не выбирать код заново для каждого метода, а зафиксировать единый подход в корпоративном гайде по API.


=========================

Сколько ответов у вас совпало?

😱 0–3
👍 4–6
🔥 7–8
🦄 9–10

Если есть вопросы или нужны доп. примеры, буду рада помочь разобраться в комментариях.

=========================

📚 Дополнительный разбор спорных вопросов по REST API
Статья была опубликована в 2023 году, поэтому нового метода QUERY в ней ещё нет. Но остальные вопросы всё ещё регулярно встречаются на проектах и собеседованиях.


Сохраняйте, точно пригодится перед следующим техническим интервью 💙


#RestApiGA
  • 🦄 19
  • ❤‍🔥 11
  • 🔥 8
  • ❤ 4
Post #3553 3.73K
🔥 10 спорных вопросов по REST API, ответы на которые важны для работы и собеседований 🔥 [ЧАСТЬ 1]

Проверьте себя 👇
Сначала ответьте на вопросы, потом раскройте ответы.


1️⃣ Можно ли использовать POST для получения данных?

Да.

1) Много фильтров для GET

Когда условий поиска много, URL перегружается query-параметрами и может стать слишком длинным:

GET /products?brand=Apple&category=phones&priceFrom=500&priceTo=1500&ratingFrom=4...

Фильтры удобнее передать JSON-объектом в теле запроса.

Но семантика тела для GET не определена: некоторые серверы, прокси и другие промежуточные компоненты могут его не поддержать или проигнорировать.

Поэтому для сложного поиска традиционно используют POST.

Пример на поиск продуктов в каталоге:

POST /products/search
Content-Type: application/json

{
"brands": ["Apple", "Samsung"],
"ratingFrom": 4,
"priceTo": 1000
}


Но POST по стандартной семантике не является безопасным и идемпотентным методом, поэтому обоснование такого решения необходимо явно описать в API-документации.

С июня 2026 года для таких сценариев стандартизирован новый HTTP-метод QUERY:
QUERY /products

2) Для асинхронного получения данных.
Например, для отчетов:
POST /report - запускает асинхронную задачу на сбор данных для отчета
GET /report/{id} - получаем результирующие данные или файл отчета


2️⃣ Можно ли передать JSON-тело в GET?

Технически тело в GET передать можно, но его использование не ожидается.

Клиенты, серверы, прокси или API Gateway могут:

▫️ проигнорировать body
▫️ удалить его
▫️ отклонить запрос
▫️ обработать его не так, как ожидается

Поэтому передавать фильтры в body метода GET не стоит, особенно для публичного или интеграционного API.

Для передачи любых данных в GET используйте query-параметры, POST или новый QUERY.


3️⃣ Можно ли сделать все методы API через POST?

Технически — да.
Рекомендуется — нет.

Такой API может работать, но клиентам может быть сложнее понять назначение операций:

▫️ где чтение данных
▫️ где создание
▫️ где полная или частичная замена
▫️ и т.д.

Это будет скорее HTTP API с RPC-подобным дизайном, чем ресурсно-ориентированный REST API.

❗️ Исключение — если такой подход уже принят в действующем API. Тогда важнее сохранить единообразие или версионировать изменения, чем добавить один «идеальный» PATCH среди сотни POST.

Примеры:
https://dadata.ru/api/
https://www.unisender.com/ru/support/api/common/bulk-email/


4️⃣ Какой код должен вернуть успешный POST: 200 или 201?

Зависит от логики и результата выполнения.

▫️ 201 Created — создан новый ресурс, т.е. новая запись в БД [POST /products — создать продукт]

▫️ 200 OK — запрос обработан, но отдельный ресурс не создавался [POST /products/search — искать продукт, если много фильтров отправили в JSON]

▫️ 202 Accepted — запрос принят, но обработка ещё не завершена, задача поставлена в очередь [POST /reports — создать задачу на генерацию отчета]

▫️ 204 No Content — операция выполнена успешно, но возвращается пустое тело ответа.

Сам HTTP-метод не определяет единственный допустимый код ответа.
На практике в REST API могут вообще все HTTP-200 быть для успеха.


5️⃣ Запрос с фильтром не нашёл ни одного объекта. Возвращать 200 OK или 404 Not Found?

GET /products?brand=Unknown

Обычно:
200 OK
[]

или лучше:
200 OK
{
"limit": 10,
"offset": 0,
"count": 0,
"products": []
}

Коллекция /products существует, запрос корректен, но подходящих элементов нет.

404 Not Found логичнее использовать, когда не найден конкретный ресурс:
GET /products/123

Главное — зафиксировать единый подход в гайде по дизайну API и контракте метода.


6️⃣ DELETE считается идемпотентным, если первый запрос вернул 204, а повторный — 404?


Да.

Идемпотентность не требует, чтобы повторные запросы возвращали одинаковые ответы.

Она означает, что итоговое ожидаемое состояние системы после одного и нескольких одинаковых запросов совпадает:

DELETE /users/123

После первого запроса пользователя нет.
После второго пользователя по-прежнему нет.

Ответы могут отличаться, но итоговое состояние одинаковое.


Продолжение ➡️

#RestApiGA
  • ❤‍🔥 30
  • ❤ 19
  • 🔥 2
Post #3552 3.41K
🔵 ETag и 304 Not Modified — недостающие строчки в 90% ТЗ на справочники через GET 🔵

Возьмём справочник категорий интернет-магазина.

Он меняется от силы раз в месяц, но запрашивается при каждом открытии каталога сотнями тысяч пользователей:


GET /api/v1/categories


Если не описать кэширование, Backend будет снова и снова возвращать один и тот же JSON.

❗️ Даже когда категории не изменились.

На масштабе это превращается в тысячи лишних запросов, повторные обращения к БД и передачу одинаковых данных по сети.

Это незаметная деградация производительности и кража ресурсов от более важных API-запросов.


👉 Как оптимизировать такой метод через требования, а не через «давайте добавим серверов»?

✅ Заголовки (headers): Cache-Control, ETag, If-None-Match


1️⃣ Backend возвращает данные и правила кэширования

В ответ на запрос списка категорий приходит:


HTTP 200 OK

Content-Type: application/json
Cache-Control: public, max-age=3600
ETag: "categories-v42"

{
"categories": [...]
}


Что здесь происходит:

▫️ max-age=3600 — ответ считается актуальным в течение 3600 секунд (1 час)
▫️ public — ответ разрешено хранить не только клиенту, но и промежуточным кэшам
▫️ ETag — идентификатор текущей версии представления справочника

Кэш сохранён на сервере. Например в Redis.

👉 Клиент должен сохранить список категорий локально — в своём кэше.


2️⃣ Пока кэш свежий, новый запрос на Backend не нужен

В течение часа клиент использует ранее сохранённый ответ.

Backend, API Gateway и БД в обработке такого обращения не участвуют.
Именно Cache-Control позволяет не отправлять повторный запрос вообще.


3️⃣ После истечения `max-age` клиент проверяет актуальность данных


GET /api/v1/categories

If-None-Match: "categories-v42"


Клиент передаёт ранее полученный ETag в заголовке If-None-Match.


4️⃣ Если справочник не изменился, Backend возвращает:


HTTP 304 Not Modified

Cache-Control: public, max-age=3600
ETag: "categories-v42"


Тело ответа не передаётся.

Клиент продолжает использовать сохранённый JSON, а срок его свежести обновляется.


5️⃣ Если справочник изменился, Backend возвращает новый ответ:


HTTP 200 OK

Content-Type: application/json
Cache-Control: public, max-age=3600
ETag: "categories-v43"

{
"categories": [...]
}


Клиент сохраняет новые данные и новый ETag в локальном кэше.


📌 Что системному аналитику описать в требованиях:

▫️ допускается ли кэширование ответа
▫️ срок актуальности кэша — max-age
▫️ где разрешено хранить ответ — public или private
▫️ как формируется и обновляется ETag
▫️ поддержку заголовка If-None-Match
▫️ ответы 200 OK и 304 Not Modified
▫️ сохранение клиентом тела ответа и ETag
▫️ правила инвалидации кэша при изменении данных


⚠️ Важно

Необязательно каждый раз собирать полный JSON и рассчитывать от него хэш.
Иначе Backend может сначала выполнить тяжёлый запрос к БД, сформировать весь ответ и только потом понять, что данные не изменились.

Для справочников эффективнее хранить отдельную версию данных и обновлять её при изменениях.


📌 Правило

Часто вызываемый GET-метод с редко изменяемым и пригодным для кэширования ответом — кандидат на связку:
Cache-Control + ETag + If-None-Match

✅ Cache-Control сокращает количество запросов к Backend.

✅ ETag сокращает повторную передачу неизменившихся данных после истечения срока свежести.


И это уже не одна «волшебная строчка», а полноценная политика кэширования, которую аналитик должен спроектировать в требованиях к API.

#RestApiGA
  • ❤ 25
  • 🔥 12
  • ❤‍🔥 2
  • 👍 2
Post #3551 3.23K
💥 Открыли предзапись на «Дизайн REST API» — новый поток с 11 августа 💥

Умеете описывать небольшие доработки на методы API, чуть поправить json, но теряетесь, когда нужно спроектировать метод с нуля?

За 10+ лет работы я много раз видела, как такие пробелы в понимании обнаруживаются на собеседованиях, во время интеграций или уже после инцидентов в проде, когда приходится срочно выпускать доработки.

Поэтому на программе REST API я делюсь с вами опытом проектирования API "от" и "до": продумывать ресурсы, контракты, бизнес-логику, ошибки, идемпотентность, безопасность, кэширование и асинхронные сценарии — и фиксировать всё это в требованиях.


📌 Дизайн REST API
🗓 Старт — 11 августа 2026

✅ 10 модулей и 70+ часов материалов и практики
✅ Проверка домашних заданий и проектных работ на всех тарифах
✅ Проект API-документации для портфолио


🎁 До 7 августа действуют условия предзаписи:
✔️ Стоимость от 39 900 ₽
✔️ Мини-курс «Проектирование архитектуры 1.0» в подарок

👉 Посмотреть программу и оставить заявку


Это не курс, который можно просто посмотреть и забыть.
✅ Это опыт, который останется с вами навсегда.

По итогам вы создадите собственный проект API-документации в Confluence, Postman и Swagger/OpenAPI, в том числе с рабочими эндпоинтами, которые можно вызвать и протестировать, а не делаете просто странички в word 🙌


Вопросы по программе? Пишите @getanalyst 💬
  • ❤ 5
Post #3550 3.84K
🚩 Двойной запрос на поиск — это не баг клиента. Это дыра в нашем ТЗ 🚩

<<Чек-лист упущенных требований>>


Типовой кейс:
маркетплейс с тысячами товаров.

Пользователь выбрал категорию, цену, бренды и рейтинг, а затем дважды нажал «Показать результаты», потому что на медленном интернете ничего не происходило.

Запрос с Frontend на Backend:


GET /products?category=electronics&brand=Apple&rating=4

или

QUERY /products
// фильтры в JSON-объекте, в body

или

POST /products/search
// фильтры в JSON-объекте, в body


GET и QUERY — безопасные и идемпотентные методы.

POST по своей HTTP-семантике не гарантирует безопасность и идемпотентность, хотя его можно сделать таким искусственно, через требования к алгоритму работы.


Но здесь есть важный момент:
❗️ Идемпотентность не означает, что Backend выполнит два одинаковых запроса только один раз.

Она означает, что повторный вызов не должен привести к дополнительному изменению состояния системы.

Поэтому два одинаковых GET- или QUERY-запроса всё равно могут дважды запустить тяжёлый поиск.


🚩 Результат:
1. Frontend отправил два одинаковых запроса.
2. Backend дважды запустил тяжёлый поиск и фильтрацию.

⚠️ = неоптимальное использование ресурсов Backend
⚠️ = проблемы для высоконагруженной системы


Разработчик говорит:
Пользователь сам дважды нажал. Что мы сделаем?

На самом деле — многое.


🚩 Что упущено в требованиях?


👉 Требования к Frontend:

▫️ После первого нажатия показать состояние «Загрузка» и блокировать повторное нажатие

▫️ Не отправлять повторный запрос, пока выполняется предыдущий запрос с теми же параметрами

▫️ При изменении фильтров отменять предыдущий запрос или игнорировать его устаревший ответ

▫️ Не заменять актуальные данные ответом на более старый запрос, который завершился позднее


👉 Требования к Backend:

▫️ Ограничить частоту запросов от одного пользователя или клиента (rate limiting)

▫️ Кэшировать результаты одинаковых запросов с заданным TTL

▫️ При необходимости объединять одинаковые параллельные запросы, чтобы поиск выполнялся один раз

▫️ Зафиксировать таймауты и максимальное время выполнения поиска

▫️ Логировать повторные запросы и превышение установленных ограничений


❗️ Идемпотентность защищает состояние системы.
✅
Кэширование, дедупликация и rate limiting защищают её ресурсы.

Это разные свойства и разные требования.

Поэтому при проектировании API недостаточно выбрать GET, POST или QUERY. Системный аналитик должен отдельно описать, как Frontend и Backend обрабатывают повторные и параллельные запросы.

Иначе этот алгоритм команда начнёт проектировать уже после первого инцидента в проде.

#RestApiGA
  • ❤ 46
  • 💯 3
Post #3543 4.1K
🌴 До сих пор не верю, что пишу этот пост с островов посреди Тихого океана.

Я завершаю отпуск на Гавайях. До переезда в США они казались мне чем-то совершенно недостижимым. Да и сейчас, если честно, сложно поверить, что я наконец-то здесь.

Ещё один штат покорён. Ещё одна мечта исполнена. Новый заряд вдохновения получен 💙


Мы слишком часто ждём выгорания, чтобы наконец разрешить себе отдохнуть.
Хотя иногда лучший способ снова захотеть что-то делать — на время перестать что-то делать.

Не забывайте отдыхать.


Кто сейчас отдыхает или уже успел отдохнуть — ставьте ❤️
У кого отпуск ещё впереди — 🔥
  • ❤ 75
  • 🔥 59
  • 🥰 6
  • ❤‍🔥 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →