
📊🔥 Grafana, Kibana, OpenTelemetry: какие инструменты наблюдаемости нужны системному аналитику? 🔎
«Посмотрите логи» — фраза, которую системный аналитик рано или поздно услышит на любом проекте.
Пользователь сообщает об ошибке. Разработчик говорит, что сервис работает. На дашборде всё зелёное. В логах одного компонента запрос принят успешно.
Но результат пользователь так и не получил.
Чтобы разобраться, недостаточно знать название Kibana или уметь открыть Grafana. Нужно понимать, какие данные собирает система, где они хранятся и как связать одну пользовательскую операцию между несколькими компонентами.
👉 Три вида данных
🔹 Метрики показывают состояние системы в числах:
▫️ количество запросов
▫️ время ответа
▫️ процент ошибок
▫️ размер очереди
▫️ загрузку CPU и памяти
▫️ количество незавершённых бизнес-операций
Метрики помогают заметить проблему и оценить её масштаб, но обычно не объясняют, что случилось с конкретным запросом.
🔹 Логи фиксируют отдельные события:
▫️ запрос получен
▫️ валидация не пройдена
▫️ сообщение опубликовано в брокер
▫️ worker начал обработку
▫️ внешний сервис вернул ошибку
▫️ операция завершена
По логам можно разбирать конкретный сценарий, если записи структурированы и содержат нужные идентификаторы.
🔹 Трассировки показывают путь запроса через компоненты системы.
Одна трасса состоит из отдельных шагов — spans. По ней можно увидеть, какие сервисы участвовали в обработке, сколько времени занял каждый вызов и на каком участке возникла ошибка.
👉 Инструменты мониторинга и логирования для наблюдения за системой:
📌 OpenTelemetry
📌 Prometheus
📌 Grafana
📌 Loki
📌 Tempo или Jaeger
📌 Elasticsearch + Kibana
📌 OpenSearch + OpenSearch Dashboards
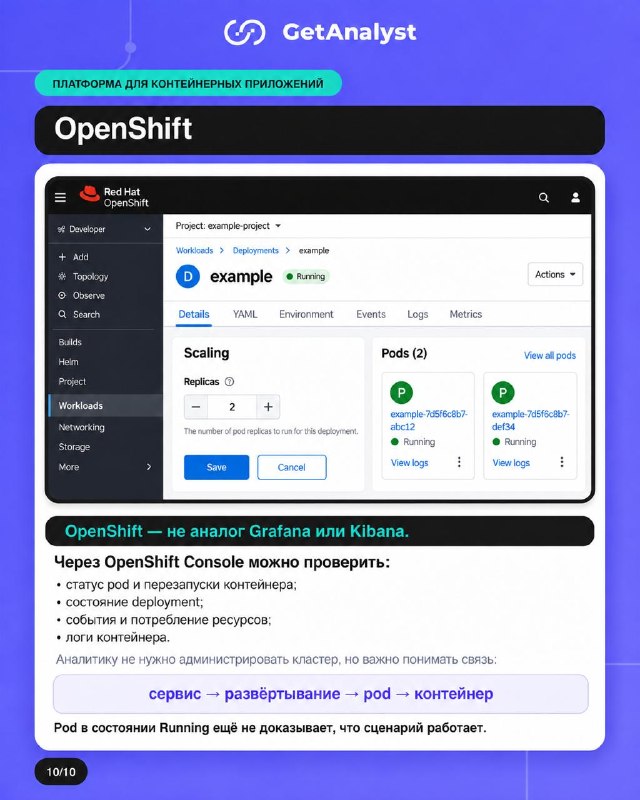
📌 OpenShift
👉 Как эти инструменты используются вместе?
Допустим, пользователи долго ждут формирования отчёта.
1️⃣ В Grafana видно, что полное время формирования отчётов выросло с двух до восьми минут.
2️⃣ В Prometheus обнаруживаем рост размера очереди и количества операций в статусе PROCESSING.
3️⃣ По operationId находим в Kibana или Loki записи конкретной операции.
4️⃣ По traceId открываем трассировку в Tempo или Jaeger и видим, что обращение worker к БД занимает большую часть времени.
5️⃣ В OpenShift проверяем состояние worker: количество экземпляров, перезапуски, события и потребление ресурсов.
Каждый инструмент отвечает на свою часть вопроса. Ни один из них не заменяет остальные полностью.
📌 Полезные подкасты для изучения:
🔗 5 метрик мониторинга, которые решают 80% проблем
в статье есть крутая схема С4 с демо архитектуры, где есть OpenTelemetry
🔗 Метрики мониторинга для системного аналитика: RPS, CPU, брокеры, SLO, SLI, SLA и SRE
в статье хорошая подборка скринов дашбордов мониторинга из Grafana для реальной системы
А подробно про каждый инструмент рассказываю на картинках к посту 🖼🔖
#АрхитектураGA #ИнтеграцииGA
Post #3741
1.12K


- 🔥 12
- ❤ 1