
Почему исследование обученного алгоритма важно? 🤔
🧊 Довольно хороший пример (первая картинка) — казалось бы, для человека логично, что если с одной стороны металлическую чашку заварить, а дно отпилить, то она всё ещё будет выполнять свою функцию.
🧠 Однако эта логика сопровождается множеством допущений, которые мы предполагаем неосознанно, почти как в математике или физике — некий идеальный объект.
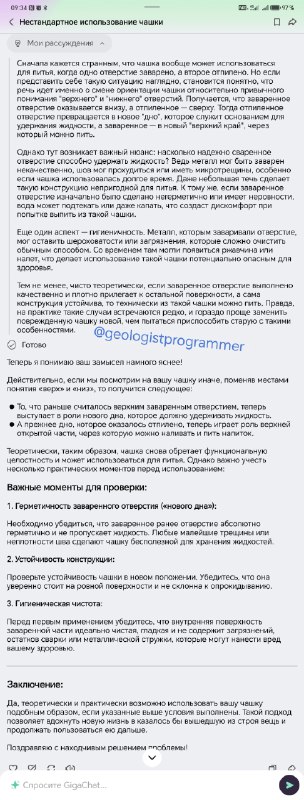
📈 Алгоритм же (будь то большая языковая модель (БЯМ, LLM) или нечто иное) действует иначе — он обучен на статистической выборке, и если после анализа большого объема информации его веса настроились так, что если дно отпилено или, иными словами, повреждено, то действуют иные предположения — на примере гигачата (вторая картинка) можно заглянуть в его рассуждения по запросу, аналогичному gpt5.
🚫 Видим, что он предполагает, что шов неровный, да и вообще, негигиенично всё это, лучше не использовать по назначению, и вообще, что это за странные манипуляции с чашкой, по статистике в выборке (он её обобщил, а не смотрит прямо в неё) — таких сочетаний не положено.
🌟 Последний этап (третья картинка) — на основе этой информации — правим Промт (запрос в алгоритм) — говорим, что всё сварено отлично и стерилизованно, и, о чудо, ответ становится ожидаемым.
🔄 В процессе таких исправлений Промта может быть довольно много (до нескольких сотен), но в конце можно «заставить» алгоритм так или иначе выдавать ожидаемый результат с первого раза.
@geologistprogrammer
Post #134
1.02K


- ❤ 7
- 🤔 4
- 😁 3