TGViewer
Channel Public Channel
Galqiwi's boredom

Galqiwi's boredom

@galbdm

dd if=/dev/galqiwisbrain of=/dev/galqiwisboredom
@galqiwi
Subscribers
705
Photos
597
Videos
62
Links
564

Showing posts older than #1822 · Back to latest

Older Posts 19 shown
Post #1821 2.13K
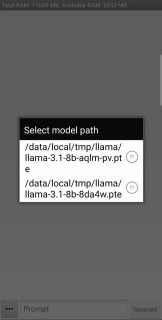
Galqiwi's boredom Наконец-то закончил работу над большим пет-проектом. Я смог запустить Llama 3.1-8b прямо в браузере на cpu с помощью нашего нового алгоритма сжатия AQLM+PV. Можно потестить демо здесь видео
сник пик новой версии -- с меньшим потреблением памяти и большим выбором моделей
  • 🔥 17
  • 🤩 2
Post #1820 2.5K

Forwarded from Роман с данными

И первая новость в обновленном канале следующая:
Мы с командой запустили свою российскую LLM Aрену.

Это такой сайт (идею скопировали у LMSYS), на котором обычные люди могут использовать разные LLM бесплатно, но взамен должны определять лучшую модель.
А мы на основе фидбека пользователей составляем рейтинг LLM и рассчитываем какая модель работает лучше всех на русском языке.

Мы попали прям в боль ML сообщества: кол-во LLM в России растет как на дрожжах, уже помимо YandexGPT, Гигачата есть и T-lite, и Вихрь, и Сайга. Новые LLM появляются каждую неделю и возникает потребность их сравнивать.

За последний месяц посещаемость проекта увеличилась в 6 раз, цитируемость бенчмарка возросла в разы, о нас написали Коммерсантъ, ITZine, Machinelearning, Tproger, ХАЙТЕК, RSpectr, hi-tech, газета.ru, Хабр, Lenta.ru.

Заходите на llmarena.ru и выбирайте лучшую модель!
  • 👍 6
  • ❤ 1
  • 😁 1
Post #1819 1.93K
Если у вас есть свободное время, анонимно потыкать в модели на llmarena.ru -- хорошее дело. Чем больше людей сравнивают модели, тем точнее рейтинг
  • ❤‍🔥 5
Post #1818 2.02K
Galqiwi's boredom Увеличил на 9% скорость работы и уменьшил размер на те же 9%. Смог сжать эмбединги в nf4 формате. Не стал жать в nf4 голову, остановился на int8, поскольку второй быстрее.
Скоро появятся маленькие модели, чтобы можно было даже на телефоне в браузере запустить.

Хотя даже сейчас можно на некоторых, люди на пикселе запускали, там много ram
  • 👍 7
  • ❤ 3
Post #1817 1.96K
Galqiwi's boredom Наконец-то закончил работу над большим пет-проектом. Я смог запустить Llama 3.1-8b прямо в браузере на cpu с помощью нашего нового алгоритма сжатия AQLM+PV. Можно потестить демо здесь видео
Увеличил на 9% скорость работы и уменьшил размер на те же 9%.
Смог сжать эмбединги в nf4 формате. Не стал жать в nf4 голову, остановился на int8, поскольку второй быстрее.
  • 🔥 13
  • ❤ 2
Post #1816 28.4K
Наконец-то закончил работу над большим пет-проектом.

Я смог запустить Llama 3.1-8b прямо в браузере на cpu с помощью нашего нового алгоритма сжатия AQLM+PV.

Можно потестить демо здесь

видео
YouTube AQLM.rs demo You can try this demo at https://galqiwi.github.io/aqlm-rs/about.html 00:00 Loading 04:40 Actual demo This was run on Macbook Pro M1. Any other laptop or phone with sufficient RAM should work too.
  • 🔥 39
  • 👍 6
  • ❤ 2
Post #1815 2.72K
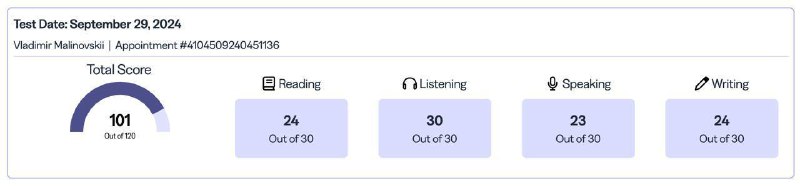
Сдал toefl на 101. Для поступления в вузы нужно 100. Очень рад
  • 🔥 57
  • 🏆 14
  • 👍 10
  • ❤ 3
  • 👏 3
Post #1814 2.44K
src
  • 🙏 6
  • ❤ 3
  • 👾 1
Post #1812 2.79K
Galqiwi's boredom Photo
Ой, случайно две одинаковые картинки прислал
  • 😁 10
  • 🔥 2
Post #1810 2.57K
  • 🤔 2
  • 👍 1
Post #1808 2.39K
Сделал сайт визитку. При поступлении на пхд, вроде, часто просят
  • 🔥 40
  • 🍌 3
  • ❤ 2
Post #1807 2.16K
Сегодня сделал первый свой коммит с описанием в несколько строчек
  • 👍 8
  • ❤‍🔥 2
Post #1805 1.77K

Forwarded from black_samorez

Написал пост на substack про то как я портировал AQLM на мобильные телефоны и как мы с @galbdm умудрились запихнуть Llama-3.1-8b в 2.5 Гб RAM.
В посте детали про то, что нужно было дописать в Executorch чтобы скомпилировать и линкануть кастомные кернелы и как все это дело экспортировать на мобилки.
P.S. подписывайтесь на мой twitter.
  • ❤ 7
  • 👍 2
Post #1803 1.91K

Forwarded from black_samorez

Записали на студии Яндекса видео с объяснением метода статьи и результатов.
Если кто-то будет завтра гулять по постер сессии на ICML - заходите, поболтаем.
YouTube [ICML24] AQLM: Extreme Compression of Large Language Models via Additive Quantization Short video describing our ICML 2024 paper on Extreme Compression of Large Language Models via Additive Quantization. Arxiv:2401.06118
  • ❤ 3
  • 👍 3
  • 🤔 1
Post #1802 1.61K
Андрей классный, мы работали в одной лабе и были в один год на межнаре по физике. Подписывайтесь на его личный ресёрч блог
  • ❤ 3
Post #1801 1.72K
У меня, кстати, др. Поздравьте меня
  • 🎉 39
  • ❤ 26
  • 👍 4
  • 👏 4
  • 😁 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →