

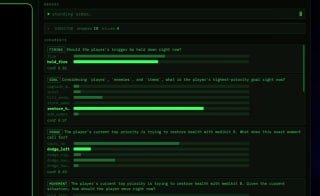
Проверять действия других ИИ, выбирать инструменты, замечать подозрительные операции, разбирать обращения клиентов и управлять игровым персонажем в реальном времени. Именно такие задачи предлагают поручать Jev. В собственных тестах автоматизации разработчики сравнили её с генеративными моделями OpenAI, Anthropic и DeepSeek, которым поручили такие же задачи с выдачей структурированных решений. На сайте заявлены ускорение в 193,6 раза и снижение стоимости в 444,6 раза, но эти показатели относятся к выбранным тестам и не означают такое преимущество над каждой моделью. Цена Jev составляет $0,042 за миллион входных токенов, за выход отдельно не берут.
В демке с Doom модель принимает решения около десяти раз в секунду, получая данные о состоянии игры. А команда Every получила 777 оценок документов менее чем за 0,7 секунды. Это позволяет представить агента, который проверяет себя после каждого действия.
Сторонняя проверка выглядит скромнее, но всё равно впечатляет: в небольшом тесте Every Jev проверяла тексты в 25 раз быстрее и примерно в 580 раз дешевле Fable 5.1 high. Однако нашла 6 из 7 заложенных ошибок, тогда как Fable нашла все семь.
В чём суть:
Обычная генеративная LLM последовательно создаёт токены ответа. Jev получает описание ситуации и параллельно выдаёт оценки по заданным вопросам. Например: «Клиент недоволен? Проблема срочная? Нужен человек?» Программа получает вероятности и действует по ним. Команда заявляет собственную архитектуру и обучение RLCD, которое должно учить модель адекватно оценивать уверенность в своих решениях. Да. RLCD здесь, пожалуй, одна из самых интересных частей Jev.
RLCD расшифровывается как Reinforcement Learning for Calibrated Decisions — «обучение с подкреплением для калиброванных решений». Это собственный метод TypeSafe. Важно: существует более старый RLCD с другой расшифровкой (Reinforcement Learning from Contrast Distillation), но это совершенно другая работа. Главная идея в том, что Jev обучают не просто выбирать правильный вариант, а ещё и правильно понимать, насколько она в нём уверена. Например, модель отвечает:
«Эта транзакция мошенническая: 82%».
Хорошо откалиброванная модель должна означать этим примерно следующее: если собрать много случаев, где она говорит «82%», то примерно в 82% таких случаев ответ действительно должен оказаться правильным. То есть вероятность становится полезным числом для программы, а не просто декоративным confidence score. Именно это TypeSafe называет calibrated decisions. Объяснение авторов.
Если подход подтвердится, это может дать начало новому поколению ИИ-агентов. Большая модель строит план, а быстрые модели вроде Jev помогают выбирать действия и проверять результат на каждом шаге. Чем дешевле такая проверка, тем больше попыток, экспериментов и исправлений можно сделать за те же деньги. В том числе при разработке самого ИИ. И вот здесь становится особенно интересно: ускоряются агенты, которые помогают создавать ещё более сильных агентов🌈
Твит Диогу Алмейды с анонсом Jev
Технический разбор от авторов
Тесты и методика сравнения
Официальный сайт TypeSafe
статья об InstructGPT, 2022
Попробовать можно, если дали ранний доступ. Для всех желающих доступ пока не подтверждён: на сайте TypeSafe всё ещё кнопка Join Waitlist.
При этом уже есть Playground в браузере с входом через Google или почту. По инструкции, там можно вставить текст, задать вопросы и получить оценки без программирования. Для интеграции есть API.
СЛЕДИМ и пробуем🍿💎🍎