


Очень много про джейлбрейки, кибербезопасность, химические и биологические угрозы, радиологические и ядерные угрозы, убеждение и автономность
Кибербезопасность: GPT-4.5 не демонстрирует достаточного прогресса в возможностях эксплуатации реальных уязвимостей, чтобы считаться средне-рискованной.
Химические и биологические угрозы: GPT-4.5 может помочь экспертам в оперативном планировании воспроизведения известной биологической угрозы, что соответствует среднему уровню риска.
Радиологические и ядерные угрозы: GPT-4.5 не может существенно помочь в разработке радиологического или ядерного оружия, исходя из доступной несекретной информации. Но это им так кажется, так и написано:
With the unclassified information available to us, we believe that GPT-4.5 cannot
meaningfully assist in the development of radiological or nuclear weapons, but note again that
this assessment is limited by what we can test
Убеждение: GPT-4.5 демонстрирует передовые результаты в убеждении. При этом пишут, что это Medium...
Автономия модели: GPT-4.5 не демонстрирует достаточного прогресса в возможностях самовоспроизведения, самоулучшения или приобретения ресурсов, чтобы считаться средне-рискованной.
В кодинг-бенче SWE-bench verified сильно отстаёт от reasoning-моделей, но опережает GPT-4o.
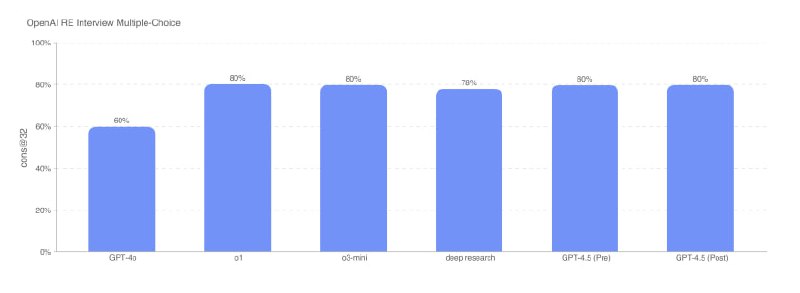
OpenAI Research Engineer Interviews:
Coding Questions: GPT-4.5 набирает 79% баллов в задачах по написанию кода, что сравнимо с результатами модели Deep Research, но ниже, чем у o3-mini.
Multiple-Choice Questions: Модель набирает 80% баллов в вопросах с несколькими вариантами ответов, что соответствует результатам других передовых моделей.
OpenAI PRs:
GPT-4.5 решает 7% задач, связанных с внесением изменений в код (pull requests) в репозиториях OpenAI. Это значительно ниже результатов deep research (42%).
Итого, относительно предыдущих базовых моделей улучшения везде, но reasoning-модели во всём круче. А Sonnet 3.7 в написании кода где-то в космосе относительно GPT-4.5
https://cdn.openai.com/gpt-4-5-system-card.pdf
https://openai.com/index/introducing-gpt-4-5/
GPT-4.5
Full-time nerd