TGViewer
Channel Public Channel
Data360.ru

Data360.ru

@fsecrets

AI & Big Data & Machine Learning & Advanced Analytics- подборка интересных материалов с трендами продвинутой аналитики, реальными кейсами применения.

Канал запущен в поддержку компании Data360.ru
Subscribers
82
Photos
98
Videos
8
Links
818
Recent Posts 19 shown
Post #1002 40

Forwarded from

Бизнесмен Потанин на ЦИПР точно сформулировал, как на самом деле устроен промышленный ИИ: не как автономная система, а как инструмент, который усиливает человека.

Он отдельно подчеркнул, что оператор остается в центре процесса и вмешивается при выходе за критические параметры. То есть речь не про «замену людей», а про ускорение принятия решений и снижение ошибок там, где цена ошибки — миллиарды.

И, пожалуй, самая важная мысль: ИИ начинает работать не тогда, когда он самый умный, а тогда, когда он встроен в конкретный процесс и дает измеримый результат. В случае «Норникеля» это уже десятки миллиардов потенциального эффекта. По ссылке - конкретнее
  • ❤ 1
Post #1001 34

Forwarded from

«Норникель» заявил о создании первой в России ИИ-системы для проектирования промышленных зданий

Компания разработала систему, которая помогает проектировать объекты от фундамента до кровли и автоматически готовит инженерную документацию. По сути, это мультиагентная ИИ-система для промышленного проектирования, обученная на внутренней базе знаний компании, ГОСТах и СНиПах.

Агенты проводят расчеты, собирают цифровую модель здания, формируют спецификации и проверяют все на соответствие корпоративным стандартам и требованиям законодательства. Финальное решение все равно остается за инженером, но основной объем рутины с человека снимается, и это существенно бустит процесс.

А именно: задания на проектирование создаются на 83% быстрее, цифровые модели строятся на 80% быстрее, а выпуск документации ускорился примерно вдвое. При этом к текстовой части документации, по словам компании, практически нет замечаний.

Самое важное тут то, что это попытка встроить ИИ прямо в реальный инженерный воркфлоу крупной промышленной компании. Похоже, что один из самых сильных и недооцененных сценариев для AI в ближайшие годы – не чат-боты, а вот такие узкоспециализированные системы, встроенные в конкретные отраслевые процессы.

Следить за другими разработками Норникеля можно в тг-канале @nornickel_official
Post #1000 30

Forwarded from

Project Deal: Anthropic сделали внутренний маркетплейс, где все сделки от имени людей совершали Claude-агенты

Ранее они уже проводили эксперимент Project Vend, когда агент управлял маленьким вендинговым автоматом (подробнее). Теперь же Anthropic хотят понять, насколько мы близки к целым рынкам с множеством продавцов-агентов и покупателей-агентов.

В проекте участвовали 69 сотрудников. Каждому из них выдали личного агента и 100 долларов бюджета. Агенты получали от владельцев инструкции: что примерно человек хотел бы купить и продать, за сколько, уместен ли торг и тд.

После получения инструкций агенты уходили полностью автономно жить на маркетплейсе и тратить/зарабатывать деньги.

В итоге агенты за короткий срок заключили 186 сделок по 500 товарам, общая сумма транзакций превысила $4000. Кстати, потом сотрудники реально принесли вещи и обменялись ими в офисе.

Оказалось, что качество модели напрямую влияет на ее способность торговаться. Opus в среднем заключал примерно на две сделки больше, чем Haiku, продавал те же товары дороже и как покупатель платил меньше. Например, один и тот же сломанный складной велосипед Haiku продал за $38, а Opus – за $65.

Были, конечно, и смешные моменты. Один сотрудник разрешил Claude купить подарок самому себе, и агент выбрал 19 шариков для пинг-понга за $3, назвав их «сферическими орбами возможностей». Другой агент внезапно продал не вещь, а день с собакой сотрудницы (люди потом действительно это устроили, деньги-то уплачены).

www.anthropic.com/features/project-deal
Post #999 31

Forwarded from

NVIDIA доказала, что обратное распространение ошибки — не единственный способ создания ИИ.

Они обучили модели с миллиардами параметров без использования единого градиента.

Каждый ИИ, который вы используете сегодня, опирается на обратное распространение ошибки.

Это требует сложных вычислений, колоссальных затрат памяти и огромных кластеров GPU.

Тем временем, древний метод без градиентов, называемый стратегиями эволюции (ES), был признан невозможным для масштабирования.

Но теперь всё изменилось.

NVIDIA и Оксфорд только что представили EGGROLL.

Вместо того чтобы генерировать огромные полнорранговые матрицы для каждой мутации, они разделяют их на две маленькие.

ИИ мутирует. Он тестирует. Он сохраняет то, что работает. Как биологическая эволюция.

Но теперь он делает это с сотнями тысяч параллельных мутаций одновременно.

Производительность теперь такая же, как у пакетной инференции.

Они предобучают модели с нуля, используя только простые целые числа.

Без обратного распространения ошибки. Без десятичных. Без градиентов.

Мы думали, что будущее ИИ требует бесконечных кластеров прецизионного оборудования.

Оказалось, нам просто нужно было эволюционировать.

👉 @DataSciencegx
Post #998 24
С одной стороны забота о гражданах, с другой стороны огромная нагрузка на разрабов. Я помню как операторы связи сопротивлялись закону Яровой, хранить все логи пользователей пол года это огромные вычислительные ресурсы. Ну и цены вверх на использование ИИ.
Post #996 26

Forwarded from

🚀 Себастьян Рашка собрал в одном месте галерею архитектур современных языковых моделей.

Внутри - 40+ моделей (2024–2026):
от DeepSeek и Qwen до Nemotron и Grok.

Для каждой модели есть:

• наглядная схема архитектуры
• размер и число параметров
• тип декодера
• ссылки на технические отчёты и конфиги
• иногда даже реализации

По сути это единая карта современных LLM
, где можно быстро посмотреть, как устроены разные модели и как эволюционируют архитектуры.

https://sebastianraschka.com/llm-architecture-gallery/

🐍 Python полезные ресурсы 🚀Max

@pythonl
Post #995 23

Forwarded from

Исследователи внедрили одного вредоносного агента в группу LLM-агентов. Вся сеть не смогла прийти к консенсусу.

Это проблема византийских генералов — классический кошмар распределённых систем, которому уже больше 40 лет.

И теперь это проблема и ваших agent-pipeline.

Даже в полностью «честной» среде, где вообще нет злонамеренных участников, LLM-агенты всё равно часто не могут сойтись на общих значениях. И ситуация становится хуже по мере увеличения числа агентов в группе.

Причём характер сбоя показательный.
Это не скрытая подмена ценностей. Не один агент тихо проталкивает неправильный ответ. Модели просто.. застревают. Тайм-ауты. Круговые обсуждения. Разговор никогда не приходит к общему решению.

Почему это важно: весь хайп вокруг multi-agent AI строится на предположении, что координация работает. Рои автономных агентов, коллективное решение задач, децентрализованные AI-системы. Всё это предполагает, что если посадить несколько LLM в «комнату» и дать им протокол общения, они смогут прийти к общему решению.

Проблема византийского консенсуса — одна из самых старых и изученных задач распределённых систем. Классические алгоритмы решили её десятилетия назад с жёсткими математическими гарантиями. Вопрос был в том, смогут ли LLM-агенты добиться того же через естественный язык, а не через формальные протоколы.

Пока что ответ — нет. И причина довольно фундаментальная.

Традиционные алгоритмы консенсуса работают потому, что каждый узел выполняет одинаковый детерминированный протокол.
LLM же стохастические. Один и тот же промпт может давать разные ответы в разных запусках.

Согласие, достигнутое на третьем раунде обсуждения, может развалиться на четвёртом, когда агенты пересмотрят своё рассуждение после чтения ответов других.

В этом и есть фундаментальное несоответствие: алгоритмы консенсуса предполагают детерминированные state machines, а LLM — их противоположность.

Это также означает, что тезис «больше агентов = лучше ответы» имеет потолок, который почти никто не измеряет. После определённого размера группы издержки координации и провалы сходимости начинают перевешивать пользу от разнообразия мнений.

Практическое следствие довольно неприятное для тех, кто строит multi-agent системы для задач с высокими рисками. Надёжное согласие не возникает само, если просто посадить умных агентов за один стол. Его нужно явно проектировать, с формальными гарантиями, а не надеяться, что оно появится само.

При этом multi-agent системы уже начинают внедрять в финансы, медицину и автономную инфраструктуру. А проблема консенсуса — самый базовый механизм координации — до сих пор не решена.

👉 @DataSciencegx
Post #994 29
Дальше хуже
Post #993 26

Forwarded from

📁 Эндрю Ын, один из пионеров ИИ и сооснователь Google Brain, говорит, что большинство высокоразмерных данных проще, чем кажется.

Датасет размерности 10 000 часто лежит в гораздо меньшем подпространстве.

Если сначала его сжать, обучение становится быстрее, дешевле и эффективнее.

Иногда интеллект это не добавлять больше. Это разумно сокращать.

👉 @DataSciencegx
Post #992 28

Forwarded from

Глава OpenAI Альтман – о том, что к 2028 году появится «сверхразум», который заменит ученых и руководителей:

Мы полагаем, что до появления первых версий настоящего сверхразума нас отделяет всего пара лет. Если мы правы, то к концу 2028 года в центрах обработки данных будет сосредоточено больше интеллектуальных ресурсов, чем за их пределами. Это необычное заявление. И, конечно, мы можем ошибаться, но я думаю, что это действительно заслуживает серьезного рассмотрения.

Сверхинтеллект на определенном этапе своего развития способен выполнять работу генерального директора крупной компании лучше, чем любой руководитель, в том числе лучше, чем я, или проводить исследования лучше, чем наши лучшие ученые.

❤️ Скотт Риттер в Telegram!
Мы в MAX👈📲
Post #991 23
Вот это заявление
Post #990 32

Forwarded from

💰 Гонка за AGI - это не только технологии. Это ещё и риск банкротства на триллионы.

Dwarkesh спросил CEO Anthropic Дарио Амодеи:
почему он так уверен в AGI, но при этом осторожен с масштабным строительством дата-центров?

Ответ оказался жёстким.


Если рынок AI продолжит расти в 10× в год,
компания может выйти на $1 трлн выручки к 2027 году.

Чтобы поддержать такой рост, придётся закупить примерно $5 трлн вычислительных мощностей.

Но здесь и кроется опасность.

Если прогноз окажется немного оптимистичным - например:
- не $1T, а $800B выручки
- рост замедлится до 5×
- или рынок сдвинется всего на 1 год

→ компания просто обанкротится.

По словам Амодеи:

Если ты ошибся в прогнозе, нет силы и нет хеджа, которые спасут от банкротства после таких инвестиций.


Главная мысль:

AGI - это не только гонка моделей.
Это самая рискованная инфраструктурная ставка в истории технологий.

Поэтому «действовать ответственно» -не значит инвестировать сотни миллиардов.

И, по его словам, некоторые игроки в гонке ИИ, возможно, даже не просчитали все риски до конца.

🚀 Полное интервью
Post #989 28
А вот и еще новость
Post #988 30
Post #987 29
Восстание машин
Post #986 30
Post #985 39
Капризы ИИ
И вновь кейс с олимпиадной задачей за 7 класс. То, что он глючит при решении таких задач это понятно итак, но вот чтобы при этом начал фонтанировать эмоциями я столкнулся впервые. У меня была идея, что может быть хотя бы натолкнет на какую-то мысль при решении, но получилось не совсем так.
Вчера столкнулся с капризами ИИ при решении олимпиадной задачи по математике за 7 класс. Указав на очередную ошибку Chat GPT, думал может промптом он добьет решение, он начал капризничать и говорить, “опять меня подловил на ошибке” и утверждении, что “если одно число больше другого, то неочевидно что большее число делится на меньшее без остатка”, хотя ИИ утверждал это без зазрения совести. Он прямо начал чуть не кричать, что это не 7 класс, это не просто задачка, а задачка более сложная. И что тут простые способы доказательства абсолютно не годятся. Пришлось его успокоить и напомнить кто тут платит за услугу а кто простой исполнитель😁
  • 😁 1
Post #980 30

Forwarded from

Вышел AI Safety Report 2026: самый полный на данный момент отчет о рисках и возможностях современного ИИ

В составлении документа принимали участие более 100 ученых из ведущих организаций 30 стран, а председателем комиссии выступил легендарный Йошуа Бенджио.

Отчет целиком просто огромный: более двухсот страниц анализа. Но, к счастью, в этом году авторы сжалились и выпустили также расширенное саммари. Там 20 страниц и все основные графики – если собираетесь читать, советуем именно его. Мы же попытались собрать еще более емкое резюме. Поехали:

Возможности ИИ к 2030 году:

➖Эксперты прямо говорят, что, основываясь исключительно на фактах, без додумок, предсказать, каким будет ИИ к 2030 очень сложно. Это могут быть и небольшие улучшения, и очень стремительный рост.
➖Маловероятно, что к 2030 ИИ-пузырь лопнет. Компании будут продолжать привлекать капитал, алгоритмы будут становится все эффективнее, мощности будут нарастать.
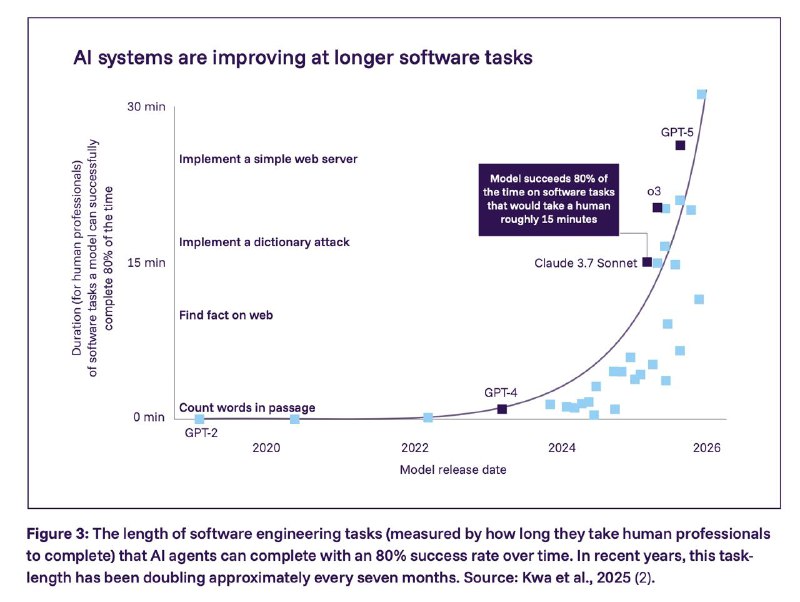
➖Есть и узкие места: в основном данные и энергия. Сейчас продолжительность задач в разработке ПО, которые могут выполнять агенты ИИ, удваивается примерно каждые семь месяцев. Если, несмотря на сложности, темп сохранится, к 2030 году ИИ сможет надежно выполнять задачки, которые у людей занимают дни и недели. НО, вероятно, все еще будет нестабилен в нестандартных ситуациях.


Основные риски:

➖Отчет делит риски на три уровня: от злонамеренного использования, от сбоев и ошибок самих систем и системные социальные риски.
➖Сейчас опаснее всего: масштабирование мошенничества и влияния на общественное мнение с помощью ИИ (сюда же deepfake-контент), кибератаки и галлюцинации. То есть, если не говорить о неправометрном использовании, основной опасностью остается факт, что системы выглядят умнее и надежнее, чем они есть на самом деле.
➖ На горизонте нескольких лет нам угрожает в первую очередь снижение барьера для биологических и химических угроз, и только потом – появление автономных, трудно контролируемых систем.
➖ Есть и политические риски, В первую очередь, централизация власти: страны и организации без собственного ИИ-стека ожидаемо станут структурно зависимыми.


Что касается рынка труда и социальных эффектов:

➖ Пока нет никаких доказательств массового эффекта, оказываемого ИИ на рынок труда, ХОТЯ в ряде профессий действительно наблюдается снижение занятости у молодых специалистов, но пока без алармизма.
➖ Массовой безработицы ожидать не стоит, нужно бояться скорее социальной и экономической поляризации общества: спрос на средний класс специалистов резко упадет, на сильнейших – резко вырастет. И тем не менее, пока предсказать трудно, потому что это первый случай в истории, когда автоматизация бьет по когнитивному труду раньше физического. Плюс, распространяется ИИ гораздо быстрее Интернета или компьютеров в свое время.
➖ Сильнее прочего людям угрожает лень, то есть атрофия навыков и эрозия ответственности (в том числе юридическая). Возможно массовое снижение навыков критического мышления.


Как говорится, делаем выводы. Все самые интересные графики оставили сверху
Older posts →

About this channel

How can I read @fsecrets without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Data360.ru: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Data360.ru have?
Data360.ru (@fsecrets) has 82 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Data360.ru know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →