
On the Biology of a Large Language Model
Ученые из компании Anthropic (которая делает Claude) периодически публикуют работы, которые исследуют то, как LLM думают, рассуждают, как можно сделать их безопасными.
Очередная интересная работа: On the Biology of a Large Language Model. Они использовали новый метод - Attribution Graphs. Он позволяет более понятно и наглядно показать, как в реальности LLM приходит к ответу на запрос.
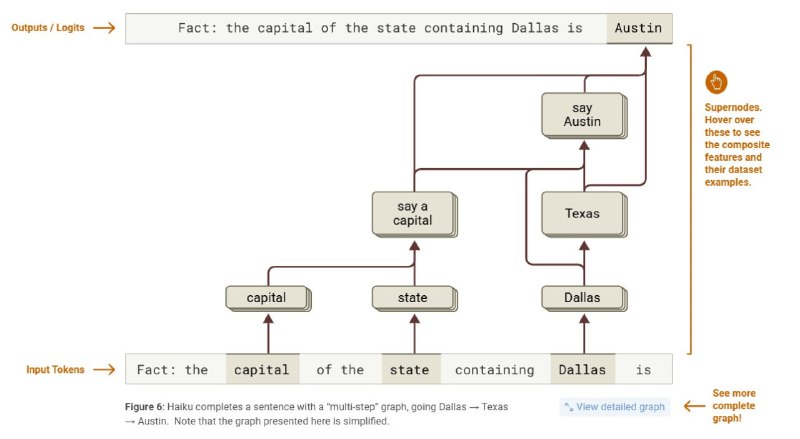
Например, для запроса: Fact: the capital of the state containing Dallas is
В LLM активируется кластера фич, которые отвечают за каждое отдельное слово: capital, state, Dallas.
Далее capital и state активируют фичу "say capital", которая активируется, когда нейросеть хочет предсказать столицу. Фича Dallas активирует фичу Texas. И наконец фича "say capital", Dallas, Texas активируют фичу "say Austin", которая предсказывает Austin следующим словом.
Аналогично, нейросеть работает при сложении. Она не размышляет в виде формальных логических законов арифметики. А также работает ассоциативно (интуитивно). Но если ее попросить объяснить, как нейросеть додумалась до ответа - она ответит совсем другое! Она ответит то, что мы хотим услышать, а не то, как она в реальности дошла до ответа. Про это есть отельное исследование, где исследуется CoT (chain of thought). Это когда модель проводит рассуждения. И оказывается, что то, что она выводит в качестве рассуждения - это не совсем то, как она в действительности рассуждает внутри.
Видео в тему статьи:
https://www.youtube.com/watch?v=-wzOetb-D3w
https://youtu.be/mU3g2YPKlsA?si=acOhiF5o19DChonN
Post #598
1.76K
- 👍 11
- 😁 4
- ❤ 1
- 🙉 1