TGViewer
Channel Public Channel
Антон Дорошкевич | маяк в мире 1С и СУБД

Антон Дорошкевич | маяк в мире 1С и СУБД

@explorer1c

Только интересные технические подробности, кейсы, тесты, а также анонсы выступлений на мероприятиях
Никакой "воды" и рекламы

Вся информация в этом канале - это моё личное мнение и не является официальной позицией вендоров и рекомендациями к действиям
Subscribers
2.02K
Photos
64
Videos
0
Links
46

Showing posts older than #79 · Back to latest

Older Posts 16 shown
Post #78 2.98K
В этот четверг 02/07 в 10-00 по Мск (14-00 по Нск) вебинар по возможностям КОРП-платформы 1С и новшествам PostgreSQL для высоких нагрузок.

Ну и конечно ответы на все вопросы, какие накопились.

Приходите, будет интересно!)
  • 🔥 17
  • 👏 4
  • ❤ 3
  • 😱 1
Post #76 3.34K
Вчера получил несколько десятков вопросов с непониманием - что всё таки явилось причиной блокировок, описанных в https://t.me/explorer1c/75

❗️Итак:
Причиной проблемы был установленный параметр ALLOW_ROW_LOCKS = OFF для всех индексов всех таблиц базы.

Причём тут документация?
На ИТС написано:
До дефрагментации индекса необходимо включить страничные блокировки. Пример команды:
ALTER INDEX index_name ON table_name SET (ALLOW_PAGE_LOCKS = ON, ALLOW_ROW_LOCKS = ON);

Выполнить дефрагментацию.
Обратно выключить страничные блокировки. Пример команды:
ALTER INDEX index_name ON table_name SET (ALLOW_PAGE_LOCKS = OFF, ALLOW_ROW_LOCKS = ON);


Т.е. речь всегда идёт только о страничных блокировках, это параметр ALLOW_PAGE_LOCKS.
Но в примерах команд есть ещё и параметр ALLOW_ROW_LOCKS , который вообще-то и в первом скрипте (Перед дефрагментацией индексов) и во втором (после дефрагментации) установлен в значение ON.

Но поскольку текстом написано включить и после дефрагментации выключить, то читается это как выключить всё что было включено.
Что и явилось причиной неверного плана обслуживания, где после дефрагментации был выключен параметр ALLOW_ROW_LOCKS=OFF.

Проверить наличие такой настройки в индексах базы можно запросом:

select object_id, name, allow_row_locks from sys.indexes where allow_row_locks = 0
Telegram Антон Дорошкевич | маяк в мире 1С и СУБД Прорыв блокировок на MS SQL через Управляемые Недавно разбирали очень странную проблему… На MS SQL фиксировалось огромное количество таймаутов, при том что конфигурация на управляемых блокировках и по идее таймауты если могут быть, то должны фиксироваться…
  • 👍 30
  • 😱 3
Post #75 2.17K
Прорыв блокировок на MS SQL через Управляемые

Недавно разбирали очень странную проблему…
На MS SQL фиксировалось огромное количество таймаутов, при том что конфигурация на управляемых блокировках и по идее таймауты если могут быть, то должны фиксироваться на уровне 1С с событием TTIMEOUT, а не EXCP

Пользователи сотни раз в час получали сообщение вида:
Конфликт блокировок при выполнении транзакции Microsoft SQL Server Native Client: Превышено время ожидания запроса на блокировку


При этом виновниками блокировок судя по анализу таймаутов на СУБД были совершенно безобидные запросы select…
Но по мимо них и update, и insert, и delete, да ещё и на разных таблицах…
Т.е. никакой системности, никакого одного подозреваемого и совершенно непонятное поведение СУБД.
Как будто мы работаем на автоматических, а не на управляемых блокировках…

Долго ломали голову с какой стороны подойти даже к анализу, не то что к решению проблемы, так как по ощущениям в системе не просто проблема, а «ушиб всей бабки»…

Запрос:
SELECT DB_NAME(tl.resource_database_id) AS database_name, tl.request_session_id, tl.request_mode AS lock_type,* FROM sys.dm_tran_locks tl WHERE DB_NAME(tl.resource_database_id) = 'erp' ORDER BY tl.request_session_id

Показывал очень странный вывод – в колонке resource_type была только запись OBJECT, что означает что виновник блокировки блокирует всю таблицу, а не конкретную запись/записи в ней

Если бы блокировались записи, то в колонке resource_type должна быть запись KEY.

Получается, что мало того что мы каким-то чудесным образом прорываемся сквозь управляемые блокировки, ещё и блокируем каждый раз таблицы целиком…

Но мы точно знаем – чудес не бывает!
На соседней базе, на этом же сервер СУБД выполняем запрос, который начинает транзакцию на чтение, внутри становится на паузу в 1С минуту, чтобы мы успели увидеть, что и как он блокирует
BEGIN TRANSACTION;
SELECT * FROM dbo._InfoRg178 T1 WITH (HOLDLOCK) WHERE T1._Fld80 = 'test'
WAITFOR DELAY '00:01:00';
COMMIT TRANSACTION;


И видим что СУБД совершенно корректно блокирует по KEY, т.е. конкретную запись в таблице.
Такой же запрос в проблемной базе, блокирует всю таблицу – OBJECT
Значит разница именно в какой настройке в базе, а не в сервере СУБД.

В итоге – нашли!

А именно: https://its.1c.ru/db/metod8dev/content/5837/hdoc
Важно! Начиная с версии платформы 8.3.22 необходимо выполнять дефрагментацию индексов по следующему алгоритму:
До дефрагментации индекса необходимо включить страничные блокировки. Пример команды: ALTER INDEX index_name ON table_name SET (ALLOW_PAGE_LOCKS = ON, ALLOW_ROW_LOCKS = ON);
Выполнить дефрагментацию.
Обратно выключить страничные блокировки. Пример команды: ALTER INDEX index_name ON table_name SET (ALLOW_PAGE_LOCKS = OFF, ALLOW_ROW_LOCKS = ON);

При этом в плане обсуживания проблемной базы в самом последнем шаге устанавливается ALLOW_ROW_LOCKS = OFF
Что отключает у MS SQL возможность использовать индексы и SQL Server будет вынужден использовать только табличные блокировки


Вывод – читать документацию нужно очень внимательно, там всё написано верно, но так, что может и ввести в заблуждение)))
И проверьте свои планы обслуживания баз на MS SQL
  • 🔥 30
  • 👍 11
  • 😁 7
  • ❤ 5
  • 🙏 3
Post #74 1.44K
16/06/2026 вышел релиз Postgres PRO Enterprise 18.4.1, где добавлена поддержка операций чтения и записи для временных таблиц, временных последовательностей и временных представлений на сервере горячего резерва.

Ранее писал о нашем тестировании этого механизма:
https://t.me/explorer1c/63?single
https://max.ru/explorer1c/AZ12VKRVZj4
MAX Антон Дорошкевич | маяк в мире 1С и СУБД Только интересные технические подробности, кейсы, тесты, а также анонсы выступлений на мероприятиях Никакой "воды" и рекламы Вся информация в этом канале - эт…
  • 🔥 11
Post #73 3.04K
Pg_dump это не только ценный бэкап, но и средство диагностики целостности базы

На этой неделе столкнулись с очень интересной проблемой.

Проявлялось это так:
- 1С практически не шевелится
- Если удалось зайти в 1с, то при совершенно разных операциях получаем ошибки СУБД с разным набором таблиц, которые почти ни о чём не говорят, кроме как что-то пошло не так
- Нагрузка ЦПУ на сервере PostgreSQL под 100%

Запрашиваем список активных сессий на СУБД
select * from pg_stat_activity

И получаем список транзакций. Которые длятся минуты и десятки минут с текстом:
select * from public._scheduledjobs...;

и т.д.

Попытка завершить транзакции средствами СУБД ни к чему не приводит.

Тем временем прод стоит, паника нарастает…

Всё это происходит на PostgresPRO Enterprise с встроенным кластером BiHA.
Система определяет что мастер не отвечает и перекидывает всю нагрузку на другую ноду кластера – всё совершенно корректно, как доктор прописал!
И что мы видим? – Буквально за 10 минут теперь и "новый мастер" так же уходит в нагрузку по ЦПУ в 100%.

Снимаем отладочную информацию со всех процессов мастера и «нового» мастера командой
kill <pid> -40

для ТехпПоддержки PostgresPro.

И хоть я и очень не люблю так делать, но аварийно останавливаем PostgreSQL через
kill <pid> -9

и на мастере и на «новом» мастере.

Блокируем 1С.
Стартуем PostgreSQL.

И для быстрой диагностики запускаем vacuum analyze only в несколько потоков на базе.
И опять получаем «зависшие» транзакции analyze на разных scheduledjobs…

Поясню – analyze читает не все данные в таблице, а только количество строк = 300*default_statistic_target. Обычно default_statistic_target = 100, т.е. мы читаем только 30 000 строк в таблице, и даже при этом уже получаем зависание системы.

Вот это уже страшно… Опять снимаем crash_info, рестартуем службу Postgres и начинаем расстраиваться…

Всё больше подозрений на битые страницы данных…
И тут встаёт вопрос, как быстро проверить все данные в базе?

Ответ – pg_dump, ведь по сути это select * по всем таблицам базы и сбор информации о DDL схемах как самих таблиц, так и индексов.

Но, база не маленькая и дамп будет формироваться достаточно долго…

Вспоминаем что можно вместо сохранения дампа на диск отправить его в «чёрную дыру» /dev/null, но при этом сохранив логи самого процесса дампа.

pg_dump -h 127.0.0.1 -p 5432 -U postgres -d ERP> /dev/null 2> dump.log


Такой дамп формируется намного быстрее.
Запускаем и получаем в логе сообщение:
pg_dump: ошибка: ошибка при выполнении запроса: ERROR: index "pg_attribute_relid_attnum_index" contains unexpected zero page at block 2349
ПОДСКАЗКА: Please REINDEX it.


Вот это поворот! Что-то не так с данными системной таблицы атрибутов..
Ну чтож, есть подсказка, давайте ей и воспользуемся:
REINDEX TABLE pg_catalog.pg_attribute;

И после этого опять запускаем analyze, чтобы проверить починилось ли и да, база починилась, analyze прошёл.
Запускаем 1С – проверяем, всё работает.
Запускаем пользователей и естественно у них «такая же нога, но болит!..», а именно, при различных операциях получаем ошибку СУБД с текстом:
ERROR: heap tid from tuple … offset 204 of block 4 in index “pg_namespace_nspname_index”…

Запускаем
REINDEX INDEX pg_namespace_nspname_index;

- ошибка ушла.

Причина по которой разрушились системные индексы пока ещё выясняется.
❗️Сама история говорит о том, что базу надо периодически регламентно проверять на целостность, а лучше не базу, а весь кластер командой:
pg_dumpall -h 127.0.0.1 -p 5432 -U postgres > /dev/null 2> dump.log
При этом лог будет пустой, если дамп не обнаружит ошибок.
Если же хочется иметь лог всей работы дампа в любом случае, то команда будет такой:
pg_dumpall -h 127.0.0.1 -p 5432 -U postgres -v > /dev/null 2> dump.log

Ну и на всякий случай канал в MAX https://max.ru/explorer1c
  • 🔥 68
  • 👍 26
  • ❤ 1
Post #72 3.72K
Смена dbowner у базы 1С на PostgreSQL

Согласно check-list по настройке 1с рекомендуется «для каждой продукционной информационной базы создавать отдельного пользователя».
Так же Информационная безопасность тоже требует чтобы мы работали под уникальными пользователями с каждой базой и при этом у этих пользователей нужен только минимально необходимый набор прав.

Казалось бы, что может быть проще?
Ну выполним аналог команды MS SQL
EXECUTE sp_changedbowner 'ERP';

и готово.

Но оказалось что всё не так просто, а иногда и невозможно…

❗️Так повелось у многих, что создаём базы не просто из под пользователя с правами SUPERUSER, а именно из под пользователя postgres.

Какие пути решения есть:
1. Сменить владельца базы
ALTER DATABASE "ERP" OWNER TO "ERP";


Получаем следующие эффекты:
❗️Владельцем таблиц остаётся postgres.
Ок, мы не робкого десятка и умеем писать скрипты...
В цикле бежим по всем таблицам и выполняем
ALTER TABLE OWNER TO

❗️Но при запуске 1С пишет «База данных непригодна для использования»…

Дело в недостаточном разрешении для lc_messages
Ок, выполняем
grant set ON PARAMETER lc_messages to " ERP ";

❗️И всё равно при запуске базы получаем:
42501: ERROR: must be owner of extension mchar

🚫И вот тут первое нерешаемое – назначить владельца для расширения невозможно.

2. REASSIGN OWNED - Команда затрагивает только объекты в текущей базе данных. Обычно её нужно выполнять в каждой базе данных, которая содержит объекты, принадлежащие удаляемой роли.
Как раз то что нужно!!!
Если бы мы изначально не создали базу из под пользователя postgres

Команда
REASSIGN OWNED BY postgres TO ERP

❗️– не выполнится, с ошибкой: Изменить владельца объектов, принадлежащих роли postgres, нельзя, так как они нужны системе базы данных.

⛔️Всё, тупик. К сожалению, для баз созданных из под postgres, изменить полноценно владельца невозможно!

И тут решение только одно – dump/restore базы во вновь созданную, владельцем которой назначен другой пользователь без прав SUPERUSER.

Ну а на будущее – после разворачивания сервера PostgreSQL нужно первым же делом создать себе нового пользователя с правами SUPERUSER и работать под ним, а Супер-SUPERUSER postgres оставить на крайний случай прописав ему например доступ только по 127.0.0.1 в pg_hba.conf

Ну и на всякий случай канал в MAX https://max.ru/explorer1c
  • 👍 32
  • 👏 6
  • 🤔 6
  • ❤ 4
  • 🤬 1
Post #71 2.76K
Всем привет!

18 июня, 17-30
Новосибирск, Ядринцевская 21
1С митап CDEK
https://cdek-meetup.timepad.ru/event/4010555/

Приходите, будет интересно!
После выступления отвечу на все вопросы, какие накопились!)
  • 👍 24
  • 🔥 19
  • ❤ 4
  • 🤔 2
Post #70 3.23K
Почему добавление ресурсов может привести к «слёту» программной лицензии 1С

Мы же с вами чётко помним, что программная лицензия «слетает» только при удалении, а не при добавлении устройств, которые были в системе на момент активации лицензии.
Но при этом часто видим историю, когда именно добавление ресурсов виртуальной машины приводит к тому что лицензия становится неактуальной.
Например, нам понадобилось увеличить объём оперативной памяти виртуальной машины – кажется, что это почти тоже самое что добавить в физический сервер плашку оперативки.

«Да, но нет» - часто, чтобы увеличить объём памяти гипервизор виртуальной машины меняет ей модель процессора, и в итоге мы получаем не только добавление памяти, но и смену ЦПУ.

То же самое касается добавления ядер или увеличения суммарной герцовки ЦПУ у виртуалки, в итоге мы получаем именно изменение (удаление старого ЦПУ и добавление нового).

Ситуацию усугубляет то, что после подобных изменений 1С может спокойно запуститься и работать видя все лицензии. Администратор уверен, что значит всё прошло хорошо и переактивировать ничего не требуется.
А потом в «неожиданный» момент система перестаёт воспринимать лицензии.
Такое поведение возможно, так как параметры привязки лицензии к параметрам ПК проверяются не чаще одного раза в сутки.
Это не значит что у нас есть 24 часа после любых изменений!
Это значит что у нас есть сколько-то времени (сколько неизвестно) до следующей проверки параметров.

❗️Ну и наконец, есть ещё один очень важный момент!
Как я написал выше «мы же с вами чётко помним…», так вот, оказывается что мы помним это со времён версии Лучшей в мире платформы 1С 8.3.11!!!
Напомню, что последний релиз этой ветки вышел чуть более 8 лет назад 13/05/2018 года.

А уже с версии 8.3.12 описание поменялось на «Если в процессе работы будет изменен хотя бы один из ключевых параметров, то будет необходимо повторно активировать программную лицензию (с использованием нового пин-кода). Параметры компьютера опрашиваются не чаще одного раза в сутки.». Вот ссылка , на ИТС для 27 версии и ИТС для 12 версии платформы ветки 8.3. ну и на всякий случай для версии 8.5.4

Итак, правильный порядок действий при планировании изменений параметров железа и при самом изменении этих параметров:
1. Проверяем что у нас есть запасной пин-код для всех программных лицензий, активированных на данном ПК.
Если у вас нет пин-кода, то его можно или получить на сайте https://portal.1c.ru/support/license в онлайн режиме или запросить у 1С по почте lic@1c.ru.
Количество пин-кодов не ограничено, но получить можно только один пин-код за один раз. Получить 10 шт на всякий случай не выйдет.
2. Точно знать какой пин-код активирован на данный момент, его будет необходимо указать при активации нового
3. Провести изменение оборудования
4. Переактивировать все программные лицензии
  • 🔥 44
  • 👍 24
  • ❤ 3
  • 🤬 1
Post #68 3.32K
Как понять хватает ли памяти серверу PostgreSQL

Это очень интересный вопрос, так как на него нет ни простого ни точного ответа…

Для начала нужно разделить потребляемую память на 2 вида:
▫️ Память на соединение
▫️ Память на весь сервер

Сначала давайте попробуем понять, как мониторить хватает ли нам памяти на соединение?

Для ограничения потребления памяти в сеансе используется 3 параметра temp_buffers, work_mem и maintenance_work_mem.

Для отслеживания достаточности у нас есть на данный момент только один инструмент – логирование имён и размеров временных файлов, которое включается параметром log_temp_files.
Итак, допустим у нас temp_buffers = 128 MB, work_mem = 256 MB, а maintenance_work_mem = 512 MB тогда параметр log_temp_files лучше всего задать равным меньшему из этих значений, т.е. log_temp_files = 128 MB.

Тогда, в логах будет может появиться запись вида:
СООБЩЕНИЕ:  временный файл: путь "base/pgsql_tmp/pgsql_tmp33513.6.sharedfileset/0.0", размер 317964288

Как видно, был создан временный файл размером 317 964 288 байт.
А ниже этой строчки будет строка с текстом запроса, который вызвал создание временного файла такого размера:
ОПЕРАТОР:  CREATE UNIQUE INDEX _inforg2483_2 ON public._inforg2483 USING btree (_fld12588, _fld4134rref, _fld4133_type, _fld4133_rtref, _fld4133_rrref);

И вот тут придётся соотносить смысл запроса с параметрами, ограничивающими потребление оперативной памяти на сеанс, в данном примере этот временный файл был сформирован в оперативной памяти, так как параметр maintenance_work_mem больше чем размер файла.
А дальше делать вывод – повышать ограничение, если это не разовая, а массовая операция и при этом оперативки ещё много, а диски уже взывают о помощи.
Или пренебречь разовыми выплесками и оставить настройки как есть.
С другой стороны, если за релевантный для вашей системы период в логах нет таких записей, то стоит понизить значение параметра log_temp_files, например в 2 раза и собрать информацию.
Затем, возможно принять решение об уменьшении параметров, так как оперативки на сервере уже не хватает.

Теперь давайте посмотрим что у нас с памятью на сервер?
За объём выделенной памяти отвечает параметр shared_buffers, который по умолчанию рекомендуется ставить в 25% от всей оперативной памяти сервера.

Тут одновременно и сложнее и интереснее…

В анализе нам очень поможет расширение pg_buffercache.
Оно работает на таблицу, поэтому перед использованием необходимо выполнить команду создания расширения: CREATE EXTENSION IF NOT EXISTS pg_buffercache;
После этого мы можем узнать общее состояние буфера командой pg_buffercache_summary();
Ну и тут будет сразу видно, если у вас число неиспользуемых буферов buffers_unused достаточно большое относительно числа используемых buffers_used, то видимо переборщили с количеством кэша и его можно уменьшить.
❗️Важное замечание – параметр shared_buffers задаётся в байтах, а значения полей buffers_unused и buffers_used выдаётся в количестве буферов, один буфер = 8КБ.

❗️Ну и наконец, с помощью этого расширения мы можем узнать какие именно таблицы базы и сколько именно буферов в общем кэше занимают.
Это можно получить следующим запросом на каждую базу, который выдаст 20 таблиц-лидеров потребления кэша:
SELECT current_database() AS database_name, CASE WHEN d.relname IS NULL THEN c.relname ELSE d.relname END AS table_name,
count(*) AS buffers_size, cast (100*count(*)/cast ((SELECT buffers_used + buffers_unused FROM pg_buffercache_summary()) as numeric) as numeric(5,2)) AS percent_buffers_used
FROM pg_buffercache b JOIN pg_class c
ON b.relfilenode = pg_relation_filenode(c.oid)
LEFT JOIN pg_class d
ON c.oid = d.reltoastrelid
AND b.reldatabase IN (0, (SELECT oid FROM pg_database WHERE datname = current_database()))
GROUP BY CASE WHEN d.relname IS NULL THEN c.relname ELSE d.relname END
ORDER BY 3 DESC
LIMIT 20;


Напоминаю про канал в MAX, мало ли...
  • 🔥 31
  • 🤔 6
  • 👍 3
  • ❤ 1
Post #67 2.9K
1️⃣🔤 Менеджер лицензий

Протестировали Менеджер лицензий:
1. Работает! Выдаёт и программные и USB лицензии. Ограничения работают что на уровне ip что на уровне гибких ограничений по типу клиентского приложения, пути до базы и т.д.
Всё достаточно удобно и наглядно.

2. ❗Работает только с клиентами на платформе 8.5.4! Ни 8.5.1 ни 8.3.27 не могут подключиться к Менеджеру лицензий.
К сожалению, не нашли такое ограничение в документации, так что пока ориентируемся на результаты теста.
  • 🔥 37
  • 👍 22
  • ❤ 3
  • 😱 3
Post #66 3.69K
1️⃣🔤 8.5.4 - революция в платформе

30 апреля вышла уже "настоящая" 8.5, а не технический клон 3.27 с возможностью нового интерфейса.

В платформе очень много новшеств - и работа кластера, и метрики, и работа с СУБД, и работа с копиями баз данных, и патчи для клиенстких приложений, и ещё и ещё и ещё...
Читайте, наслаждайтесь, готовьтесь к переходу - ссылка с описанием изменений и новой функциональности.

Ну и конечно, долгожданный менеджер лицензий, который по моему мнению снимет почти все вопросы и неудобства, если они были в работе с программными лицензиями.
Читайте, теструйте, пробуйте - вот ссылка на итс с описанием.

В свою очередь буду делиться тем, что будем использовать на практике.

Напоминаю про канал в MAX, мало ли...
  • 🔥 48
  • 👍 9
  • 😱 3
Post #65 5.24K
Катастрофическое падение скорости при обновлении

В последнее время флагманские конфигурации 1С выпустили достаточно «тяжёлые» обновления ERP, УХ, KA и т.д.

Особенностью этих обновлений, помимо большого количества реструктуризаций объектов так же является большое количество монопольных обработчиков после обновления (это когда идёт «градусник» в пользовательском режиме) и вход в 1С заблокирован.

Мы в рамках инцидентов РКЛ уже несколько раз столкнулись с тем, что процесс этого монопольного обновления затягивается на несколько часов или даже суток!

Систематизация проблемы показала, что она существует только при использовании MS SQL и при этом полностью отсутствует на PostgreSQL и там этот этап проходит буквально за минуты.
Дальнейший анализ показал, что проблема возникает не всегда и не у всех – что с одной стороны сильно затрудняет её решение (так как по классике – такая же нога и не болит), с другой стороны есть что с чем сравнить (тех у кого быстро и тех у кого медленно, при сопоставимом количестве записей в регистрах – чтобы ощутить проблему, этих записей должны быть миллионы и десятки миллионов).

Разбор процедур обработчика показал, что происходит регистрация к изменению всех строк определённых регистров для дальнейшей постобработки в фоновом режиме, когда вход пользователей уже возможен, но функционал может быть ограничен.

Тонкость регистрации изменений состоит в том, что сначала проверяется есть ли уже такие зарегистрированные изменения (на уровне СУБД это запрос SELECT), и если таковых нет, то происходит уже сама регистрация (на уровне СУБД это запрос INSERT).

И по Технологическому журналу 1С мы получали чудовищную деградацию скорости именно при SELECT, если по началу он длился тысячные доли секунды, то затем вырастал до десятков секунд.

Разбор плана запроса показал что статистика чудовищно ошибается в предположении сколько строк уже зарегистрировано, например статистика предполагает что их 638 шт, а по факту оказывается 3 564 175 шт.

А у тех у кого обновление было быстрым – статистика не ошибалась…

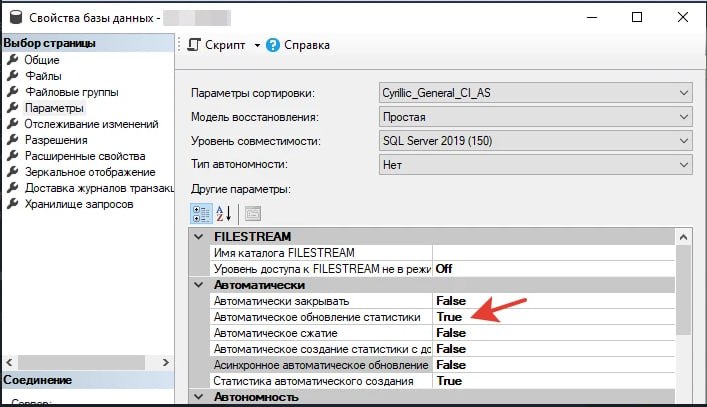
В итоге было обнаружено, что всему виной отключенный Автоматический расчёт статистики на базе (аналог autovacuum_analyze в PostgreSQL) – на картинке видно где это включается.

Причина отключения достаточно известна – есть прекрасная статья, конкретно отключение автообновление статистики начинается с заголовка «Нестандартные ожидания на блокировках».

Что делать?
❗️Выключать автообновление статистики нужно только если вы фиксируете ожидания с типом LCK_M_SCH_S.
Придётся теперь следить и за этим параметром, и включать автоматический расчёт статистики, если вы ожидаете огромный объём регистрации к изменению.
Ну а при обновлении конфигурации – нужно включать автоматический расчёт на постоянной основе, просто как часть процесса и только после окончании всех процессов обновления, в том числе и фоновых уже выключать автообновление статистики, если на вашей базе это необходимо.
  • 👍 45
  • 🔥 28
  • ❤ 11
Post #64 3.43K
1️⃣🔤 Как заваривать ТЖ

Довольно частый список вопросов у тех, кто начал нелёгкий путь разбора непонятных ситуаций с производительностью 1С или с непонятным поведением лучшей в мире платформы 1С:
- как настроить ТЖ?
- какие события там есть и что они значат?
- как это всё читать и желательно понимать?

Начнём по порядку и ответим сразу на оба первых вопроса:

Как настроить ТЖ, какие события там есть и что они значат?
Есть два отличных источника информации - это ИТС и статья на insoftart.
Конечно же сразу там ничего не понятно и понимание придёт только с опытом расследования конкретных ситуаций, когда вы будете читать ТЖ как Нео Матрицу...

Минимально необходимую и достаточную для большинства ситуаций настройку тж, основанную на опыте нашей команды РКЛ я для вас собрал ниже:
ТЖ для сервера 1С на Windows, платформа <= 8.3.24
ТЖ для сервера 1С на Windows, платформа >= 8.3.25
ТЖ для сервера 1С на Linux, платформа <= 8.3.24
ТЖ для сервера 1С на Linux платформа >= 8.3.25

В версиях для платформ >= 8.3.25 добавлен параметр format = "json", что сильно ускоряет разбор тж автоматическими средствами (их очень много, каждый выберет себе по вкусу), но в тоже время журнал становиться сложно человекочитаем.
Поэтому если планируете смотреть журнал вручную, то лучше не собирать его в json.

Как проверить что ваша настройка ТЖ корректна в части структуры?
Просто откройте файл logcfg.xml в браузере - у вас не должно появится никаких сообщений об ошибках и вы должны увидеть обычную xml структуру.

Как это всё читать и желательно понимать?
Это самый сложный вопрос и на него нет какого-то универсального и простого ответа.
К сожалению, тут работает только насмотренность ТЖ и опыт расследования.
На первоначальном этапе сильно помогут Инструменты разработчика и встроенный в них парсинг ТЖ.
Там нет никаких подсказок что делать с полученной из ТЖ информации, но она уже структурирована, сгруппирована и отсортирована, что сильно облегчает понимание.

Что ещё можно сделать, когда обычные настройки ТЖ не помогают?

Настроить сбор полного ТЖ с фильтром по базе или по базе и пользователю.

<log location="C:\TJ\full" history="2">
<event>
<ne property="name" value=""/>
<eq property="p:processName" value="ИмяБазы"/>
<eq property="Usr" value="ИмяПользователя"/>
</event>
<property name="all"/>
</log>


❗️Даже такую таргетированную настройку не надо постоянно держать на серверах, так как она создаёт приличную нагрузку и может негативно влиять на производительность системы.
Настроили - воспроизвели/дождались проблему/мы, убрали настройку - сидим читаем.
Так же иногда полезно включить полный ТЖ на клиенте, настройка его аналогична, но там не имеет смысла фильтры по базе и имени пользователя, их просто удаляем из настройки.

Напоминаю про канал в MAX, мало ли...
  • 👍 26
  • 🔥 13
  • 👌 1
Post #59 3.77K
1️⃣🔤 🔤🔤🔤 Копия базы данных 1С на репликах PostgresPRO
Итак, давайте сначала определимся с целью.
Цель: При наличии физической реплики (реплик) для отказоустойчивости (а мы с вами помним, что продуктивного сервера СУБД без реплик не бывает, иначе это мёртвый сервер и вопрос не в том - умрёт ли, а только в том – когда умрёт…) сделать распределение читающей нагрузки 1С на реплику с помощью механизма копии базы данных 1С.

Что уже есть в части работы этого механизма копии с PostgreSQL?
1. Внутренняя репликация. Это когда мы просто обменом 1С периодически обновляем нужные нам данные из рабочей базы 1С в базу копию.
Полюсы – кросСУБДшность, т.е. мы рабочая база может быть на любой СУБД и копия может быть на любой СУБД и при этом они не обязаны совпадать. Например, рабочая на MS SQL, а копия на PostgreSQL.
Минусы – обмен происходит периодически, т.е. данные в копии могут серьёзно отставать. Скорость обмена не всегда удовлетворяет требованиям бизнеса.

2. Внешняя репликация с помощью расширения dbcopiesupdates. Если кратко, то это обмен между двумя базами PostgreSQL основанный на вычитке WAL (журнала предзаписи транзакций).
Плюсы – большая скорость и отсутствие ненужных перезаписей объектов.
Минусы – обмен происходит периодически, т.е. данные в копии могут серьёзно отставать, так же нужно сохранять весь WAL между периодами синхронизации.

Общий «минус» обоих вариантов – необходимо иметь дополнительный сервер для копии базы данных, при том что у нас же уже есть реплика, а чаще всего их даже две, так как кластер обязан состоять из нечётного числа узлов (узел рефери это отдельная история и пока её унесём за рамки).

Рассмотрим сам процесс создания такой копии базы данных в 1С и проверим работает ли это «чудо»:

1. Функции технического специалиста – Управление копиями базы данных. Нажимаем Добавить, Выбираем тип – Внешняя, Тип СУБД – PostgreSQL, База данных – имя базы как у прода (тут как раз зарыта одна особенность), Пользователь и пароль на СУБД. (Рисунок 1)
Поскольку это реплика, то в целом можно выбрать все метаданные, так как они в реальности там все есть.
Поскольку метаданных много, то лучше снизу снять флажок «Обновлять информацию автоматически». Иначе колёсико ждуна будет почти вечно крутиться.

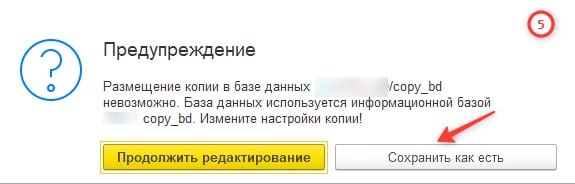
2. Нажимаем ОК и получаем предупреждение (Рисунок 5), где нажимаем «Сохранить как есть». Предупреждение мы как раз и получаем из-за того, что у нас на реплике полная копия прода и там есть запись на каком сервере 1С расположена наша база.

3. В итоге копия подключается с Состоянием – включена и Состоянием обновления – неактивно, но на это не обращаем внимание, так как на ИТС написано, что будет использоваться копия с состоянием Включена.

Теперь одно из самых приятных – подключаем копию БД к отчёту без привлечения разработчиков 1С.

Возьмём для примера типовой отчёт ERP: Валовая прибыль предприятия (Рисунок 2)
1. Идём в Настройки – Ещё – Настройки для технического специалиста – Дополнительные настройки
2. Включаем «Выводить копию базы данных» - Свойства – Включать в пользовательские настройки
3. Включаем «Использование копии базы данных» - Свойства – Включать в пользовательские настройки
Ну и формируем отчёт, сначала на проде (Рисунок 3) затем на копии (Рисунок 4), как видно цифры совпали, что несомненно радует!))))

❗️Механизм копии БД не работает с расширенными данными!!! Это крайне важно, так как мода на расширения, расширяющие данные сейчас прям повальная...

В ближайших релизах это станет доступно в версии PGRPOEnterprise.
Отдельное спасибо Андрею и Роману из Постгресс Профессиональный за проделанную работу и терпение!

Напоминаю про канал в MAX, мало ли...
  • 🔥 17
  • 👍 11
  • ❤ 6
  • 😱 1
Post #58 2.48K
1️⃣🔤 🔤🔤🔤 Копия базы данных 1С теперь работает и на репликах PostgresPRO

Это небольшой анонс серии постов, в один никак не смог уложить.

На прошлой неделе мы командами ИнфоСофт и Постгресс Профессиональный закончили тестирование работы физической реплики с механизмом копии базы данных 1С.

Раньше работа Копия БД была невозможна с физическими репликами PostgreSQL, так как на реплике нельзя было создавать временные таблицы и не только.

А ведь очень хотелось использовать реплики отказоустойчивого кластера для читающей нагрузки, а не только для отказоустойчивости.

Теперь это стало реальностью и позволит реализовать очень интересные сценарии работы высоконагруженных систем, точечно уведя читающую нагрузку на реплики.

И отдельное удовольствие состоит в том, что для направления выполнения отчёта на Копию БД не требуется разработчик 1С и его время, а требуется всего лишь пара кликов от пользователя 1С с достаточными правами.
  • 🔥 44
  • 👍 6
  • 👏 3
  • 🤔 2
  • 😱 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →