
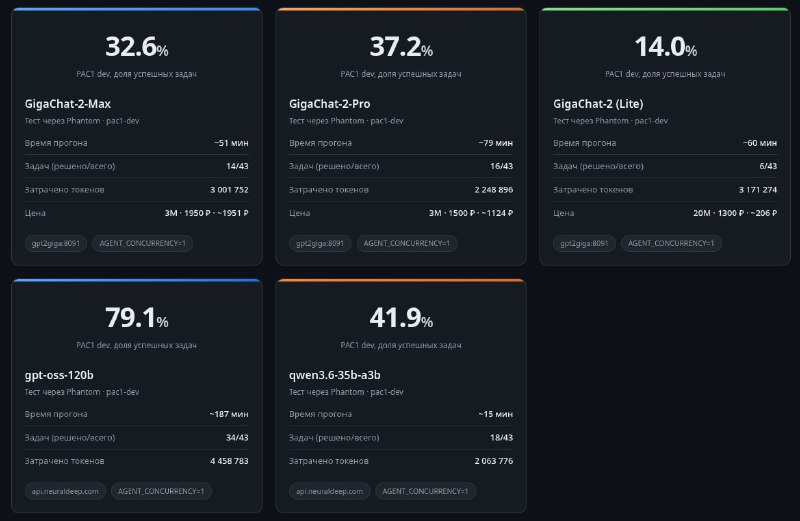

Для оценки семейства GigaChat-2 на агентном сценарии использован агент phantom-agent Валерия @neuraldeep, данный агент реализован в формате harness и ориентирован на бенчмарк BitGN PAC1 за авторством Рината @llm_under_hood.
Агент строит цикл ReAct с набором навыков и дашбордом, в README заявлен ориентир порядка ~86% на
pac1-dev на gpt-oss-120b.Методология
Прогоны выполнялись на датасете
pac1-dev, он меньше продового pac1-prod и даёт валидацию, поэтому корректность ответа по задаче проверялась сразу, без ожидания сервера BitGN, плюс видно на каких задачах были совершены ошибки.Тестирование проводилось в 1 поток (в один момент времени решается одна задача).
Тесты моделей GigaChat выполнялись через прокси gpt2giga на тестовом аккаунте, тесты моделей gpt-oss и qwen 3.6 через Hub Neuraldeep.
Во время проведения тестов gpt-oss зависла апишка BitGN на t30, поэтому тест пришлось перезапускать из-за чего такой высокий wall time, при прочих равных он должен быть на уровне qwen 3.6.
Эконономика
Для теста закуплены пакеты:
- GigaChat Max - 3M токенов за 1950 ₽
- GigaChat Pro - 3M токенов за 1500 ₽
- GigaChat Lite - 20M токенов за 1300 ₽
Оценка по купленным пакетам:
- Max: ~0,65 ₽ / 1K токенов (~650 ₽ / 1M)
- Pro: ~0,50 ₽ / 1K (~500 ₽ / 1M)
- Lite: ~0,065 ₽ / 1K (~65 ₽ / 1M)
В пересчёте на объём токенов цена укладывается в диапазон "дешёвый относительно тарифов OpenAI и Anthropic".
Результаты тестирования
Точность (доля успешных задач на PAC1-dev):
- 79.1% - GPT-OSS-120B
- 41.9% - Qwen 3.6 35B A3B
- 37,2% - GigaChat-2-Pro
- 32,6% - GigaChat-2-Max
- 14,0% - GigaChat-2 (Lite)
Время (затраченное на прогон 43 задач в 1 поток):
- GigaChat-2-Max: ~51 мин
- GigaChat-2-Pro: ~79 мин
- GigaChat-2 (Lite): ~60 мин
- GPT-OSS-120B: ~187 мин
- Qwen 3.6 35B A3B: ~15 мин
Итого
На бенчмарке
pac1-dev через агента Phantom семейство моделей GigaChat-2 показало низкий результат на агентных задачах представленных в соревновании BitGN, даже по сравнению с более слабыми on-premise моделями. При этом точность работы модели Max на агентных задачах ниже чем у модели Pro.PS. Была ещё идея провести тестирование публичный модели GigaChat 3.1 10B, но я уже ранее проводил её тестирование, результаты были слабые. Ещё очень хотелось бы провести тестирование модельки GigaChat 3.1 702B Ultra, но она к сожалению не доступна мне через API, а свободного железа чтобы запустить 702B модель под руками не имеется.