Во второй части мы попытались заменить
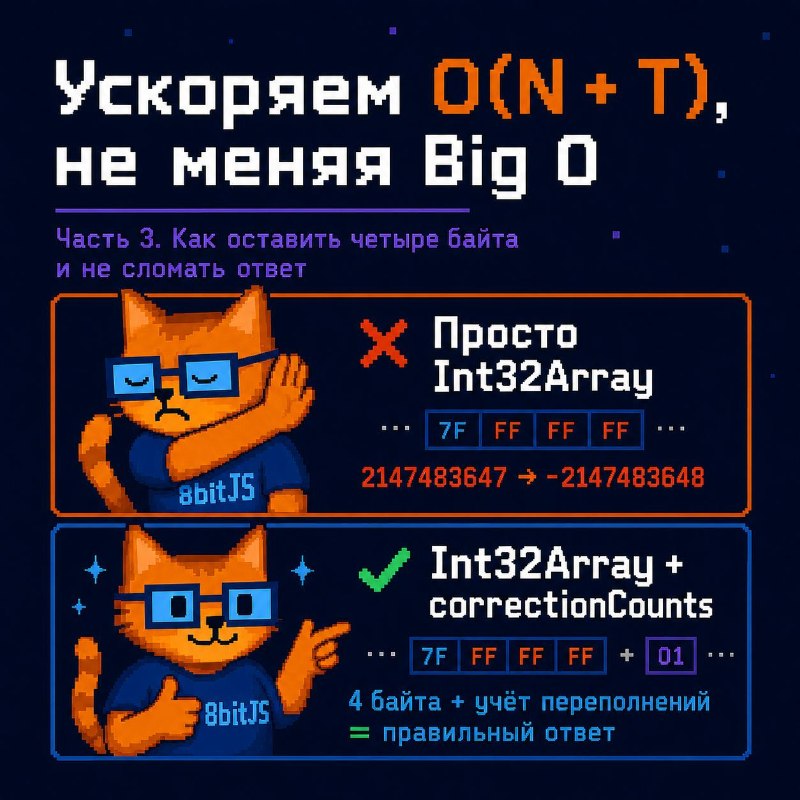
Float64Array на более компактный Int32Array и уменьшили размер разностного массива с 80 до 40 МБ.Но быстро выяснилось, что четыре байта могут незаметно изменить результат, так как сумма отдельных значений может не помещается в Int32.
Теперь перед нами стоит задача оставить экономию по памяти, но реализовать безопасное решение.
Разделяем число на две части
Полный диапазон 32-битного знакового целого у нас равен:
const INT_MIN = -2147483648;
const INT_MAX = 2147483647;
const INT_RANGE = 4294967296; // 2 ** 32
Основной массив продолжит хранить младшую 32-битную часть значения, а отдельный массив будет показывать, сколько полных диапазонов 2 32 нужно прибавить или вычесть.
При обновлении сначала вычисляем новое значение как обычный JavaScript
Number:const next = diff[index] + delta;
Пока результат находится внутри диапазона
Int32, ничего дополнительного не требуется:if (next >= INT_MIN && next <= INT_MAX) {
diff[index] = next;
}
Если значение вышло за границу, определяем количество переходов через полный 32-битный диапазон:
const carry = Math.floor(
  (next - INT_MIN) / INT_RANGE
);

diff[index] = next - carry * INT_RANGE;
correctionCounts[index] += carry;
В основной ячейке всегда остается значение, которое помещается в
Int32.Например, число
2 147 483 648 (выходи за границу на 1) представляется так:-2147483648 + 1 × 4294967296
Во время финального прохода исходное значение восстанавливается:
-2147483648 + 4294967296 = 2147483648
Основной массив занимает четыре байта на элемент, но итоговые вычисления выполняются как JavaScript
Number и сохраняют большие значения.Ленивое выделение памяти
Можно было бы сразу создать два массива, но при
T = 10 000 000 это снова около 80 МБ.Так как на большинстве входных данных переполнения отдельных ячеек вообще не происходит. Мы можем создать
correctionCounts только после первого реального переполнения.В обычном сценарии программа использует только основной
Int32Array. В худшем появляется второй массив, но уже не как обязательная плата за каждый запуск, а как запасной путь для данных, которые действительно требуют расширенного диапазона.Итог
Удалось сохранить компактный
Int32Array, не потеряв корректность вычислений. Разделили значения на базову часть и перенос. Обработали переполнение и восстановление отдельно.Алгоритм остался прежним
O(N + T), но память используется эффективнее.Что дальше
Несмотря на улучшения, остается проблема с записью событий в большой массив по почти случайным адресам, что плохо влияет на производительность.
В следующей части разберемся, как изменить структуру хранения данных, чтобы лучше использовать кэш процессора.