TGViewer
Channel Public Channel
JavaScript | LeetCode

JavaScript | LeetCode

@easy_frontend_task

Сайт: https://easyoffer.ru/
Все каналы: t.me/+xGeAw6ckJ4liYzQy

Контакт для рекламы: @sendme_ads
Subscribers
8.31K
Photos
248
Videos
1
Links
1.4K

Showing posts older than #2115 · Back to latest

Older Posts 20 shown
Post #2114 618
Задача: 186. Reverse Words in a String II
Сложность: medium

Дан массив символов s, переверните порядок слов.
Слово определяется как последовательность символов, не являющихся пробелами. Слова в s будут разделены одним пробелом.
Ваш код должен решать задачу на месте, то есть без выделения дополнительного пространства.

Пример:
Input: s = ["a"]
Output: ["a"]


👨‍💻 Алгоритм:

1️⃣Перевернуть всю строку: применить функцию reverse, которая переворачивает весь массив символов от начала до конца.

2️⃣Перевернуть каждое слово: пройти по всей строке, идентифицировать границы каждого слова и использовать функцию reverse для переворачивания символов в пределах каждого слова.

3️⃣Окончательная корректировка: проверить, чтобы между словами оставался только один пробел, и удалить лишние пробелы в начале и конце строки, если это необходимо.

😎 Решение:
class Solution {
reverseWords(s) {
s.reverse();
let start = 0, end = 0, n = s.length;

while (start < n) {
while (end < n && s[end] !== ' ') end++;
s.slice(start, end).reverse().copyWithin(s, start);
end++;
start = end;
}
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2113 617
Задача: 303. Range Sum Query - Immutable
Сложность: easy

Дан целочисленный массив nums. Обработайте несколько запросов следующего типа:
Вычислите сумму элементов массива nums между индексами left и right включительно, где left <= right.
Реализуйте класс NumArray:
- NumArray(int[] nums) Инициализирует объект с целочисленным массивом nums.
- int sumRange(int left, int right) Возвращает сумму элементов массива nums между индексами left и right включительно (т.е. nums[left] + nums[left + 1] + ... + nums[right]).

Пример:
Input
["NumArray", "sumRange", "sumRange", "sumRange"]
[[[-2, 0, 3, -5, 2, -1]], [0, 2], [2, 5], [0, 5]]
Output
[null, 1, -1, -3]


👨‍💻 Алгоритм:

1⃣Инициализация:
Создайте массив sum длиной на один элемент больше, чем массив nums, и заполните его накопленными суммами элементов массива nums.

2⃣Предварительное вычисление сумм:
Заполните массив sum, где каждый элемент sum[i + 1] является суммой всех предыдущих элементов массива nums до индекса i включительно.

3⃣Вычисление диапазонной суммы:
Для каждого запроса суммы элементов между индексами left и right используйте разницу между sum[right + 1] и sum[left], чтобы быстро получить результат.

😎 Решение:
class NumArray {
constructor(nums) {
this.sum = new Array(nums.length + 1).fill(0);
for (let i = 0; i < nums.length; i++) {
this.sum[i + 1] = this.sum[i] + nums[i];
}
}

sumRange(i, j) {
return this.sum[j + 1] - this.sum[i];
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2112 582
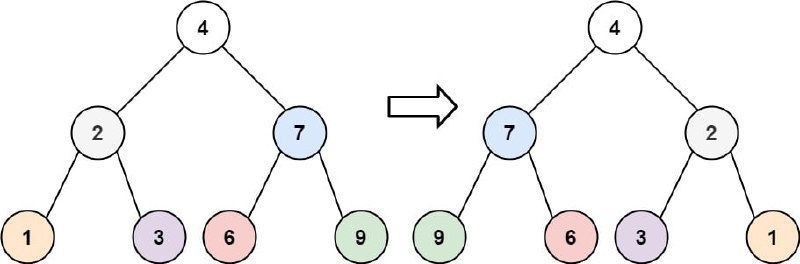
Задача: 226. Invert Binary Tree
Сложность: easy

Дан корень бинарного дерева, инвертируйте дерево и верните его корень.

Пример:
Input: root = [4,2,7,1,3,6,9]
Output: [4,7,2,9,6,3,1]


👨‍💻 Алгоритм:

1⃣Рекурсивная инверсия поддеревьев:
Если текущий узел (root) пустой, возвращаем null.
Рекурсивно инвертируем правое поддерево и сохраняем результат в переменную right.
Рекурсивно инвертируем левое поддерево и сохраняем результат в переменную left.

2⃣Обмен поддеревьев:
Устанавливаем левое поддерево текущего узла равным правому поддереву.
Устанавливаем правое поддерево текущего узла равным левому поддереву.

3⃣Возврат корня:
Возвращаем текущий узел (root) как новый корень инвертированного дерева.

😎 Решение:
function TreeNode(val, left, right) {
this.val = (val === undefined ? 0 : val)
this.left = (left === undefined ? null : left)
this.right = (right === undefined ? null : right)
}

var invertTree = function(root) {
if (root === null) {
return null;
}
const right = invertTree(root.right);
const left = invertTree(root.left);
root.left = right;
root.right = left;
return root;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2111 549
Задача: 1038. Binary Search Tree to Greater Sum Tree
Сложность: medium

Получив корень двоичного дерева поиска (BST), преобразуйте его в большее дерево таким образом, чтобы каждый ключ исходного BST был заменен на исходный ключ плюс сумма всех ключей, превышающих исходный ключ в BST. Напомним, что двоичное дерево поиска - это дерево, удовлетворяющее следующим ограничениям: левое поддерево узла содержит только узлы с ключами меньше, чем ключ узла. Правое поддерево узла содержит только узлы с ключами больше, чем ключ узла. И левое, и правое поддеревья должны быть двоичными деревьями поиска.

Пример:
Input: root = [4,1,6,0,2,5,7,null,null,null,3,null,null,null,8]
Output: [30,36,21,36,35,26,15,null,null,null,33,null,null,null,8]


👨‍💻 Алгоритм:

1⃣Обратный обход in-order:
Пройдите по дереву в порядке "правый, корень, левый" (обратный in-order обход). Это обеспечит посещение узлов в порядке убывания их значений.

2⃣Накопление суммы:
Во время обхода поддерживайте переменную для хранения накопленной суммы. На каждом узле добавляйте значение узла к накопленной сумме и обновляйте значение узла этой накопленной суммой.

3⃣Преобразование узлов:
Преобразуйте значение каждого узла в накопленную сумму.

😎 Решение:
function TreeNode(val, left, right) {
this.val = (val===undefined ? 0 : val)
this.left = (left===undefined ? null : left)
this.right = (right===undefined ? null : right)
}

var bstToGst = function(root) {
let sum = 0;

function reverseInorder(node) {
if (!node) return;
reverseInorder(node.right);
sum += node.val;
node.val = sum;
reverseInorder(node.left);
}

reverseInorder(root);
return root;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2110 561
Задача: 645. Set Mismatch
Сложность: easy

У вас есть набор целых чисел s, который изначально содержит все числа от 1 до n. К сожалению, из-за какой-то ошибки одно из чисел в s продублировалось в другое число в наборе, что привело к повторению одного числа и потере другого. Вам дан целочисленный массив nums, представляющий состояние данных в этом наборе после ошибки. Найдите число, которое встречается дважды, и число, которое отсутствует, и верните их в виде массива.

Пример:
Input: nums = [1,2,2,4]
Output: [2,3]


👨‍💻 Алгоритм:

1⃣Пройдите по массиву, используя набор для отслеживания чисел, чтобы определить дублированное число.

2⃣Определите отсутствующее число, используя сумму чисел от 1 до n и текущую сумму массива.

3⃣Верните дублированное и отсутствующее числа в виде массива.

😎 Решение:
var findErrorNums = function(nums) {
let numSet = new Set();
let duplicate = -1;
const n = nums.length;
for (let num of nums) {
if (numSet.has(num)) {
duplicate = num;
}
numSet.add(num);
}
let missing = (n * (n + 1)) / 2 - [...numSet].reduce((a, b) => a + b, 0);
return [duplicate, missing];
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2109 581
Задача: 187. Repeated DNA Sequences
Сложность: medium

ДНК состоит из серии нуклеотидов, обозначаемых как 'A', 'C', 'G' и 'T'.
Например, "ACGAATTCCG" — это последовательность ДНК.
При изучении ДНК полезно определять повторяющиеся последовательности внутри молекулы ДНК.
Дана строка s, представляющая последовательность ДНК. Верните все последовательности длиной 10 букв (подстроки), которые встречаются более одного раза в молекуле ДНК. Ответ можно возвращать в любом порядке.

Пример:
Input: s = "AAAAACCCCCAAAAACCCCCCAAAAAGGGTTT"
Output: ["AAAAACCCCC","CCCCCAAAAA"]


👨‍💻 Алгоритм:

1️⃣Перебираем начальные позиции последовательности от 1 до 𝑁−𝐿, где 𝑁 — длина строки, а 𝐿 — длина подстроки (в данном случае 10):
Если начальная позиция 𝑠𝑡𝑎𝑟𝑡==0, вычисляем хеш первой последовательности 𝑠[0:𝐿].
В противном случае вычисляем скользящий хеш из предыдущего значения хеша.

2️⃣Проверяем хеш в хешсете:
Если хеш уже существует в хешсете, значит, мы нашли повторяющуюся последовательность, и пора обновить вывод.
В противном случае добавляем хеш в хешсет.

3️⃣Возвращаем список вывода, содержащий все повторяющиеся последовательности.

😎 Решение:
class Solution {
largestNumber(nums) {
const strNums = nums.map(String);
strNums.sort((a, b) => (b + a).localeCompare(a + b));
if (strNums[0] === "0") {
return "0";
}
return strNums.join('');
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2108 584
Задача: 470. Implement Rand10() Using Rand7()
Сложность: medium

Дано API rand7(), которое генерирует случайное целое число в диапазоне [1, 7]. Напишите функцию rand10(), которая генерирует случайное целое число в диапазоне [1, 10]. Вы можете вызывать только API rand7(), и не должны вызывать другие API. Пожалуйста, не используйте встроенные в язык функции для генерации случайных чисел.

Каждый тестовый случай будет содержать один внутренний аргумент n, который указывает количество вызовов вашей реализованной функции rand10() во время тестирования. Обратите внимание, что это не аргумент, передаваемый в rand10().

Пример:
Input: n = 1
Output: [2]


😎 Решение:
var rand10 = function() {
let row, col, idx;
do {
row = rand7();
col = rand7();
idx = col + (row - 1) * 7;
} while (idx > 40);
return 1 + (idx - 1) % 10;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2107 521
Задача: 609. Find Duplicate File in System
Сложность: medium

Получив список paths информации о каталоге, включающий путь к каталогу и все файлы с содержимым в этом каталоге, верните все дубликаты файлов в файловой системе по их путям. Вы можете вернуть ответ в любом порядке. Группа дубликатов состоит как минимум из двух файлов с одинаковым содержимым. Одна строка информации о каталоге во входном списке имеет следующий формат: "root/d1/d2/.../dm f1.txt(f1_content) f2.txt(f2_content) ... fn.txt(fn_content)" Это означает, что в каталоге "root/d1/d2/.../dm" имеется n файлов (f1.txt, f2.txt ... fn.txt) с содержимым (f1_content, f2_content ... fn_content) соответственно. Обратите внимание, что n >= 1 и m >= 0. Если m = 0, это означает, что каталог является только корневым. На выходе получается список групп дублирующихся путей к файлам. Для каждой группы он содержит все пути к файлам, которые имеют одинаковое содержимое. Путь к файлу - это строка, имеющая следующий формат: "каталог_путь/имя_файла.txt".

Пример:
Input: paths = ["root/a 1.txt(abcd) 2.txt(efgh)","root/c 3.txt(abcd)","root/c/d 4.txt(efgh)","root 4.txt(efgh)"]
Output: [["root/a/2.txt","root/c/d/4.txt","root/4.txt"],["root/a/1.txt","root/c/3.txt"]]


👨‍💻 Алгоритм:

1⃣Пройдите по списку путей, разберите каждый путь и соберите информацию о содержимом файлов и соответствующих им путях.

2⃣Используйте словарь для хранения списков путей файлов, сгруппированных по их содержимому.

3⃣Пройдите по словарю и соберите группы дубликатов, содержащие как минимум два пути.

😎 Решение:
function findDuplicate(paths) {
const contentToFilePaths = {};

for (const path of paths) {
const parts = path.split(" ");
const root = parts[0];

for (let i = 1; i < parts.length; i++) {
const [fileName, content] = parts[i].split("(");
const filePath = `${root}/${fileName}`;
const contentKey = content.slice(0, -1);

if (!contentToFilePaths[contentKey]) {
contentToFilePaths[contentKey] = [];
}
contentToFilePaths[contentKey].push(filePath);
}
}

return Object.values(contentToFilePaths).filter(paths => paths.length > 1);
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2106 523
Задача: 129. Sum Root to Leaf Numbers
Сложность: medium

Вам дан корень бинарного дерева, содержащего только цифры от 0 до 9.
Каждый путь от корня до листа в дереве представляет собой число.
Например, путь от корня до листа 1 -> 2 -> 3 представляет число 123.
Верните общую сумму всех чисел от корня до листа. Тестовые случаи созданы таким образом, что ответ поместится в 32-битное целое число.
Листовой узел — это узел без детей.

Пример:
Input: root = [1,2,3]
Output: 25
Explanation:
The root-to-leaf path 1->2 represents the number 12.
The root-to-leaf path 1->3 represents the number 13.
Therefore, sum = 12 + 13 = 25.


👨‍💻 Алгоритм:

1️⃣Инициализация:

Создайте переменные для хранения суммы чисел (rootToLeaf) и текущего числа (currNumber), а также стек для обхода дерева, начиная с корневого узла.

2️⃣Обход дерева:
Используйте стек для глубинного обхода дерева (DFS), обновляя currNumber путём умножения на 10 и добавления значения узла. Для каждого листа добавляйте currNumber к rootToLeaf.

3️⃣Возвращение результата:
По завершении обхода всех узлов возвращайте rootToLeaf, содержащую сумму всех чисел от корня до листьев дерева.

😎 Решение:
function sumNumbers(root, partialSum = 0) {
if (!root) {
return 0;
}
partialSum = partialSum * 10 + root.val;
if (!root.left && !root.right) {
return partialSum;
}
return (
sumNumbers(root.left, partialSum) + sumNumbers(root.right, partialSum)
);
}


Ставь 👍 и забирай 📚 Базу знаний
  • 👍 2
Post #2105 543
Задача: 742. Closest Leaf in a Binary Tree
Сложность: medium

Если задан корень бинарного дерева, в котором каждый узел имеет уникальное значение, а также задано целое число k, верните значение ближайшего к цели k узла листа дерева. Ближайший к листу узел означает наименьшее количество ребер, пройденных бинарным деревом, чтобы достичь любого листа дерева. Кроме того, узел называется листом, если у него нет дочерних узлов.

Пример:
Input: root = [1,3,2], k = 1
Output: 2


👨‍💻 Алгоритм:

1⃣Пройдите дерево, чтобы найти путь от корня до узла k и сохранить его в список.

2⃣Найдите все листья и минимальное расстояние до них, используя BFS, начиная с найденного узла k.

3⃣Верните значение ближайшего листа.

😎 Решение:
class TreeNode {
constructor(val=0, left=null, right=null) {
this.val = val;
this.left = left;
this.right = right;
}
}

var findClosestLeaf = function(root, k) {
function findPath(node, k, path) {
if (!node) return false;
path.push(node);
if (node.val === k) return true;
if ((node.left && findPath(node.left, k, path)) || (node.right && findPath(node.right, k, path))) return true;
path.pop();
return false;
}

function findLeaves(node, leaves) {
if (!node) return;
if (!node.left && !node.right) leaves.set(node, 0);
findLeaves(node.left, leaves);
findLeaves(node.right, leaves);
}

let path = [];
findPath(root, k, path);

let leaves = new Map();
findLeaves(root, leaves);

let queue = [[path[path.length - 1], 0]];
let visited = new Set();

while (queue.length) {
let [node, dist] = queue.shift();
if (leaves.has(node)) return node.val;
visited.add(node);
if (node.left && !visited.has(node.left)) queue.push([node.left, dist + 1]);
if (node.right && !visited.has(node.right)) queue.push([node.right, dist + 1]);
if (path.length > 1) queue.push([path.pop(), dist + 1]);
}
return -1;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2103 587
Задача: 130. Surrounded Regions
Сложность: medium

Вам дана матрица размером m на n, которая содержит буквы 'X' и 'O'. Захватите регионы, которые окружены:
Соединение: Ячейка соединена с соседними ячейками по горизонтали или вертикали.
Регион: Для формирования региона соедините каждую ячейку 'O'.
Окружение: Регион окружён ячейками 'X', если можно соединить регион с ячейками 'X', и ни одна из ячеек региона не находится на краю доски.
Окруженный регион захватывается путём замены всех 'O' на 'X' в исходной матрице.

Пример:
Input: board = [["X"]]

Output: [["X"]]


👨‍💻 Алгоритм:

1️⃣Выбор начальных ячеек и инициация DFS:
Начинаем с выбора всех ячеек, расположенных на границах доски.
Затем, начиная с каждой выбранной ячейки на границе, выполняем обход в глубину (DFS).

2️⃣Логика и выполнение DFS:
Если ячейка на границе оказывается 'O', это означает, что эта ячейка "жива", вместе с другими ячейками 'O', соединёнными с этой граничной ячейкой. Две ячейки считаются соединёнными, если между ними существует путь, состоящий только из букв 'O'.
Цель нашего обхода DFS будет заключаться в том, чтобы отметить все такие связанные ячейки 'O', которые исходят из границы, каким-либо отличительным символом, например, 'E'.

3️⃣Классификация и финальная обработка ячеек:
После обхода всех граничных ячеек мы получаем три типа ячеек:
Ячейки с буквой 'X': эти ячейки можно считать стеной.
Ячейки с буквой 'O': эти ячейки не затрагиваются в нашем обходе DFS, то есть они не имеют соединения с границей, следовательно, они захвачены. Эти ячейки следует заменить на букву 'X'.
Ячейки с буквой 'E': это ячейки, отмеченные в ходе нашего обхода DFS, то есть ячейки, имеющие хотя бы одно соединение с границами, следовательно, они не захвачены. В результате мы должны вернуть этим ячейкам их исходную букву 'O'.

😎 Решение:
var solve = function (board) {
if (board == null || board.length == 0) {
return;
}
let ROWS = board.length;
let COLS = board[0].length;
let borders = [];
for (let r = 0; r < ROWS; ++r) {
borders.push([r, 0]);
borders.push([r, COLS - 1]);
}
for (let c = 0; c < COLS; ++c) {
borders.push([0, c]);
borders.push([ROWS - 1, c]);
}
borders.forEach((pair) => {
dfs(board, pair[0], pair[1]);
});
for (let r = 0; r < ROWS; ++r) {
for (let c = 0; c < COLS; ++c) {
if (board[r][c] == "O") board[r][c] = "X";
if (board[r][c] == "E") board[r][c] = "O";
}
}
function dfs(board, row, col) {
if (board[row][col] != "O") return;
board[row][col] = "E";
if (col < COLS - 1) dfs(board, row, col + 1);
if (row < ROWS - 1) dfs(board, row + 1, col);
if (col > 0) dfs(board, row, col - 1);
if (row > 0) dfs(board, row - 1, col);
}
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2102 533
Задача: 213. House Robber II
Сложность: medium

Вы профессиональный грабитель, планирующий ограбить дома вдоль улицы. В каждом доме спрятано определенное количество денег. Все дома в этом месте расположены по кругу, что означает, что первый дом является соседом последнего. Между тем, в соседних домах установлена охранная система, которая автоматически свяжется с полицией, если два соседних дома будут взломаны в одну ночь.
Дан массив целых чисел nums, представляющий количество денег в каждом доме, верните максимальную сумму денег, которую вы можете ограбить этой ночью, не вызвав полицию.

Пример 1:
Input: nums = [1,2,3,1]
Output: 4
Explanation: Rob house 1 (money = 1) and then rob house 3 (money = 3).
Total amount you can rob = 1 + 3 = 4.


👨‍💻 Алгоритм:

1️⃣ Обработка базовых случаев:
Если массив nums пуст, возвращаем 0.
Если в массиве nums только один дом, возвращаем значение этого дома.

2️⃣ Разделение задачи на две подзадачи:
Находим максимальную сумму для подмассива домов от первого до предпоследнего, вызывая функцию robSimple с параметрами 0 и nums.length - 2.
Находим максимальную сумму для подмассива домов от второго до последнего, вызывая функцию robSimple с параметрами 1 и nums.length - 1.

3️⃣ Сравнение результатов и возврат максимального значения:
Вернуть максимальное значение из двух полученных результатов.

😎 Решение:
class Solution {
rob(nums) {
if (nums.length === 0) return 0;
if (nums.length === 1) return nums[0];

let max1 = this.robSimple(nums, 0, nums.length - 2);
let max2 = this.robSimple(nums, 1, nums.length - 1);

return Math.max(max1, max2);
}

robSimple(nums, start, end) {
let t1 = 0;
let t2 = 0;

for (let i = start; i <= end; i++) {
let temp = t1;
let current = nums[i];
t1 = Math.max(current + t2, t1);
t2 = temp;
}

return t1;
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2101 537
Задача: 341. Flatten Nested List Iterator
Сложность: medium

Вам дан вложенный список целых чисел nestedList. Каждый элемент либо является целым числом, либо списком, элементы которого также могут быть целыми числами или другими списками. Реализуйте итератор для его развёртки.

Реализуйте класс NestedIterator:

NestedIterator(List<NestedInteger> nestedList) Инициализирует итератор вложенным списком nestedList.
int next() Возвращает следующий целый элемент вложенного списка.
boolean hasNext() Возвращает true, если в вложенном списке еще остались целые числа, и false в противном случае.

Пример:
Input: nestedList = [[1,1],2,[1,1]]
Output: [1,1,2,1,1]
Explanation: By calling next repeatedly until hasNext returns false, the order of elements returned by next should be: [1,1,2,1,1].


👨‍💻 Алгоритм:

1⃣Инициализация
Сохраняйте исходный вложенный список в стеке или очереди. Используйте стек для сохранения состояния итерации по вложенным спискам.

2⃣Метод next()
Возвращает следующий целый элемент из стека или очереди. Если текущий элемент является списком, развёртывайте его и добавляйте элементы в стек.

3⃣Метод hasNext()
Проверяет, есть ли в стеке или очереди оставшиеся целые элементы. Если на вершине стека находится список, развёртывайте его до тех пор, пока не встретится целый элемент.

😎 Решение:
var NestedIterator = function(nestedList) {
this.stack = [];
this.flatten(nestedList);
};

NestedIterator.prototype.flatten = function(nestedList) {
for (let i = nestedList.length - 1; i >= 0; i--) {
this.stack.push(nestedList[i]);
}
};

NestedIterator.prototype.next = function() {
return this.stack.pop().getInteger();
};

NestedIterator.prototype.hasNext = function() {
while (this.stack.length > 0 && !this.stack[this.stack.length - 1].isInteger()) {
this.flatten(this.stack.pop().getList());
}
return this.stack.length > 0;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2100 520
Задача: 1101. The Earliest Moment When Everyone Become Friends
Сложность: medium

В социальной группе есть n человек, пронумерованных от 0 до n - 1. Вам дан массив logs, где logs[i] = [timestampi, xi, yi] указывает, что xi и yi станут друзьями в момент времени timestampi.

Дружба является симметричной. Это означает, что если a является другом b, то b является другом a. Также человек a знаком с человеком b, если a является другом b или a является другом кого-то, кто знаком с b.

Верните самое раннее время, когда каждый человек стал знаком с каждым другим человеком. Если такого времени не существует, верните -1.

Пример:
Input: logs = [[0,2,0],[1,0,1],[3,0,3],[4,1,2],[7,3,1]], n = 4
Output: 3
Explanation: At timestamp = 3, all the persons (i.e., 0, 1, 2, and 3) become friends.


👨‍💻 Алгоритм:

1⃣Отсортируйте логи по времени в хронологическом порядке, так как в задаче не указано, отсортированы ли они.

2⃣Пройдитесь по отсортированным логам, применяя структуру данных "Объединение-Поиск":
Для каждого лога объедините двух участников, упомянутых в логе, с помощью функции union(a, b).
Каждое объединение добавляет новые связи между участниками.

3⃣Следите за количеством групп:
Изначально каждый участник рассматривается как отдельная группа.
Количество групп уменьшается с каждым полезным объединением.
Момент, когда количество групп уменьшается до одной, является самым ранним моментом, когда все участники становятся связанными (друзьями). Верните этот момент времени.
Если такого момента не существует, верните -1.

😎 Решение:
class UnionFind {
constructor(n) {
this.parent = Array.from({ length: n }, (_, i) => i)
this.rank = Array(n).fill(1)
}

find(x) {
if (this.parent[x] !== x) {
this.parent[x] = this.find(this.parent[x])
}
return this.parent[x]
}

union(x, y) {
const rootX = this.find(x)
const rootY = this.find(y)

if (rootX !== rootY) {
if (this.rank[rootX] > this.rank[rootY]) {
this.parent[rootY] = rootX
} else if (this.rank[rootX] < this.rank[rootY]) {
this.parent[rootX] = rootY
} else {
this.parent[rootY] = rootX
this.rank[rootX]++
}
return true
}
return false
}
}

var earliestAcq = function(logs, n) {
logs.sort((a, b) => a[0] - b[0])
const uf = new UnionFind(n)
let groupCount = n

for (const [timestamp, friendA, friendB] of logs) {
if (uf.union(friendA, friendB)) {
groupCount--
}
if (groupCount === 1) {
return timestamp
}
}

return -1
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2099 560
Задача: 1353. Maximum Number of Events That Can Be Attended
Сложность: medium

Дан массив событий, где events[i] = [startDayi, endDayi]. Каждое событие i начинается в startDayi и заканчивается в endDayi.

Вы можете посетить событие i в любой день d, где startDayi <= d <= endDayi. Вы можете посещать только одно событие в любой момент времени d.

Верните максимальное количество событий, которые вы можете посетить.

Пример:
Input: events= [[1,2],[2,3],[3,4],[1,2]]
Output: 4


👨‍💻 Алгоритм:

1⃣Сортировка событий по времени завершения:
Сначала отсортируйте массив событий по времени окончания каждого события в порядке возрастания. Это позволит сначала рассматривать события, которые заканчиваются раньше.

2⃣Использование множества для отслеживания посещенных дней:
Создайте множество для хранения дней, в которые уже были посещены события. Это позволит легко проверять, был ли день уже использован для посещения другого события.

3⃣Посещение событий в доступные дни:
Пройдитесь по отсортированному массиву событий. Для каждого события проверьте каждый день от начала события до его окончания и найдите первый доступный день, который еще не был использован. Если такой день найден, добавьте его в множество и увеличьте счетчик посещенных событий.

😎 Решение:
var maxEvents = function(events) {
events.sort((a, b) => a[1] - b[1]);
let visitedDays = new Set();
let count = 0;

for (let [start, end] of events) {
for (let day = start; day <= end; day++) {
if (!visitedDays.has(day)) {
visitedDays.add(day);
count++;
break;
}
}
}

return count;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2098 519
Сложность: medium
Задача: 556. Next Greater Element III

Мы можем перемешать строку s, чтобы получить строку t, используя следующий алгоритм:
Дано положительное целое число n. Найдите наименьшее целое число, которое имеет точно такие же цифры, как и число n, и больше самого числа n по значению. Если такого положительного целого числа не существует, верните -1.
Учтите, что возвращенное число должно помещаться в 32-битное целое число. Если существует допустимый ответ, но он не помещается в 32-битное целое число, верните -1.

Пример:
Input: n = 12
Output: 21


👨‍💻 Алгоритм:

1⃣Нахождение и перестановка цифр
Преобразуйте число n в массив цифр. Найдите первую цифру, которая нарушает убывающий порядок (с конца массива). Назовем её индексом i. Найдите первую цифру, которая больше digits[i-1] (с конца массива). Назовем её индексом j. Поменяйте местами цифры на позициях i-1 и j.

2⃣Обратный порядок оставшихся цифр
Обратный порядок части массива от индекса i до конца, чтобы получить наименьшую перестановку, которая больше исходной.

3⃣Проверка результата и преобразование обратно в число
Преобразуйте массив цифр обратно в число. Если число превышает 32-битный предел, верните -1. В противном случае верните полученное число.

😎 Решение:
class Solution {
swap(s, i0, i1) {
if (i0 === i1) return s;
let chars = s.split('');
[chars[i0], chars[i1]] = [chars[i1], chars[i0]];
return chars.join('');
}

constructor() {
this.list = [];
}

permute(a, l, r) {
if (l === r) {
this.list.push(a);
} else {
for (let i = l; i <= r; i++) {
a = this.swap(a, l, i);
this.permute(a, l + 1, r);
a = this.swap(a, l, i);
}
}
}

nextGreaterElement(n) {
let s = '' + n;
this.permute(s, 0, s.length - 1);
this.list.sort();
let index = this.list.indexOf(s);
if (index !== -1 && index < this.list.length - 1) {
let result = parseInt(this.list[index + 1]);
if (result <= 2147483647) {
return result;
}
}
return -1;
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2097 538
Задача: 207. Course Schedule
Сложность: medium

Всего у вас есть numCourses курсов, которые нужно пройти, пронумерованных от 0 до numCourses - 1. Вам дан массив prerequisites, где prerequisites[i] = [ai, bi] указывает на то, что вы должны сначала пройти курс bi, если хотите взять курс ai.
Например, пара [0, 1] указывает на то, что для прохождения курса 0 сначала нужно пройти курс 1.
Верните true, если вы можете завершить все курсы. В противном случае верните false.

Пример:
Input: numCourses = 2, prerequisites = [[1,0]]
Output: true
Explanation: There are a total of 2 courses to take.
To take course 1 you should have finished course 0. So it is possible.


👨‍💻 Алгоритм:

1️⃣Создайте массив indegree длины n, где indegree[x] хранит количество входящих рёбер в узел x. Создайте список смежности adj, в котором adj[x] содержит все узлы с входящим ребром от узла x, то есть соседей узла x. Создайте этот список смежности, итерируя prerequisites. Для каждого prerequisites добавьте ребро от prerequisites[1] к prerequisites[0] и увеличьте indegree prerequisites[0] на 1.

2️⃣Инициализируйте очередь целых чисел q и начните алгоритм BFS, перемещаясь от листовых узлов к родительским узлам. Начните обход BFS, поместив все листовые узлы (indegree равное 0) в очередь. Создайте целочисленную переменную nodesVisited = 0 для подсчета количества посещенных узлов.

3️⃣Пока очередь не пуста:
Извлеките первый узел из очереди.
Увеличьте nodesVisited на 1.
Для каждого соседа (узлы, которые имеют входящее ребро от узла) узла уменьшите indegree[neighbor] на 1, чтобы удалить ребро node -> neighbor.
Если indegree[neighbor] == 0, это означает, что neighbor ведет себя как листовой узел, поэтому добавьте neighbor в очередь.
Если количество посещенных узлов меньше общего количества узлов, то есть nodesVisited < n, верните false, так как должен быть цикл. В противном случае, если nodesVisited == numCourses, верните true. Можно сократить это до просто возвращения nodesVisited == numCourses.

😎 Решение:
class Solution {
canFinish(numCourses, prerequisites) {
const indegree = new Array(numCourses).fill(0);
const adj = Array.from({ length: numCourses }, () => []);

for (const [a, b] of prerequisites) {
adj[b].push(a);
indegree[a]++;
}

const q = [];
for (let i = 0; i < numCourses; i++) {
if (indegree[i] === 0) {
q.push(i);
}
}

let nodesVisited = 0;
while (q.length > 0) {
const node = q.shift();
nodesVisited++;

for (const neighbor of adj[node]) {
indegree[neighbor]--;
if (indegree[neighbor] === 0) {
q.push(neighbor);
}
}
}

return nodesVisited === numCourses;
}
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2096 527
Задача: 437. Path Sum III
Сложность: medium

Дан корень бинарного дерева и целое число targetSum, вернуть количество путей, где сумма значений вдоль пути равна targetSum.
Путь не обязательно должен начинаться или заканчиваться в корне или на листе, но он должен идти вниз (т.е. перемещаться только от родительских узлов к дочерним).

Пример:
Input: root = [10,5,-3,3,2,null,11,3,-2,null,1], targetSum = 8
Output: 3
Explanation: The paths that sum to 8 are shown.


👨‍💻 Алгоритм:

1⃣Инициализируем счетчик путей в дереве count = 0 и хеш-таблицу h, где ключ - это префиксная сумма, а значение - сколько раз она встречалась. Выполним рекурсивный обход дерева в порядке preorder: узел -> левый -> правый. Функция preorder(node: TreeNode, curr_sum: int) принимает два аргумента: узел дерева и префиксную сумму перед этим узлом. Чтобы запустить рекурсию, вызовем preorder(root, 0).

2⃣Сначала обновим текущую префиксную сумму, добавив значение текущего узла: curr_sum += node.val. Теперь можно обновить счетчик. Рассмотрим две ситуации. В первой ситуации путь в дереве с целевой суммой начинается с корня. Это означает, что текущая префиксная сумма равна целевой сумме curr_sum == k, поэтому увеличиваем счетчик на 1: count += 1. Во второй ситуации путь с целевой суммой начинается где-то ниже. Это означает, что нужно добавить к счетчику количество раз, когда мы видели префиксную сумму curr_sum - target: count += h[curr_sum - target].

3⃣Логика проста: текущая префиксная сумма - это curr_sum, а несколько элементов назад префиксная сумма была curr_sum - target. Все элементы между ними суммируются до curr_sum - (curr_sum - target) = target. Теперь обновим хеш-таблицу: h[curr_sum] += 1. Проанализируем левое и правое поддеревья: preorder(node.left, curr_sum), preorder(node.right, curr_sum). После обработки текущего поддерева удалим текущую префиксную сумму из хеш-таблицы, чтобы не смешивать параллельные поддеревья: h[curr_sum] -= 1. Когда обход в порядке preorder завершен, счетчик обновлен. Вернем его.

😎 Решение:
var pathSum = function(root, sum) {
let count = 0
const k = sum
const h = new Map()
const preorder = (node, curr_sum) => {
if (!node) return
curr_sum += node.val
if (curr_sum === k) {
count++
}
count += (h.get(curr_sum - k) || 0)
h.set(curr_sum, (h.get(curr_sum) || 0) + 1)
preorder(node.left, curr_sum)
preorder(node.right, curr_sum)
h.set(curr_sum, h.get(curr_sum) - 1)
}
preorder(root, 0)
return count
}


Ставь 👍 и забирай 📚 Базу знаний
Post #2095 541
Задача: 333. Largest BST Subtree
Сложность: medium

Дан корень бинарного дерева, найдите самое большое поддерево, которое также является деревом бинарного поиска (BST), где "самое большое" означает поддерево с наибольшим количеством узлов.
Дерево бинарного поиска (BST) — это дерево, в котором все узлы соблюдают следующие свойства:
Значения в левом поддереве меньше значения их родительского (корневого) узла.
Значения в правом поддереве больше значения их родительского (корневого) узла.
Примечание: Поддерево должно включать всех своих потомков.

Пример:
Input: root = [10,5,15,1,8,null,7]
Output: 3
Explanation: The Largest BST Subtree in this case is the highlighted one. The return value is the subtree's size, which is 3.


👨‍💻 Алгоритм:

1⃣Пост-упорядоченный обход дерева:
Обходите каждую ноду дерева в пост-упорядоченном порядке (left-right-root). Это позволит гарантировать, что обе поддеревья ноды уже проверены на соответствие критериям BST перед проверкой самой ноды.

2⃣Проверка условий BST для каждой ноды:
Для каждой ноды определите минимальное и максимальное значения в её левом и правом поддеревьях. Проверьте, удовлетворяет ли текущее поддерево условиям BST:
- значение текущей ноды должно быть больше максимального значения в левом поддереве.
- значение текущей ноды должно быть меньше минимального значения в правом поддереве.
Если условия выполняются, вычислите размер текущего поддерева как сумму размеров левого и правого поддеревьев плюс 1 (для текущей ноды).

3⃣Возврат максимального размера BST:
Если текущее поддерево не является BST, верните максимальный размер BST из его левого или правого поддерева.
В конце рекурсивного обхода верните максимальный размер BST в дереве.

😎 Решение:
class TreeNode {
constructor(val = 0, left = null, right = null) {
this.val = val;
this.left = left;
this.right = right;
}
}

class NodeValue {
constructor(minNode, maxNode, maxSize) {
this.minNode = minNode;
this.maxNode = maxNode;
this.maxSize = maxSize;
}
}

var largestBSTSubtreeHelper = function(root) {
if (root === null) {
return new NodeValue(Number.MAX_SAFE_INTEGER, Number.MIN_SAFE_INTEGER, 0);
}

let left = largestBSTSubtreeHelper(root.left);
let right = largestBSTSubtreeHelper(root.right);

if (left.maxNode < root.val && root.val < right.minNode) {
return new NodeValue(Math.min(root.val, left.minNode), Math.max(root.val, right.maxNode),
left.maxSize + right.maxSize + 1);
}

return new NodeValue(Number.MIN_SAFE_INTEGER, Number.MAX_SAFE_INTEGER, Math.max(left.maxSize, right.maxSize));
};

var largestBSTSubtree = function(root) {
return largestBSTSubtreeHelper(root).maxSize;
};


Ставь 👍 и забирай 📚 Базу знаний
Post #2094 547
Задача: 1051. Height Checker
Сложность: easy

Школа пытается сделать ежегодную фотографию всех учеников. Учеников просят встать в одну шеренгу в неубывающем порядке по росту. Пусть этот порядок представлен целочисленным массивом expected, где expected[i] - ожидаемый рост i-го студента в очереди. Вам дан целочисленный массив heights, представляющий текущий порядок, в котором стоят студенты. Каждый heights[i] - это высота i-го студента в очереди (с индексом 0). Верните количество индексов, в которых heights[i] != expected[i].

Пример:
Input: heights = [1,1,4,2,1,3]
Output: 3


👨‍💻 Алгоритм:

1⃣Создай отсортированную копию массива heights, чтобы получить ожидаемый порядок высот.

2⃣Пройди по обоим массивам и сравни элементы.

3⃣Подсчитай количество индексов, где элементы двух массивов не равны

😎 Решение:
function heightChecker(heights) {
let expected = [...heights].sort((a, b) => a - b);
let count = 0;
for (let i = 0; i < heights.length; i++) {
if (heights[i] !== expected[i]) {
count++;
}
}
return count;
}


Ставь 👍 и забирай 📚 Базу знаний
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →