TGViewer
Channel Public Channel
Кодовой Барабанщик

Кодовой Барабанщик

@drummer_programmer

БлогеРОК программиста-барабанщика 👨‍💻🥁
Telegram: @GranSteL
YouTube: https://youtube.com/@granstel
ВКВидео: https://vkvideo.ru/@drummer_programmer
Subscribers
112
Photos
304
Videos
103
Links
175

Showing posts older than #523 · Back to latest

Older Posts 17 shown
Post #522 82
Дала жизнь агента, даст и клиента☯️
  • ❤ 3
Post #521 81
Способы применения нейронок: хаос-инженер 🤩

Иногда баг возникает в очень специфических условиях: большая конкуренция за ограниченные вычислительные ресурсы, нестабильная сеть, внезапно отвалившийся брокер сообщений, и т. п.

Однажды мне надо было починить нестабильный тест в пайплайне сборки, который в разных прогонах мог как пройти, так и упасть, без видимых на то причин. Причиной же было то, что пайпланы выполняются на не самых мощных раннерах, и как раз в условиях конкуренции могли не срабатывать условия для выполнения теста, то есть он был ещё и весьма хрупок.

На моём компе этот тест стабильно проходил, поэтому мне нужно был подобрать такие ограничивающие условия, при которых он начнёт падать, чтобы потом убедиться, что внесённое исправление действительно устраняет проблему 🪲

Сложность в том, что зависимость немонотонная: если ресурсов слишком много, все необходимые операции успевают выполниться вовремя. Если чересчур мало, то операции настолько медленны, что тоже, как ни странно, успешно выполняются. Надо было подобрать золотую середину в несколько итераций, что вручную может выполняться довольно долго.

Я попросил нейросеть помочь подобрать нужные параметры, и она стала итеративно запускать тест в контейнере с определёнными ограничениями и несколько раз прогонять его в таком окружении.

И это сработало: удалось получить воспроизводимое нестабильное поведение и проверить исправление 🎉

С обрывом связи похожая история. #ИИшница может воссоздать условия, в которых имитируется обрыв связи или отключение нужного сервиса. Вручную писать такое - тоже не самая простая задача, на отладку которой могла бы уйти куча времени ⏳

В общем, нейросеть позволяет довольно быстро подготовить эксперимент, запустить его, и получить воспроизводимый сценарий, и это ещё один интересный способ использовать ИИ в разработке: не только проанализировать код, но и испытать его в стрессовых условиях
  • 🔥 3
Post #520 74

Forwarded from Новости Яндекс Диалогов

Уважаемые разрабочики навыков, спешим поделиться новостью. Навыки перестают быть доступны в чате с Алисой AI и в мобильных приложениях.

Алиса постоянно развивается и технически меняется. В рамках этой эволюции мы были вынуждены отключить отображение и запуск развлекательных и познавательных навыков непосредственно в чате с Алисой AI и внутри мобильных приложений. Отметим, что навыки будут доступны пользователям на других платформах, например, на Яндекс Станциях.
В чате мы сейчас фокусируемся на тех сценариях, к которым пользователи наиболее часто обращаются. К сожалению, навыки в них не входят.

Мы постараемся позже вернуться к вам с небольшим рассказом о планах развития Диалогов.
  • 😱 1
Post #519 67
Уходит эпоха😢
Навыки Алисы 🙂 теперь доступны только на Яндекс станциях 🥹

Навыки перестают быть доступны в чате с Алисой AI и в мобильных приложениях. <...> сейчас фокусируемся на тех сценариях, к которым пользователи наиболее часто обращаются. К сожалению, навыки в них не входят

В целом, это заметно по снижающемуся траффику к Занимательным историям 💡

В чатах для меня, как разработчика, было хорошо то, что в них отображается реклама, и на монетизации с неё я оплачиваю инфраструктуру для игры. В последнее время доля показов так же снижается, так что бюджет теперь в минусе.
Надеюсь, что появится способ компенсировать этот утраченный канал монетизации. Но вообще есть ощущение, что навыки в целом перестают пользоваться спросом, поэтому не сегодня-завтра они в могут перестать работать в Алисе.

Думаю, я буду поддерживать игру, пока есть спрос (62 000 пользователей в месяц) и бюджет на инфру, а что будет дальше - увидим😃

Подробности ниже👇
Навыки Алисы Занимательные истории — навык Алисы, голосового помощника от Яндекса Добавьте в голосовой помощник Алису от Яндекса новый навык — Занимательные истории. Сочини забавные истории вместе с Алисой! Она попросит по очереди называть разные слова (имена, прилагательные, и другие). Потом она вставит эти слова в нужные места в тексте…
Post #518 56

Forwarded from C# Short Posts 🔞

Почти всё лето мы с тобой изучали внутрянку БД на примере #postgresql: от индексов мы спустились по Б+-деревьям до work mem и узнали насколько глубока восьмиикилобайтовая страница 📄

Теперь поплывём дальше 🛳
На нашей steam state machine мы пойдём по бурным рабочим потокам (worker thread), воочию увидим их освобождение на асинхронном водопаде, который приведёт нас к бескрайнему озеру памяти 🫡
Там мы увидим, как различные объекты сбились в несколько поколений кучи (heap), сдерживаемой лишь DOTNET_GCHeapHardLimitPercent. Некоторые из них довольно глубоко пустили корни, так что финализировать их приходится в несколько проходов, а некоторые оказались настолько холодными, что образовали свои айсберги Frozen object heap 🧊
В концов концов мы увидим, как, параллельно с другими, наша программа последовательно впадает в океан ЦПУ🤩 и выполняет своё предназначение в этом круговороте исполнения, печатая у тебя на экране заветные слова:

Hello, world!

По крайней мере таков горизонт нашего планирования, к которому мы стремимся 🌅
Возможно шторма жизни и обратной связи изменят наш с тобой курс, но мы всё равно будем стремиться к общей цели: лучше узнать платформу, на которой работаем 🗼и прочие #инженерныештучки

🧑‍💻dp🥁
Это #heavywednesday, мои чюваки
  • 👍 1
Post #517 58
Эскиз картинки к будущему посту в C# Short posts
  • 🔥 1
  • 😁 1
Post #516 61
Способы применения нейронок: аналитик кода 🔍

Часто говорят, что нейросети галлюцинируют 🤪
Обычно этим понятием объясняют явление, когда нейронка достраивать картину самостоятельно в условиях неопределённости 🤔

Если же дать нейросети, например, свою кодовую базу, и спросить что-нибудь по ней, вероятность ошибок становится значительно ниже, ведь ИИшнице не надо будет придумывать архитектуру с нуля, а лишь проанализировать то, что уже есть🧠

Особенно это полезно это, когда нужно разобраться в новом большом сервисе, который ты видишь впервые 🆕

Что интересного можно спросить у ИИ про твой код?


Отслеживание пути данных 🗺

Например, пока поле из базе данных попадёт на экран пользователя, оно может:

🟢 несколько раз переименоваться
🟢 пройти через DTO и мапперы
🟢 объединиться с другими полями
🟢 вычисляться на основе нескольких значений

Вручную восстановить такую цепочку бывает очень утомительно (особенно, когда путь проходит через несколько сервисов в разных репозиториях): нужно открыть десятки файлов, постоянно переключаться между ними и держать всё это в голове🤯

#ИИшница же способна довольно быстро собрать всю цепочку и показать её целиком⚡️


Диагностика сложных багов 🐞

Можно попросить нейросеть:

Проанализируй кодовую базу и найди возможные причинно-следственные связи, которые могли привести к <этому багу>. Покажи, на чём основан каждый вывод. Не додумывай, перепроверяй, уточняй


Иногда такой подход позволяет заметить зависимости, до которых вручную пришлось бы добираться очень долго


⚠️Важный момент про безопасность ⚠️

Анализировать корпоративный код нейросетью стоит только тогда, когда это разрешено политиками твоей компании

Если внутренние правила прямо запрещают передавать код внешним ИИ-сервисам, то делать этого, конечно, не стоит 🚫 Особенно если речь идёт о публичных облачных нейросетях, работающих за пределами корпоративного контура

Если же такого запрета нет, то хорошей практикой будет отключить использование ваших диалогов для обучения модели 🧠
У большинства популярных сервисов такая настройка есть. Это не только снижает вероятность использования ваших данных для обучения, но и в целом является хорошей практикой при работе с корпоративной информацией

А если в компании запрещено использовать внешние нейросети, то нередко есть альтернатива — внутренний ИИ-ассистент, развернутый внутри корпоративного контура 🏢
В этом случае лучше пользоваться именно им: кодовая база остаётся внутри инфраструктуры компании, а ты при этом всё равно получаешь преимущества анализа кода с помощью ИИ✨
  • ❤ 2
Post #515 72
Такой вот сюжет не так давно добавил в #занимательныеистории 🖥
  • ❤ 2
  • 👀 1
Post #514 87
Картинка дня 🌇

#ИИшница
  • ❤ 5
Post #512 84

Forwarded from C# Short Posts 🔞

🩺 Диагностика — как понять, на что ушла оперативка (часть 2, work_mem наносит ответный удар)

👈 Часть инструментов рассмотрели в прошлом посте, а в этом рассмотрим ещё парочку:

🧰 Что лежит в кэше прямо сейчас

Расширение pg_buffercache (мы его уже видели в посте про shared_buffers) показывает поимённо, какие страницы заняли кэш Postgres в данный момент. Удобно, когда надо понять, чем именно забиты те самые 128 MB, выданные под shared_buffers

👥 Кто сейчас активен (дикпик 3)
Кроме shared_buffers можно проверить и work_mem, чтобы узнать, сколько соединений работает и что они выполняют. Это показывает представление pg_stat_activity: оно построчно показывает каждое соединение, и там видно текущий запрос от клиента (app) и его состояние. Дальше пользуемся арифметикой work_mem × число операций × число активных соединений, чтобы получить объём памяти, занятый данными для операций

Чтобы при этом явно понять, какой клиент выполняет запрос, важно передавать его читаемое название через строку подключения или в запросе, тогда его название отобразится в app 🧠

⚠️ Ловушка при подсчёте памяти процессов
Если помнишь, каждое соединение в Postgres обслуживает отдельный процесс. Казалось бы, сложи память всех процессов и получишь общий расход. Но есть подвох: shared_buffers общий, и операционная система засчитывает его в память каждого процесса. Этот объём называют RSS (resident set size — объём оперативки, занятый процессом). Если просто сложить RSS всех бэкендов, общий shared_buffers посчитается много раз, и итог окажется сильно завышенным. Для суммирования правильнее брать PSS (proportional set size): он делит общую память поровну между процессами, которые ею пользуются

🧯 Если work_mem чересчур раздут
Если арифметика подтвердит, что в основном память выделена под обработку запросов, рецепт простой: уменьшить work_mem, сократить число соединений, или поставить перед базой пулер соединений. Пулер (например, PgBouncer) — это прослойка, которая держит небольшой набор постоянных соединений к Postgres и раздаёт их клиентам, что позволяет избежать выделение процесса на подключение каждого клиента. А отдельному тяжёлому запросу можно задать work_mem прямо в нём командой SET LOCAL (она меняет параметр в пределах текущей транзакции).

🅰️ Что унести с собой
🟢 Состав кэша показывает pg_buffercache. Кто сейчас активен, видно в pg_stat_activity
🟢 Складывать RSS процессов не стоит: общий shared_buffers задвоится. Для суммы есть PSS

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
  • ❤ 1
Post #510 148
Это мы с #хитпоинт вчера, сейчас дома уже 🤟
  • ❤ 4
Post #508 73
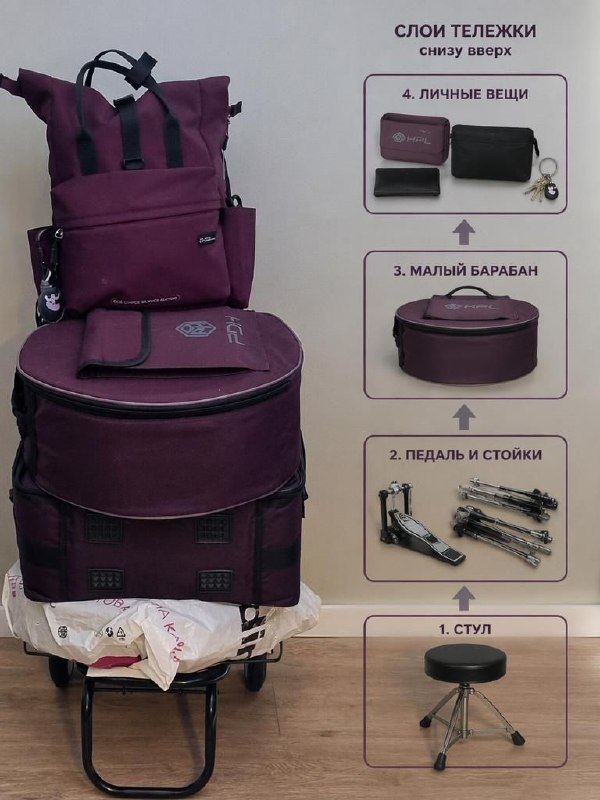
Мой stuff truck на сегодня: стул, педаль и стойки, и рюкзак с прочими приблудами. Чуть позже сюда добавится барабан и тарелки 🍽
Для сравнения, второе фото: stuff truck 27 марта, с которого начался мой #гастрольный_сезон🤘
Да, разницы особо нет, просто хотел намекнуть на то, что есть такой хэш-тег, который приведёт тебя на мой гастрольный график 📝
  • ❤ 2
Post #506 64

Forwarded from BarChuk

25го июля (суббота) в 20:00 потрясающий концерт в BarChuk!❤️‍🔥

Виолетта Орлова - певица, автор музыки и текстов. Вместе с группой ХИТПОИНТ она исполнит авторские песни и каверы в оригинальных рок-аранжировках. В каждой песне - своя история и глубокий смысл. Проникновенный голос солистки и живая музыка погрузят слушателя в свою уникальную атмосферу.

📒25 июля (суббота) в 20:00
📍BarChuk (Староваганьковский пер., 19с3)
❤Вход свободный
  • ❤‍🔥 4
  • ❤ 1
Post #504 69
Добавил в #занимательныеистории такой вот сюжет⚔️
Post #500 75

Forwarded from C# Short Posts 🔞

🩺 Диагностика — как понять, на что ушла оперативка (часть 1)

Мы с тобой разобрались с shared_buffers, кэш ОС и work_mem. Теперь можем понять, если на сервере память забита под завязку (как на дикпике из графаны), проблема это или норма, и куда смотреть в первую очередь 👀

📊 Доля попаданий в кэш (дикпик 1)
Первый вопрос — насколько хорошо данные ложатся в память. По каждой базе Postgres в pg_stat_database (системное представление, содержащее накопленную статистику по каждой базе данных в кластере) содержит два счётчика: blks_hit (сколько страниц нашлись прямо в shared_buffers) и blks_read (сколько пришлось дочитывать мимо него). Их отношение hit / (hit + read) называют долей попаданий в кэш (по-английски cache hit ratio) 🔖

На прогретой базе эта доля стремится к 99% и выше. У меня после прогрева вышло около 97.84%, а сразу после рестарта она была заметно ниже, потому что кэш ещё пустой.

Если доля стабильно низкая, это сигнал: рабочий набор (та часть данных, к которой реально обращаются запросы) не помещается в память, либо запросы идут мимо индексов и вычитывают всё подряд 📖

🔎 Разрез по таблицам и индексам (дикпик 2)
Одно общее число по базе мало о чём говорит. Чтобы понять, что конкретно не попадает в кэш, есть два представления: pg_statio_user_tables (счётчики чтений и попаданий по каждой таблице) и pg_statio_user_indexes (то же самое по каждому индексу). В нём сразу видно, какая таблица или какой индекс постоянно бегает на диск 💽

🅰️ Что унести с собой
🟢 Доля попаданий из pg_stat_database показывает, помещаются ли данные в память. Если она стабильно низкая, это повод разбираться
🟢 Представление о таблицах и индексах в кэше дают... представления pg_statio_user_tables и pg_statio_user_indexes

Ещё пару инструментов рассмотрим в следующем посте 👉

🧑‍💻dp🥁
#бд #postgresql #инженерныештучки #heavywednesday
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →