🌳 Индекс под капотомКогда добавляешь к таблице индекс по id, физически на диске появляется файл этого индекса, рядом с файлом кучи, которая содержит данные в страницах (блоках по 8KB). В файле индекса тоже есть страницы, в которых и хранится то самое B-дерево.
В самом начале файла индекса (в блоке 0) находится служебная метастраница, просто «визитка», которая хранит указатель на корень дерева и пару параметров. Она не является частью дерева: у неё нет родителя/детей, она не участвует в навигации по уровням.
📏
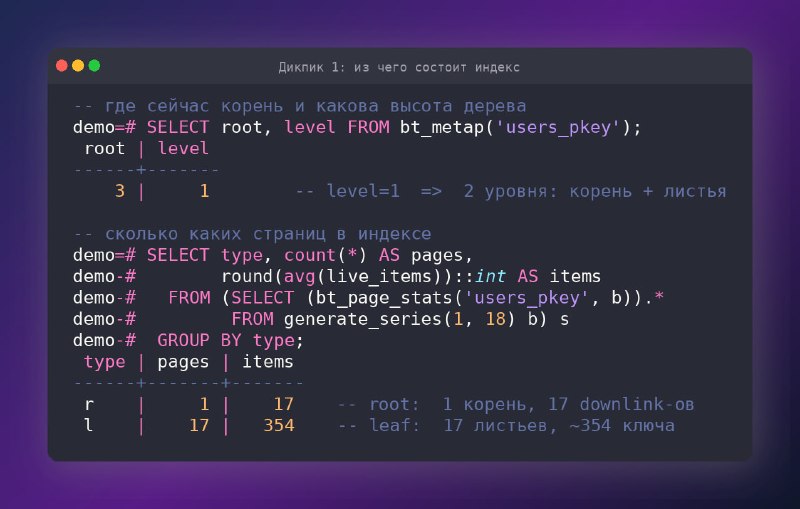
Из чего состоит дерево (Дикпик 1) Используем
bt_metap - функцию из расширения
pageinspect. Она читает метастраницу индекса и возвращает её содержимое: в каком блоке сейчас корень, на каком он уровне дерева, и пару служебных полей. У нас корень в блоке 3 внутри файла индекса
users_pkey (по смещению 3 × 8 KB).
С пониманием
level , то есть уровнем дерева, легко споткнуться: в PostgreSQL
листья - это уровень 0, и нумерация растёт вверх, к корню. Поэтому
level=1 означает «корень на один уровень выше листьев» → всего
2 уровня (листья на 0, корень на 1). Будь строк миллионы — стало бы
level=2: корень → ветви → листья.
Следующий запрос показывает содержимое дерева: 1 страница корня (
type: r) и 17 страниц листьев (
type: l).
🧭
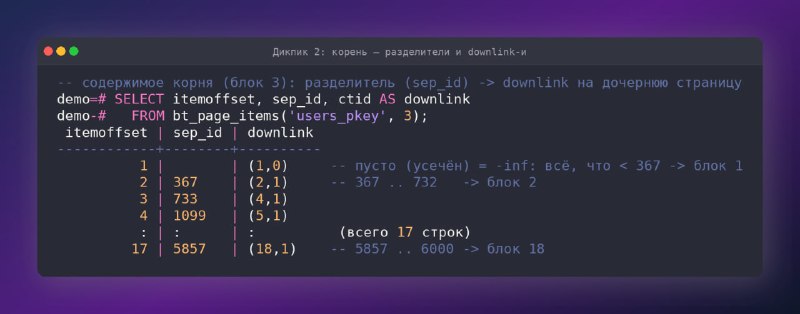
Что внутри корня (Дикпик 2) Корень - это не данные, а «оглавление», которое содержит 17 записей вида
разделитель (sep_id) → downlink (ссылка на дочерний лист (он же блок, он же страница)): «меньше 367 — блок 1; 367..732 — блок 2; …; от 5857 — блок 18». Числа 367, 733… - это границы маршрутизации.
Каждая запись в корне говорит: «вот сюда (downlink) идут ключи, начиная с такого-то значения». Самый верхний downlink должен ловить
всё, что меньше первой реальной границы — а нижней границы у него нет.
Поэтому у первой записи корня нет разделителя (ключ усечён до нуля атрибутов), а её downlink ведёт в первый лист: он совпадает с любым ключом, каким бы маленьким тот ни был.
Разделители
(sep_id) - это стыки между листьями, и их значения берутся из того, сколько ключей влезло в предыдущий лист. В один 8-килобайтный лист помещается
366 записей по
int: лист 1 (блок 1) держит
id 1…366. Когда он заполнился, 367-й ключ — первый, который туда уже не влез, — открывает следующий лист (блок 2). Вот это пограничное значение и поднимается в корень как разделитель: «ключи ≥ 367 → во второй лист, меньше → в первый».
То есть
367 = наименьший id второго листа.
🍃
Что внутри листа (Дикпик 3) А тут живут настоящие записи: пара
ключ id_key → heap_ctid, то есть указатель на строку в той самой куче. И смотри:
id_key=1 → (0,1),
id_key=121 → (0,121) — это ровно те же
ctid, что мы видели в посте про страницы! То есть индекс хранит значения
id по порядку и держит указатели на строки. Запись с
itemoffset = 1 - это high key, то есть верхняя граница этой страницы.
🔗
Итоговая картина (Дикпик 4) Как видно, индекс - это отдельный файл на диске, в котором метастраница и B-дерево - (корень + листья), итого 19 страниц. Куча
users — другой файл, со своими 50 страницами. Связь односторонняя: листья держат
ctid в кучу, но сама куча про индекс ничего не знает.
🏗
Любопытная детальПочему корень оказался в блоке 3?
ADD PRIMARY KEY собирает дерево
снизу вверх: блок 0 - мета, блок 1 - первый лист (пока без корня); он переполняется → создаётся второй лист (блок 2), и тут же рождается их общий родитель (корень) → ему достаётся блок 3.
🔎
Как в итоге ищется WHERE id = 59991) Метастраница индекса → корень (блок 3);
2)
5999 ≥ 5857 → последний лист (блок 18);
3) в листе берём
heap_ctid;
4) читаем одну heap-страницу.
⚡️~3 чтения вместо 50⚡️🅰️
Что унести с собой - PK-индекс - это отсортированный справочник «
id →
ctid»
- Индекс и таблица - это
разные файлы-
ctid на кучу живёт в листьях индекса
- Третий уровень (ветви между корнем и листьями) появляется лишь на сотнях тысяч строк - на 1 млн строк дерево уже трёхуровневое (корень → 10 ветвей → 2733 листа).
- Точечный поиск по PK - это 2–3 обращения к страницам, поэтому он «бесплатный» по ощущениям.
Команды, чтобы повторить и потыкать самому — в 👉
гисте 👉
#бд #postgresql #инженерныештучки