
Концепция InputStream - Reader - Buffered
С понятием InputStream мобильный разработчик сталкивается, когда нужно прочитать локальный файл или загрузить его по ссылке
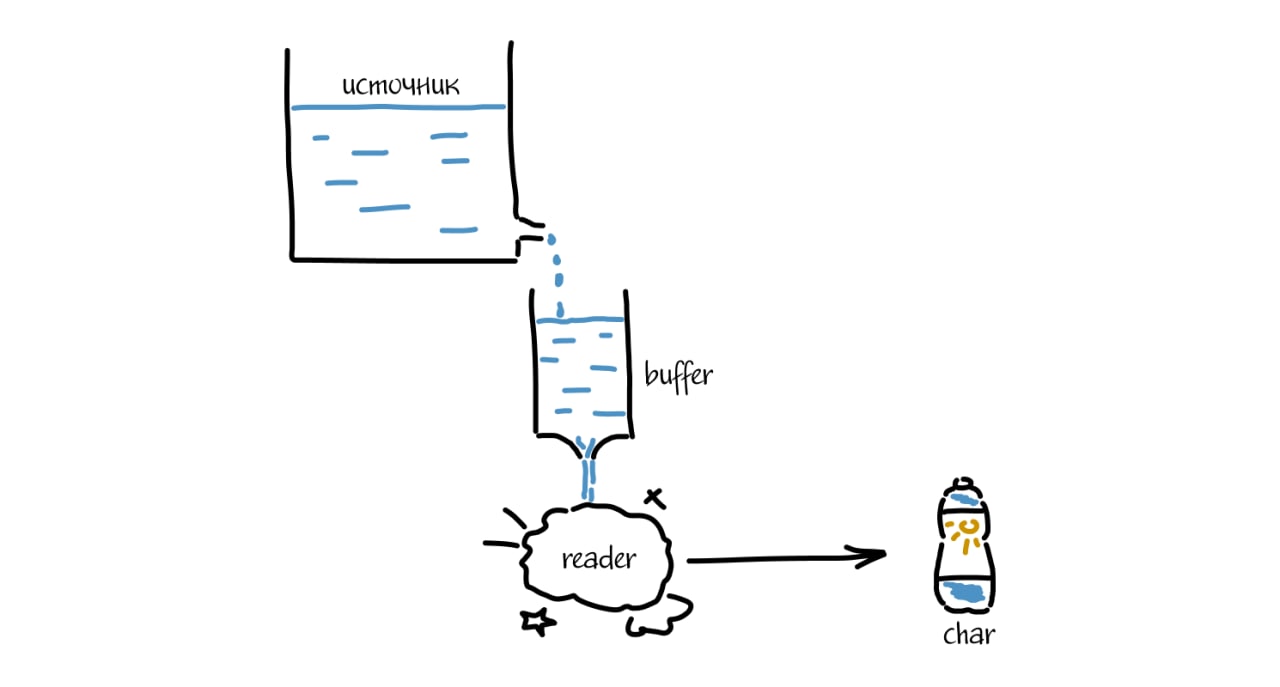
Общая логика считывания больших объемов данных (или данных неизвестного размера) следующая:
• InputStream (все его реализации) — класс, позволяющий обозначить источник данных (файл, ссылка, массив байтов...) и начать считывать его байт за байтом
• Reader (все его реализации) — класс, преобразующий байты, считываемые при помощи InputStream, в символы по заданной таблице кодирования (например, Unicode)
• Buffered (все его реализации) — класс, позволяющий ускорить процесс чтения за счет буферизации источника данных
Зачем буфер: если мы читаем файл с жесткого диска, то каждая операция запроса и переноса байтов с самого диска в оперативку занимает много времени. Потому нашей программе лучше за одно обращение считать n-байтов, а не один. Это справедливо для сетевых запросов
Комбинация реализаций позволяет считать данные в нужном формате и с оптимальными настройками буферизации
Та же самая история справедлива и для отдачи байтов: OutputStream - Writer - Buffered
....
загадка: по какой таблице кодирования Reader/Writer сопоставит байты и символы? откуда он ее возьмет - зашита в Java, определена в Android, задается JVM...?
Post #50
1.77K
- 🔥 5
- 👍 3
- ❤ 1