

Провёл небольшой эксперимент с индексом в Amber. Изначально поиск пересекающихся временных диапазонов был довольно простым: проходили по всем сегментам и проверяли, пересекается ли каждый из них с нужным диапазоном. Работало супер, но линейно. Первым решением было сделать бинарный интервальный индекс. Но в моменте ресерча я открыл для себя ещё и Learned Index, и понеслась...
В чём идея? А идея очень красивая.
Допустим, у нас есть массив с отсортированными ключами:
key: 10 20 30 40 50 60 70 80 90 1009
position: 0 1 2 3 4 5 6 7 8
Обычный индекс хранит структуру, по которой мы ищем нужную нам позицию, а наш сегодняшний гость предлагает посмотреть чуть иначе на ситуацию: зачем искать позицию, если можно ее предсказывать?
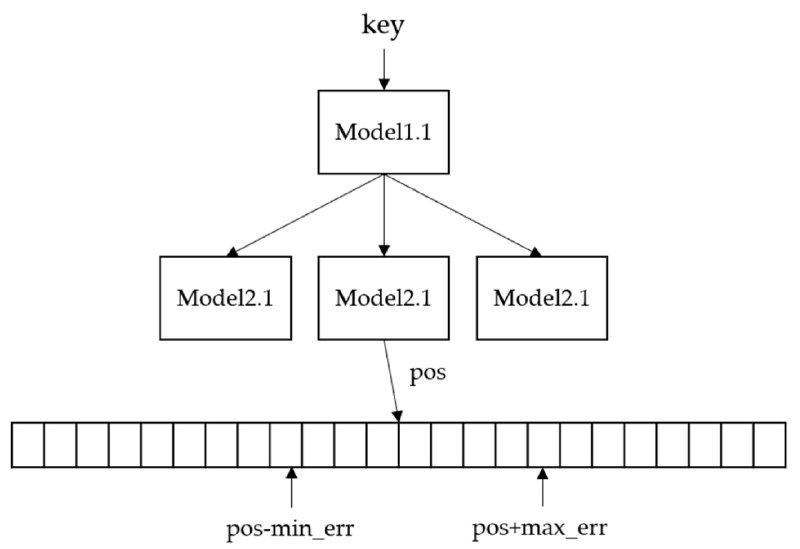
Моделька учит приближенную зависимоть ключа к позиции, и для любых ключей которые мы ищем модель будет отвечать так: "он где-то вот тут - [x:y]", тобишь мы получаем диапазон где точно есть ответ.
А что есть моделька начнет врать? допустим предсказывает позицию 8, а реальная позиция окажется 10, тут повляется prediction err, который говорит нам следующее - prediction это не точный ответ, а лишь отправная точка для поиска его. Мы должны проверять диапазон вокруг prediction, а не слепо верить что модель его угадала.
По существу в этом и есть вся суть Learning index - сужать поиск как можно сильнее, он не обязан угадывать позицию идеально 10 раз из 10, да и врятли когда-то будет, вся его работа просто как можно сильнее сузить область поиска.
Подробнее про Learning Index
Подробнее про интеграцию в amber и результатов