TGViewer
Channel Public Channel
struct dive_memo

struct dive_memo

@dive_memo

Dump of thoughts after readings

Author: @epikhinm
Subscribers
57
Photos
13
Videos
0
Links
11
Recent Posts 14 shown
Post #33 129
🪖 Saving Private Hash Join
#hashjoin #sortjoin #duckdb #bufferpool

📝 Article https://www.vldb.org/pvldb/vol18/p2748-kuiper.pdf

🪨 Context
Когда база данных делает join, она создает временные структуры, которые надо где-то хранить на время запроса.
Есть несколько вариантов где хранить: оперативная память или диск.
Есть два класса алгоритмов, которые предназначены для этого и они разные, в памяти выгодней hashjoin а на диске sort-merge join и переключаться между ними в процессе работы сложно.

Поэтому все базы данных делают обычно такой выбор из таких варинтов:
1. Делаем все в памяти на Hash Join, все что не влезает в оперативку, падаем и не поддерживаем. Сорян, докиньте больше оперативки или уменьшите объем данных в запросе.
2. Делаем все всегда на Sort-Merge Join, медленее, но зато всегда точно все посчитаем, не важно каких объемов.
3. Гибридные варианты: стараемся с помощью cost-based-optimiser понять влизаем ли в память, если да, то HashJoin, если нет, то Sort-Merge Join. Есть еще вариант всегда сначала HJ и фоллбек на SMJ.

Но всегда приходится платить:
1. Либо мы в первом варианте не можем посчитать большой join.
2. Либо мы можем, но всегда медленно.
3. В части случаев можем быстро, но как только HashJoin пересает влезать в память скорость запроса резко падает на порядок, мы встречаем -- Performance Cliff, про который видно часто в работах DuckDB.

В статье как раз рассказано как с этим Performance Cliff боролись.

🧂The idea
Обычно базы данных когда реализуют BufferPool, они разделяют его управление на две части:
* Persistent Block, страницы которые должны быть всегда загружены в память
* Transient Block, страницы, которые могут быть вытеснены когда есть memory pressure

В этой работе можно сказать что BufferPool общий, и внутри него страницы отмечаются можно их вытеснять или нет.
У каждой страницы при этом, в отличии от обычной Linux Memory Page есть дополнительная информация о том участвует ли она в текущем запросе, какая это партиция джойна и прочее.
В результате можно сказать что это более эффективная реализация Linux Page Cache с учетом знаний о том что и как правильно вытеснять.

Страницы достаточно большие чтобы их было выгодно писать на NVM'e без большого overhead, eviction асинхронный относительно остальных процессов.
На графиках ребята как раз и показывают, что такой механизмов позволяет им запускать более ресурсоемкие запросы, чем те которые могут прожевать остальные -- postgresql, umbra и прочие. Они либо отстреливаются по таймауту, потому что упираются в сырую производительность дисков, либо по OOM.

🤔 My opinion
Сложности на уровне взаимодействия DB, mmap, PageCache и дисковой активности постоянные.
Если базе данных дать больше управления над системой и использовать внутренюю статистику, то она всегда может быть круче generic решения.
У автора из статьи был тезис что задача у них есть задача "duckdb это OLAP база данных, которая может запускаться на чем угодно".
С учетом таких ограничений всегда может быть memory pressure и то что они борятся с этим performance cliff это круто.

На сколько успешно? Надо пробовать.
Они про это заявляли в 2022, но тогда было много segfaults от прошлой реализации и люди не поверили в рабочее решение.
Сейчас его упростили и сделали лучше:)
  • 👍 2
  • 🫡 1
Post #29 113
Это фраза тоже не совсем корректная, из (pic 3) видно что не все время проводится в B-tree и есть возможности для векторизации и для B-Tree деревьев.
Скорее всего проблема в том что сложно писать и поддерживать такой код, когда очень большое разнообразие платформ.

SQLite includes over 600 lines of test code for every one line of library code, and its tests cover 100% of machine code branches in the library [25]. Although SQLite cannot claim to be bug-free, its aggressive testing drastically reduces the chance of a bug appearing, which generally enables the developers to rapidly implement new features with high confidence.

Это впечатляет, но есть нюансы:)
Post #28 109
🗃️ SQLite: Past, Present, and Future
#sqlite #duckdb #bloomfilter #btree
🥼 Article https://dl.acm.org/doi/10.14778/3554821.3554842

На одном из проектов использую sqlite и решил почитать про нее.
Статья от 2022 года, поэтому надо это учитывать.

🪨 Context
SQLite это embedded база данных, которая может работать прямо из процесса приложения без client/server взаимодействия.
Она с одной стороны сильно ограничена по функциональности, но имеет все необходимое для минимальной базы данных.
В данной статье люди University of Wisconsin-Madison решили сравнить duckdb и sqlite, потому что duckdb набирает популярность и отбирает лавры embedded db для аналитических сценариев.

🧂The idea
Авторы взяли несколько бенчмарков:
* TATP для OLTP нагрузки, где sqlite чаще используется и больше предназначен. Тут конечно интересного мало, sqlite на 1-2 порядка быстрее, см. pic 1.
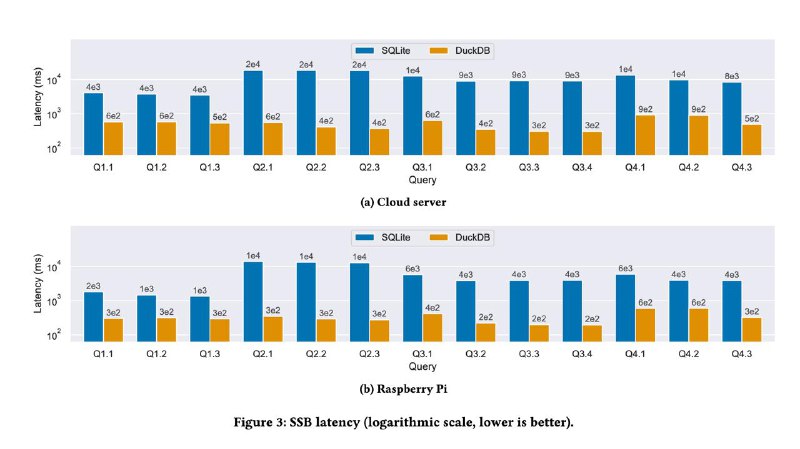
* SSB для OLAP нагрузки, где duckdb быстрее, но это как раз поле чтобы поискать точки роста для sqlite.

! sqlite не поддерживает in-query parallelisation, поэтому для "справедливого" сравнения, сравнивалась single-threaded версия duckdb.

В OLAP случае все наоборот, duckdb на 1-2 порядка быстрее (см. pic 2)
В sqlite все запросы компилируются в byte-code, который исполняется в реализованной VM -- VDBE (Virtual Database Engine).
Дальше по инструкциям byte-code можно понять где больше всего тратится времени и у VDBE есть возможность записывать количество CPU Cycles per instruction type.

В join-запросав большинство времени уходило на seek в B-tree, при этом на запросах было много промахов, т.е. много поисков в дереве в бенчмарке делалось впустую.
Авторы решили реализовать дополнительный BloomFilter, который динамически строят перед таким join.
Это конечно ускорило join в benchmark, но требует дополнительного full scan прохода по всей таблице. Нельзя прочесть лишь 1 столбец, это же row-oriented, прочитана будет вся таблица.

Такая оптимизация ускорила часть запросов в 4 раза (см pic 3), и это здорово, но это очень далеко от оптимизаций которые в duckdb.

Да вот и все работа и оптимизации, добавили BloomFilter перед B-tree.

🤔 My opinion
Кажется проект sqlite стал заложником своей популярности и консурциума, который хочет сохранить технологию, а не развивать.
Надо смотреть на форки вроде turso.

In the two decades following its initial release, SQLite has become the most widely deployed database engine in existence. Today, SQLite is found in nearly every smartphone, computer, web browser, television, and automobile. Several factors are likely responsible for its ubiquity, including its in-process design, standalone codebase, extensive test suite, and cross-platform file format.

However, we quickly encountered limitations surrounding changes to SQLite’s database file format. The database file format is extremely stable, cross-platform, and backwards compatible. As noted earlier, the database file format is a US Library of Congress recommended format for the preservation of digital content [1], largely due to its stability, portability, and thorough documentation. It is straightforward to imagine new data formats, such as columnoriented, that would streamline value extraction. However, we were unwilling to sacrifice the stability and portability of the database file format for the added performance.


Когда ты такой популярный, то нельзя просто так взять и поменять формат данных, слишком много всего нужно мигрировать или поломается.
Т.е. единственное что можно менять, так это процессинг уже текущего формата. Но и тут есть ограничения, реализация sqlite старается быть минимальной, без внешних зависимостей и уметь работать на разнообразных платформах. Они json/jsonb даже сами реализовали внутри.

For example, one might reasonably predict that SQLite would benefit from vectorized execution, which DuckDB uses to reduce the overhead of runtime query interpretation. However, our profiling analysis revealed that SQLite spends little time in query interpretation relative to B-tree probes and value extraction, and thus vectorization is unlikely to have an appreciable impact.
Post #26 143
#tum #uzh #job #sqlstorm #cardinality

Вчера ходил на лекцию где автор LpBound из поста выше Haozhe Zhang из UZH рассказывал про работу.

Несколько интересных дополнений:

* LpBound Cardinality Estimation обгоняет ML-модельки по качеству для общего случая. Т.е. когда знаний про данные мало, то LpBound всегда на порядки лучше.
Estimator на ML моделях всегда требуют дообученния и это может быть очень ресурсоемким.

* Microsoft уже использует эту LpBound в одной из БД (вероятно SQLServer ?)

* Текущая версия LpBound несмотря на лучшую оценку, все равно оценивает пессимистично верхнюю границу cardinality.
В реальности она ниже, и если использовать дополнительные знания про корреляцию данных в таблицах, то upper-bound cardinality можно еще опустить, увеличив точность.

* В конце 2026 они планируют выпустить статью CorrBound, где используя дополнительную статистику про таблицу и корреляции можно улучшить качество оценки еще на порядок (см. картинку).

* Для оценки качества LpBound они использовали Join Order Benchmark, но теперь хотят использовать SQLStorm, т.к. он имеет намного больше планов и краевых случаев где оценку можно протестировать.
Интересно наблюдать как чистая математика обогнала решение с ML, но при этом используется LLM для верификации множества случаев.

* Cardinality в Optimizer используется как один из факторов для построения Execution Plan, но он всегда скорее был второстепенным фактором из-за сложности корректной оценки. Возможно теперь из-за более точной оценки оптимизатор сможет выбирать планы намного лучше, интересно понаблюдать за изменениями после внедрения новой оценки.
  • 🔥 2
Post #25 146
∑ LpBound: Pessimistic Cardinality Estimation using lp-Norms of Degree Sequences
#CBE #cardinality #linear #algebra

🥼 Article https://arxiv.org/abs/2502.05912
📹 20 min video https://www.youtube.com/watch?v=ys-iQeERav8

Снова оказался в ситации, когда мне не хватает фундаментальных знаний, не хватает глубокого понимания линейной алгебры чтобы хорошо понять работу.
Приложение математики понимаю, а ее саму нет.

🪨 Context
В базах данных перед выполнением запроса всегда есть Query Optimizer, который знает что-то про данные и придумывает правильный путь обхода, как правильно обрабоать их.
Optimizer опирается на несколько вариантов выполнения и ищет самый дешевый Cost-Based Optimizer и Cardinality Estimator, который в свою очередь старается определить количество возвращаемых строк на каждом из этапов. В зависимости от cardinality можно выбрать разные алгоритмы.

🧂The idea
В статье используются L^p space для оценки верхней границы cardinality.
Если оценивать среднюю cardinality, то можно в среднем хорошо попадать, но могут быть ситации промахов, когда из-за неправильного алгоритма выполнение запроса не влезло в память и упало с OutOfMemory. И нужно писать логику с перезапуском запроса, что сложно.

В работе авторы как раз стараются более точно оценивать верхнюю границу и у них это получается, причем используя меньший memory footprint.

🤔 My opinion
Для меня это выглядит как черная магия, перестановкой операторов в Execution Plan можно добиться значительного ускорения запроса.
Эти алгебраические трюки намного важнее всех Memory Management, io_uring и форматов хранения, и других оптимизаций.
Чистая математика и красота.

Линал не понял, но очень интересно. (с)

Углублюсь в него и вернусь в такие работы чуть позже.
  • ❤ 2
Post #23 158
📦 AnyBlox: A Framework for Self-Decoding Datasets
#tum #arrow #parquet #wasm #avx

🥼 Article https://www.vldb.org/pvldb/vol18/p4017-gienieczko.pdf
Статья получила премию VlDB'25 Best Paper Award, но я не согласен 😧

В статье описан формат хранения для аналитических задач, который должен решить часть проблем совместимости между разными системами.

🪨 Context
Сейчас стандартом для аналитических задач стали несколько комбинаций форматов:
1. Iceberg (+Parquet) для долговременного хранения и использования в разных системах
2. Apache Arrow для быстрой аналитической обрабтки в памяти или передачи между разными системами
3. Свои бинарные форматы: clickhouse, duckdb, bigquery, и т.п.

Apache Iceberg начал становиться стандартом, но с ним есть проблема.
Для каждого ЯП -- своя реализация, поддерживающая разный набор фичей и разную производительность.

Parquet, страдает тем же самым, каждая система пишет его по-своему.
Каждая БД рано или поздно хочет написать свой Reader / Writer, потому что можно более тесно встроить и значительно ускорить работу.

Из-за этого возникает проблема MxN (где у нас M-систем/БД и N-форматов), количество реализаций и форматов растет, а поддерживать их сложнее.

Свои бинарные форматы всегда работают и поддерживаются лучше, но они всегда vendor-lock на конкретной системе.

🧂The Idea
В статье автор предлагает следующее решение проблемы:
* Рядом с самими данными можно подкладывать программу, которая знает как распаковать эти данные в память.
* В качестве такой механизма для исполнения -- WebAssembly (WASM), ограниченная VM, которая может исполнить произвольный код без системных вызовов.
* База данных должна поддержать WASM Engine, который скомпилирует это программу под свой архитектуру и исполнит ее
* Это программа читает данные и маппит их на Apache Arrow формат, который уже поддерживается многими БД
* PROFIT!

🈲 My opinion
WASM предоставляет песочницу, но она нужна если исполнять там произвольный код.
Если формат стандартизирован, то эта песочница не нужна, нужно тестировать input/output формата, гонять fuzzing testing и схема будет проще и надежней.

Основная проблема с реализациями в том, что некоторые ЯП вроде Java (Scala, Kotlin, ...) и Go, не любят использовать внешние C-libs, потому что взаимодействие своего runtime с любой внешней сишной либой вызывает много проблем.
НО WASM никак не решает эти проблемы, все остается на том же месте.
Здорово иметь возможность запустить произвольный код, но скорее всего разработчики продолжат писать свои parquet reader/writer во всех ЯП (C, C++, Rust, Go, Java).

WASM накладывает ограничения на прямую работу с памятью и автор предлагает использовать mmap, и транслировать их в WASM для zero-copy работы.
Это решает проблему с копированием данных между runtime, но полностью будет игнорировать механизм работы BufferManager в самой БД.
БД сама должна иметь свой буффер и mmap это плохая идея https://db.cs.cmu.edu/mmap-cidr2022/

Apache Arrow как в общий формат это лучший из текущих вариантов для этой задачи, но и у него есть ограничения по типам данных и методам обработки.
Нужно ли дальше БД конвертировать в свой формат? Появится ли там data copy? Если все БД будут использовать Arrow, то их производительность будет ограничена этим форматом.
⚡Это просто не выгодно бизнесу, как формат для импортирования данных -- да, для полноценной работы -- нет

WASM поддерживает векторные инструкции, но до 128 bits (bye-bye AVX256/AVX512), а писать код с ними сложнее чем на C/C++.
Из-за этого вариант с WASM всегда будет хуже C-library или своим парсером.

ИМХО, это проблему лучше решить через Change-Data-Capture.
Например как Data Transfer / Airbyte компонента, которая умеет подписываться на Iceberg и конвертировать его сразу в Arrow или свой бинарный формат.
Думаю это более надежный и быстрый вариант.

Автор в статье показывает, что WASM работает медленее нативных форматов с векторизацией, но быстрее parquet. Ну доля правды в этом и есть, именно поэтому и лучше и переписать parquet lib, потому что там еще есть места для ускорений.
  • 🔥 3
Post #19 124
В результате получилась очень быстрая оценка, которая и по скорости и Q-Error превосходит другие имплементации.
Круто это тем, что теперь в момент построения из Logical Plan -> Execution Plans, можно построить несколько и оценить их все, и выбирать нужный уже по оценке времени исполнения, а не только по фичам как раньше.

Результаты оценок pipelines можно кешировать и так делает AWS Redshift в его реализации Stage. Благодаря этому время оценки удается снизить до ~2us для похожих запросов.

🚫 Limitations
Не смотря на всю крутость, у подхода все равно есть ограничения:
1️⃣ Обучать нужно каждый hardware profile, т.е. для каждого instance-type нужно гонять тесты, которые будут строить нужное Decision Tree.
У автора оно гонялось около 10 часов, но зато его можно использовать для любых запросов/данных в БД.
Так же можно переиспользовать между разными версиями БД / инастансами, просто отдельный динамический ресурс.
2️⃣ В модели никак не учитывались в обучении запросы, которые делают Spill на диск. Это скорее дополнительный набор свойств для feature vector, который нужно тренировать. В целом подход наверняка можно переиспользовать, просто надо добавлять это в feature-vector.
3️⃣ Не учитывалась конкуренция за ресурсы. Во время обучения запрос исполнялся один за одним и все ресурсы были отданы ему одному, в реальной ситуации нужно как-то дополнительно учитывать это.
  • 🤓 1
Post #18 124
⏱️ T3: Accurate and Fast Performance Prediction for Relational Database Systems With Compiled Decision Trees
#tum #redshift #execution #pipeline #decisiontree #lleaves

🥼 Article

В статье описан механизм оценки времени выполнения запроса, еще до его непосредственного выполнения.

Мне статья понравилась, потому что показывает как задачу оценки можно переложить на что угодно, и как с помощью DecisionTree и данных построить хорошую оценку.

🪨 Intro

Сама по себе задача интересная, сложная и полезная в части шедуллера.
Когда у тебя есть база данных и тебе надо примерно оценить сколько времени это займет, на какой иp инстансов отправить, пора ли создавать мастштабировать новый инстанс или нет.

Если неправильно оценивать и рассылать их в round-robin порядке, то они могут конфликтовать между собой и замедлять друг друга.

В этой работе исследователи решили реализовать новый алгоритм, который позволяет оценивать их сложность быстрее и точнее.

Когда запрос прилетает в БД, он проходит через несколько важных фаз:
* Parsing, запрос разбивается на AST дерево
* Построение и оптимизация Logic Plan, где используется информация о таблицах и линейная алгебра чтобы определить в каком порядке узлы графа стоит исполнять и какие можно оптимизировать.
* Execution Plan можно сказать что это непосредственный план выполнения запросов. Даже 1 логический план можно сконвертировать в несколько разных вариантов исполнения, например используя разные алгоритмы для Join (HashJoin vs SortJoin / Memory Join vs Disk Join)
* Execution или непосредственное исполнение.

Execution Plan выглядит как дерево с Pipelines, это участки исполнения запроса на критическом пути между Pipeline Breakers (когда нельзя начать следующий pipeline, не завершив предыдущий). (pic 1)


💡Idea №1: Давайте оценивать каждый отдельный Pipeline, а суммарно запрос как сумму этих Predicted Times.

Прямое и корректное решение, следующий вопрос -- как быстро и корректно оценивать эти отдельные pipelines?
Для каждого запроса они могут сильно отличаться, они отличаются как по набору данных (на вход, на join, на выход, так и по применяемым преобразованиям).


💡 Idea №2: Давайте для каждого pipeline создадим Feature Vector, который будет хранить в себе описание и научим ML оценивать время этой части.

Выглядит это примерно как на (pic 2), вектор довольно большой, под сотню параметров для описания.
Если так получается что конкретный Pipeline мы плохо оцениваем, то можно всегда углубляться и добавлять новых feature для описания и дообучать систему.
Благодрая этому получается оценивать pipelines как генерализированную сущность, которая не зависит от самих таблиц / данных.
Т.е. не надо дообучаться на данных, чтобы корректно оценивать время.


💡 Idea №3: Теперь для каждого из feature-vector нужно оценить примерное время, для этого попробуем натренировать Decision Tree на feature-vector's от синтетических запросов.

Decision Tree это клевый способ, потому что для некоторых задач позволяет написать очень эффективный и быстрый inference на cpu.
Он отлично подходит для задач категоризации/оценки когда есть подготовленный feature-vector.
Автор гонял обучение на ноуте ночью, и на утро у него было много деревьев которые хорошо могли оценивать время исполнения запросов.


💡 Idea №4: Q-Error as Error Function: Q-Error(predicted, observed) = max( predicted / observed, observed / predicted)

В качестве оценки качества предсказания он раз использовал Q-Error, что выглядит как простая формула, но она очень хорошо сработала на данных.
Физически она означает разницу в порядках между предсказанным и реальным временем выполнения запроса.

💡 Idea №5: Компиляция DecisionTree с помощью lleaves

Используемый LightGBM позволил построить несколько DT, и пробегаться по ним чтобы оценивать время и в среднем это занимало ~22us.
Но есть замечательный https://github.com/siboehm/lleaves, который позволяет скомпилировать дерево в код, который будет исполняться заметно шустрее.
⚡ Читать его конечно станет невозможно, но это и ненужно, а время работы 4us. (pic 3)


📝 Conclusions
Post #17 206
Все эти ваши GPU карты это дорогое и ненадежное оборудование, весь мир сошел с ума.
  • 😁 3
  • 💯 2
Post #14 193
🥶 Take 5: GSP errors
GPU System Processor, это отдельный чип отвечающий за инициализацию и управление заданиями.
У него есть отдельная прошивка, и эта штука может отдельно ломаться.

❗Как правило, пробелемы с GSP приводят карту в inoperable state или hung / freeze state

GSP errors can be caused by either GSP firmware bugs [32] or
demanding workload. For example, Delta SREs observed that these
errors were highly correlated with heavy ML benchmarks, and
they suggested that GSP errors are high-impact errors whose recov-
ery requires manual node draining and reboots. Our propagation
analysis confirm that the GSP is a single point of failure on both
A100 GPUs in part because of their spontaneous nature and high
downstream impact (e.g., GPU hangs) on the GPU.


In fact, AWS recom-
mends disabling GSP for stability over performance benefits [4].

🚌 Take 6: GPU fallen Off the Bus
Это скорее типичный износ и перегрев.

GPU Fallen Off the Bus errors were
logged when the GPU driver could not reach the GPU over the
system bus. This error is an integration error often caused by a
loose GPU-motherboard connection or contact failure because of
thermal cycles [49]. Over 99% of the errors of this type lead to
similar errors in close successions and eventually put the GPU into
an error state.
Post #13 196
🧑‍🚒 Characterizing GPU Resilience and Impact on AI/HPC Systems

#gpu #failure #nvidia #slurm

🥼 Article

Похоже я в ближайшее время попишу про GPU.

Еще одно исследование на тему стабильности использования GPU в кластере.
Анализ кластера ~1K GPU с использованием A100 и H100 на протяжении 2.5 лет из UIUC вместе со Slurm.

В отличии от прошлой статьи они разбирали software related issues и механизмамы починки.

📚Take 1: Memory Issues
Одна H100 владеет 96GB HMB3 памятью, A100 40GB HBM2e.
Ошибки на H100 возникают в 3 раза чаше и они в целом коррелируют с объемом памяти.

❗Чем больше память на карте, тем больше вероятность Memory Issues.

В основном большая часть проблем с картами это ошибки памяти.
В GPU используется ECC память, но она не всегда помогает.
Есть класс ошибок, при которых драйвер помечает блок как Uncorrectable и требует GPU reset, чтобы карта запомнила что этот блок использовать нельзя.
Для пользователя это выглядит как упавший процесс, при простом перезапуске возможен повтор и помогает только GPU Reset и drain всей ноды.
В качестве примера см pic 1.

🚧 Take 2: Средний uptime карты всего 99.3%
Для A100 -- 99.4%, H100 -- 99.3%.
В H100 есть дополнительные механизмы, которые позволяют часть Memory Issues починить без GPU Reset, но процессы все равно продолжат падать.

❗99.3% это очень мало, это 9-10 минут downtime на каждой карточке.

❗4 gpu -- uptime 97.2%, downtime 40 min / day
❗8 gpu -- uptime 94.5%, downtime 79 min / day

Здесь вопрос к скорости починки, от момента обнаружения (Mean-Time-To-Detect) до самого GPU Reset с освобождением от нагрузки (Mean-Time-To-Recover).
Это напрямую влияет на downtime, и GPU reset на картах не объединенных в кластер делать намного быстрее.

💊 Take 3: Устройство автопочинки

На рисунке 2 изображен путь того как обрабатывают ошибки памяти где есть поддержка online recovery mechanisms в виде error containment и dynamic page offloading.

GPU Memory. Figure 3 shows the uncorrectable ECC memory
error-recovery process [35] for A100 and H100 in more detail. The
primary mechanism for mitigating uncorrectable ECC memory er-
rors for A100 and H100 GPUs is row-remapping, wherein the faulty
memory row is replaced with a spare row, and a row-remapping
event (RRE) is logged. The actual row remapping happens at the
next GPU reset (e.g., during node reboot or maintenance). If there
are no spare memory rows, a row remapping failure (RRF) is indi-
cated [33, 35].
A100 and H100 GPUs support online recovery mechanisms such
as error containment and dynamic page offlining [33, 35] for miti-
gating uncorrectable ECC memory errors with minimal node in-
terruption. The dynamic page offlining marks the faulty memory
page as unusable without requiring a GPU reset to maintain avail-
ability. The error containment procedure terminates user processes
using the faulty memory address to prevent error propagation
to other applications. Successful error containment is logged as
a Contained Memory Error, whereas an unsuccessful error con-
tainment is logged as an Uncontained Memory Error. Failure in
a row-remapping or error containment can cause a GPU failure
that requires a GPU reset or node reboot. Delta SREs monitor row-
remapping failures and replace GPUs that repeatedly emit such
errors.


Т.е. надо внимательно следить за износом и заменять GPU, когда он перестает срабатывать.

🪵 Take 4: System logging

Все события по работе этих меназимов можно взять из системных логов.
Nvidia пишет их в dmesg и исследовали их отбирали прямо по regexp, группируя близкие события.

🔗 Take 5: Nvlink errors has a 54% chance of leading to a job failure
Nvlink нужен для быстрого и прямого обмена данными между GPU.
Nvlink поддерживает CRC и он умеет делать retransmit в случае если CRC не сходится.
Кроме того, у исследователей были случаи ошибок NVlink, когда он не использовался для расчета задачи и это никак не влияло на пользователя.
Older posts →

About this channel

How can I read @dive_memo without a Telegram account?
TGViewer shows the public web preview Telegram publishes for struct dive_memo: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does struct dive_memo have?
struct dive_memo (@dive_memo) has 57 subscribers on Telegram, refreshed roughly every 30 minutes.
Does struct dive_memo know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →