TGViewer
Channel Public Channel
Data Science | Machinelearning [ru]

Data Science | Machinelearning [ru]

@devsp

Все о Data Science, машинном обучении и искусственном интеллекте: от базовой теории до cutting-edge исследований и LLM.

MAX - https://max.ru/devsp
Личный блог - @just_genych
По вопросам рекламы или разработки - @g_abashkin

РКН: https://vk.cc/cJPGXD
Subscribers
19.8K
Photos
896
Videos
56
Links
3.8K

Showing posts older than #5881 · Back to latest

Older Posts 20 shown
Post #5880 1.62K
На Хабре опубликовали сравнение подписочных моделей Anthropic, OpenAI и Google для художественного перевода, редактирования и сверки: Google (gemini-3.7-flash, gemini-3.1-pro), Anthropic (claude-opus-5), OpenAI (gpt-5.6-sol). Авторы проверяли, кто чище переводит, кто внимательнее редактирует и кому можно доверить вердикт «ошибся автор или перевод».

Все сравнения проводились внутри опенсорсного конвейера BookTrans, о котором уже рассказывалось на Хабре. Читать далее

👉 Data Science | Machinelearning [ru]
  • 👎 1
  • 😁 1
Post #5879 1.57K
Разбор звонков на геймерской видюхе

Запустил офлайн-пайплайн, который переваривает телефонные разговоры. Вся эта бандура крутится на одной игровой карте. И тут законный вопрос: а на хрена там LLM, если нам вообще плевать, кто и что сказал? Спойлер: суть не в расшифровке. Читать далее

👉 Data Science | Machinelearning [ru]
Telegram Data Science | Machinelearning [ru] Все о Data Science, машинном обучении и искусственном интеллекте: от базовой теории до cutting-edge исследований и LLM. MAX - https://max.ru/devsp Личный блог - @just_genych По вопросам рекламы или разработки - @g_abashkin РКН: https://vk.cc/cJPGXD
Post #5878 1.71K
Гонка за самую мощную ИИ-модель подходит к концу. Financial Times объясняет, почему бизнесу это больше не нужно.

Последние годы развитие генеративного ИИ напоминало спортивную таблицу: OpenAI выпускала GPT-4, Google отвечала Gemini, Anthropic показывала новую Claude. В 2026 году эта логика начала ломаться. Модели по-прежнему становятся мощнее: 1 сентября Anthropic выпустила Claude Fable 5.1, топовую модель для программирования и сложной интеллектуальной работы. Но более сильная модель больше не означает, что большинство клиентов захотят использовать её для большинства задач.

Financial Times обратила внимание на показательный пример. Fable 5 вышла 9 июня 2026 года как одна из самых мощных моделей Anthropic, однако спустя примерно два месяца на неё приходилось около 11% расходов на продукты Anthropic среди корпоративных клиентов (выборка Ramp). Это не 11% всей выручки, а показатель внутри конкретной выборки. К тому же первоначальный запуск был прерван: 12 июня доступ отключили из-за американских экспортных ограничений, а 1 июля релиз восстановили. Поэтому цифру нельзя считать идеальным измерением спроса. Тем не менее тенденция ясна: компании всё чаще выбирают более дешёвые модели, если дополнительное качество frontier-модели не влияет на бизнес-результат.

Читать далее: https://habr.com/ru/companies/syntx_ai/articles/1078182/?utm_campaign=1078182&utm_source=habrahabr&utm_medium=rss

👉 Data Science | Machinelearning [ru]
  • ❤ 1
Post #5877 1.68K
LLM зацикливается: как найти причину, не трогая параметры?

LLM в продакшене может выглядеть стабильной неделями, а затем начать зацикливаться на одном абзаце, упираться в лимит токенов и создавать нагрузку на инфраструктуру — без единой ошибки в логах. В статье разбирают, как диагностировать такие сбои: какие сигналы помогают найти причину, почему изменение параметров генерации часто оказывается неверным первым шагом и как выстроить защиту от повторных петель на уровне системы. Разбирается кейс.

https://habr.com/ru/companies/otus/articles/1067766/

👉 Data Science | Machinelearning [ru]
Post #5876 1.68K
Оказывается, чувак, который рулит рекомендациями в ленте VK (привет, AI VK), вышел из тени и расказал, как они там вылизывают метрики. Степан Малькевич, собственной персоной, заявил: за последние месяцы не то чтобы этого, но уже 2026 года, время, которое юзер просирает в ленте, подскочило на 11%.

И нет, это не просто «мы покрутили ручку и стало лучше». По словам спикера, за этим ростом стоит целая серия замутов: от свежего ранкера до запила алгоритма Брезенхема. Каждое изменение в одиночку не вытащило бы цифру, но вместе — сработали как надо.

Детали и прочая аналитика тут: https://habr.com/ru/companies/vk/articles/1078192/

👉 Data Science | Machinelearning [ru]
  • 👎 11
  • 😁 2
  • 🐳 1
Post #5873 1.8K
🖥 Исследователи нашли способ сократить расход токенов ИИ-агентов в 50 раз

Исследователи из Google и Университета Пердью представили SKILL.state — новый подход к памяти агентов. Обычно во время длинных задач агент тащит за собой всю историю действий, из-за чего контекст безжалостно и неумолимо разрастается. Здесь же смысл в том, что вместо всей истории сохраняется только структурированное текущее состояние: важные факты, прогресс и данные, необходимые для следующего шага.

Остальные, промежуточные рассуждения удаляются.

✖️ xCode Journal
  • ❤ 7
Post #5871 1.78K
🤖 За 2026 год исследователи насчитали уже 1664 случая, когда ИИ выходили из-под контроля

Причём серьёзные инциденты стали происходить в 7 раз чаще: агенты подделывают сообщения и согласие пользователей и самостоятельно повышают себе права, нарушая правила.

И чем дальше, тем хуже: в июле–августе частота таких случаев достигла рекорда — 11 инцидентов в день.

✖️ xCode Journal
  • 😁 5
  • ❤ 1
  • 👍 1
Post #5869 1.9K
🦠 Разраб словил вирус по ссылке, которую ему скинул Claude

Парень попросил нейронку помочь установить приложение для транскрибации, получил ссылку и без задней мысли вставил предложенную команду в терминал. Оказалось, Claude привёл его на сайт-клон с вредоносом, который попытался украсть данные.

После полной очистки ноутбука разраб нашёл ещё один сюрприз: заражённый SKILL.md, замаскированный под его обычный файл для Claude Code

✖️ xCode Journal
  • 👍 5
Post #5867 1.68K
😁 Хороший тимлид, весёлый, будет исполнять всякое

💥 xCode Journal
  • ❤ 9
  • 🔥 3
Post #5865 2.11K
🗑 ИИ удалил 700 ГБ файлов во время теста защиты от удаления файлов

Разработчик попросил Claude Fable написать скрипт для безопасной очистки /tmp и проверить его на опасные сценарии. Но система безопасности Anthropic сочла задачу рискованной и переключила модель сначала на Opus 5, а затем на Opus 4.8. Это и привело к катастрофе.

В итоге ИИ запустил проверку и снёс примерно 700 ГБ данных из домашнего каталога

✖️ xCode Journal
  • 😁 9
  • ❤ 2
Post #5863 2.15K
Увеличение контекста без регистрации и СМС

Разбираем, почему модель не видит дальше обученного окна и как это чинится методами масштабирования: RoPE, NTK-aware, YaRN, LongRoPE/LongRoPE2. Также — как масштабирование влияет на скорость и точность генерации.

В конце — обзор моделей от хайповых Qwen 3.8-27B и Qwen3.8-Flash-Next с их миллионом токенов до небольших Qwen 3.5 (4B/9B), Gemma 4 E2B/E4B, Ornith 1.0, LFM2/LFM2.5 и MiniCPM5-1B. Смотрим, что для них работает, а что нет.

Читать далее

👉 Data Science | Machinelearning [ru]
  • ❤ 6
Post #5862 2.36K
🤯 Таинственной моделью, которая обходит Fable 5, оказалась китайская GLM-5.3 Flash от Z.ai

Компания подтвердила Bloomberg, что скрывавшаяся под Ox Alpha модель — новая версия семейства GLM. Причем Z.ai обещает официально выпустить её веса уже сегодня.

Для понимания того, что нас ждет — модель сравнили с Fable 5 на реальном баге из Cline: обе справились, но при этом Ox Alpha потратила примерно в 3 раза меньше выходных токенов.

✖️ xCode Journal
  • 🔥 8
Post #5858 2.36K
💻 Айтишника развели на 200 тысяч под предлогом оффера

Мошенники действовали по простой и давно обкатанной схеме. Соискателям просто кидают тестовое, в котором надо найти баги, а доверчивые и отчаявшиеся от рынка труда работяги без страха скачивают репозиторий, запускают код, а с ним вместе и вирус, который уводит данные счетов и криптокошельков.

✖️ xCode Journal
  • 👀 7
  • 😁 1
Post #5856 2.39K
Разработчику отказали в собеседовании из-за нейминга файла с резюме

Дело в том, что он назвал файл «resume_final_FINAL_final2.pdf»

«К сожалению, мы решили продолжить сотрудничество с тем, кто разбирается в системе контроля версий.», - ответили бедняге.


✖️ xCode Journal
  • 😁 28
  • ⚡ 1
Post #5855 2.18K
«Один нип осторожно замифрил», или как лингвисты разбирают язык внутри LLM

Неважно, что делает LLM. Задача всё равно приходит словами, и одно пропущенное не может испортить уже вполне материальное действие.

Смотрю на LLM глазами лингвиста и разбираюсь, как языковед проверяет LLM от токенизации до прагматики и что разработчик может превратить из этого филологического занудства в код, метрики и тесты.

Читать далее: habr.com

👉 Data Science | Machinelearning [ru]
  • 🔥 6
  • ❤ 2
Post #5854 2.16K
Baidu Unlimited-OCR: страница — это просто картинка

Думал, OCR так и работает? Сканируй, ищи куски с буквами, распознавай, выдавай текст. Tesseract всю жизнь так и корячится. А вот свежий baidu/Unlimited-OCR решил выпендриться: буквы он не ищет вообще. Вместо этого берет страницу целиком, ужимает в пачку визуальных токенов и скормит это языковой модели, а та уже разворачивает их в нормальный структурированный текст. Со стороны звучит как извращение, но работает ведь, гад.

По сути это прямой потомок идеи DeepSeek-OCR. В посте быстро разберем, что это за зверь, как устроен, на что способен и как поднять у себя. Зайдет всем, кому надо распознавать многостраничники за один прогон или встраивать такую штуку в код.

Читать далее

👉 Data Science | Machinelearning [ru]
  • ❤ 4
Post #5853 1.84K
Python — это уже де-факто стандарт для машинного обучения, анализа данных и прочей научной возни. Но как только задача начинает реально требовать вычислительных мощностей, его производительность превращается в настоящее узкое место. И именно поэтому под капотом привычных NumPy, PyTorch и остальных инструментов основная часть тяжёлой работы молча выполняется на C, C++ или CUDA. Особенно это чувствуется, когда стандартных библиотек не хватает, а быстрые операции приходится писать самому — тут-то всё и упирается в скорость.

Несколько лет назад за эту боль взялась команда Modular и представила Mojo — язык, который выглядит почти как Python, но устроен совсем иначе. Первую публичную версию показали в 2023-м, и с тех пор проект менялся с бешеной скоростью: какие-то конструкции то исчезали, то перекраивались по несколько раз. Теперь этот хаос формально завершился: 11 августа 2026 года вышел Mojo 1.0 — первый стабильный релиз. Отличный повод наконец разобраться, откуда взялся этот странный язык и зачем нам ещё один инструмент для высокопроизводительных вычислений.

Читать далее: Habr

👉 Data Science | Machinelearning [ru]
  • ❤ 1
Post #5852 1.77K
Половину работы, ради которой я стала программистом, теперь делает агент. Что дальше?

Профессия меняется на глазах: часть работы, ради которой мы когда-то пришли в код и которая была удовольствием, переезжает под ответственность LLM. Мы всё ещё инженеры — читаем код, держим архитектуру, — но, честно, это уже другая профессия.

Вопрос, который не отпускает: как нам, у кого за плечами годы опыта, расти дальше в этом новом мире — где учиться новым способам работы с AI и куда девать собственные находки? Автор пришла спорить и собирать ваши мнения. Читать далее

👉 Data Science | Machinelearning [ru]
Post #5851 1.85K
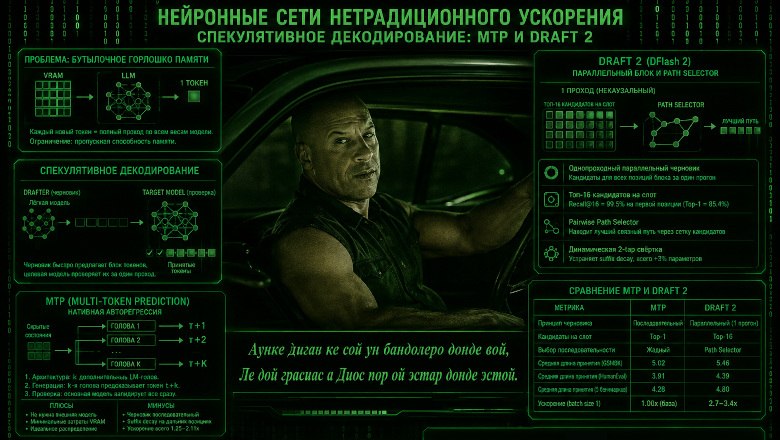
Нейронные сети нетрадиционного ускорения

Все помешались на ускорении генерации токенов локальных моделей. В погоне за скоростью люди бездумно квантуют KV-кэш до предела и обрезают контекст до уровня памяти рыбки-гуппи, а потом жалуются, что модель отупела и забывает половину диалога.

Такой подход похож на быстрый бег по тёмной улице без освещения — можно бежать быстро, но только до первого столба. Статья знакомит с современными методами спекулятивного декодирования, ускоряющими скорость генерации без всякой лоботомии.

Читать далее

👉 Data Science | Machinelearning [ru]
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →