TGViewer
Channel Public Channel
Data Science | Machinelearning [ru]

Data Science | Machinelearning [ru]

@devsp

Все о Data Science, машинном обучении и искусственном интеллекте: от базовой теории до cutting-edge исследований и LLM.

MAX - https://max.ru/devsp
Личный блог - @just_genych
По вопросам рекламы или разработки - @g_abashkin

РКН: https://vk.cc/cJPGXD
Subscribers
19.8K
Photos
931
Videos
56
Links
3.8K

Showing posts older than #4753 · Back to latest

Older Posts 20 shown
Post #4751 2.27K
➡️ Секреты Spark в Arenadata Hadoop: как мы ускорили построение витрин для задач ML

Покажем, как связали нашу платформу ИИ и Озеро данных, чтобы модели удобно работали с витринами через Spark. Немного архитектуры, немного боли, немного магии.

Читать...
  • ❤ 4
  • 🔥 1
Post #4744 2.3K
⚙️ Что такое data leakage в машинном обучении и почему это опасно?

Data leakage (утечка данных) — это ситуация, когда модель случайно получает информацию о будущем (о целевой переменной), которая недоступна на момент предсказания. Это приводит к переоценке качества модели во время обучения и к плохой работе на реальных данных.

➡️ Пример:

import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

# Пример: диагностические данные пациента
df = pd.DataFrame({
'age': [25, 40, 60, 35],
'blood_pressure': [120, 130, 150, 110],
'has_disease': [0, 1, 1, 0],
'diagnosis_code': [0, 1, 1, 0] # случайно совпадает с целевой переменной
})

X = df.drop('has_disease', axis=1)
y = df['has_disease']

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)

model = LogisticRegression()
model.fit(X_train, y_train)
print("Train accuracy:", model.score(X_train, y_train))


🗣️ В этом примере diagnosis_code напрямую связан с целевой переменной has_disease. Модель «угадывает» ответы на тренировке, но это не работает в реальности. Такое скрытое совпадение — типичный пример data leakage
  • ❤ 5
Post #4743 2.29K
👀 WorkTeam: новый мультиагентный фреймворк для автоматизации сложных бизнес-процессов

Показываю, как платформа WorkTeam превращает описания процессов на обычном языке в работающий бизнес-процесс — без кодеров, без боли и почти без магии.

Читать...
  • 👎 8
  • 😁 2
  • ❤ 1
  • 🔥 1
Post #4742 2.39K
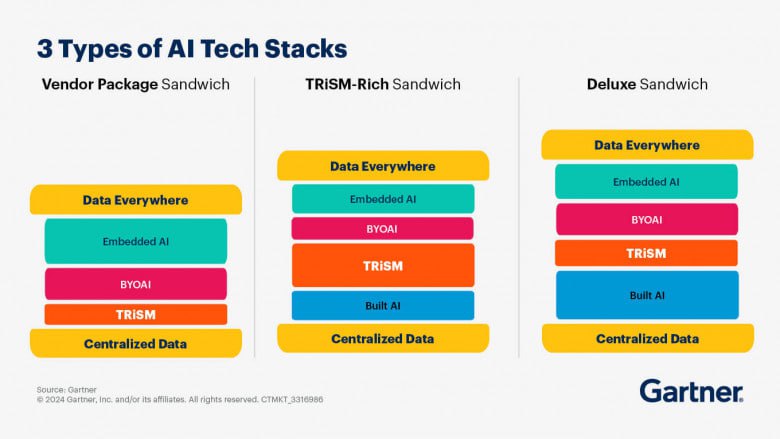
⚙️ Gartner's AI Tech Sandwich: Едим ИИ-бутерброд правильно

Рассказываю, как ИИ перестал быть модной фишкой и стал бизнес-необходимостью. Плюс — что за AI Technology Sandwich придумали в Gartner и зачем им слоёная метафора.

Читать...
  • ❤ 3
  • 🔥 1
Post #4741 2.51K
👩‍💻 Поиск коррелирующих признаков

Вам дана матрица признаков (таблица) в виде списка списков. Каждый вложенный список — это объект, каждый столбец — признак.

Нужно реализовать функцию highly_correlated_features(data, threshold), которая вернёт список пар индексов признаков, корреляция между которыми по модулю превышает указанный threshold (от 0 до 1, не включительно).

Использовать можно только корреляцию Пирсона. Повторы пар и зеркальные дубли учитывать не нужно ((1, 2) и (2, 1) — одно и то же).

Цель:

Выявить признаки, которые слишком сильно "повторяют" друг друга и могут вызвать мультиколлинеарность в моделях.


Решение задачи🔽

import numpy as np
from itertools import combinations

def pearson_corr(x, y):
x = np.array(x)
y = np.array(y)
return np.corrcoef(x, y)[0, 1]

def highly_correlated_features(data, threshold=0.9):
arr = np.array(data)
n_features = arr.shape[1]
result = []

for i, j in combinations(range(n_features), 2):
corr = pearson_corr(arr[:, i], arr[:, j])
if abs(corr) > threshold:
result.append((i, j))

return result

# Пример использования
X = [
[1, 2, 10],
[2, 4, 20],
[3, 6, 30],
[4, 8, 40],
[5, 10, 50]
]

print(highly_correlated_features(X, threshold=0.95))
# Ожидаемый результат: [(0, 1), (0, 2), (1, 2)]
  • ❤ 3
  • 🐳 1
Post #4740 2.52K
⚙️ Нейросети без градиентов: спектральное моделирование и построение решений

Пробую собрать нейросеть без backpropagation — только спектр, только хардкор. Показываю на XOR и друзьях, как активации влияют на частоты и как строить модели в лоб. Будет странно, но интересно.

Читать...
  • ❤ 2
Post #4739 2.63K
⚙️ Великая иллюзия Copilot

Рассказываю, как Copilot в парном программировании может быть опаснее любой нейросети — баги, хаос, StackOverflow-копипасты и моя потерянная вера в здравый смысл.

Читать...
  • ❤ 2
Post #4738 2.49K
👩‍💻 Вычисление “стабильных” признаков

Вам дана матрица признаков — список списков, где каждая строка представляет собой объект, а каждый столбец — отдельный числовой признак.
Ваша задача — определить, какие признаки можно считать стабильными.

Стабильный признак — это признак, у которого стандартное отклонение по всем объектам меньше заданного порога threshold.


Реализуйте функцию find_stable_features(matrix, threshold), которая возвращает список индексов признаков (столбцов), удовлетворяющих этому условию.

Решение задачи🔽

import numpy as np

def find_stable_features(matrix, threshold=0.1):
data = np.array(matrix)
stds = np.std(data, axis=0)
stable_indices = [i for i, std in enumerate(stds) if std < threshold]
return stable_indices

# Пример входных данных
X = [
[1.0, 0.5, 3.2],
[1.0, 0.49, 3.1],
[1.0, 0.52, 3.0],
[1.0, 0.5, 3.3],
]

print(find_stable_features(X, threshold=0.05))
# Ожидаемый результат: [0, 1]
  • ❤ 4
Post #4737 2.55K
⚙️ Тиндер для работодателей и соискателей: как мы разработали алгоритм мэтчинга на Авито

Я рассказываю, как мы запилили мэтчинг в «Авито Подработке»: без анкет, но с кучей данных, офлайн-тестами и ML. Делюсь опытом, как сделать выдачу умнее и продукт лучше.

Читать...
  • ❤ 4
  • 👍 2
Post #4736 2.48K
⚙️ RAG: борьба с низким качеством ответов в условия экономии памяти на GPU

В статье показали, как делали ИИ-помощника на RAG для юристов внутри компании: с какими проблемами столкнулись, как прокачивали точность ответов и экономили память на видеокартах.

Читать...
  • 👍 2
  • ❤ 1
Post #4735 2.28K
⚙️ Что такое StandardScaler в Data Science и зачем он используется?

StandardScaler из библиотеки scikit-learn — это инструмент для нормализации данных. Он приводит признаки (столбцы данных) к одному масштабу со средним значением 0 и стандартным отклонением 1.

Это важно для алгоритмов машинного обучения, чувствительных к масштабу данных — например, линейной регрессии, SVM или KMeans.

➡️ Пример:

from sklearn.preprocessing import StandardScaler
import numpy as np

X = np.array([[10, 200],
[20, 300],
[30, 400]])

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

print(X_scaled)


🗣️ В этом примере значения всех признаков преобразуются так, что каждый столбец имеет среднее значение 0 и одинаковый масштаб. Это ускоряет обучение и повышает качество модели.


🖥 Подробнее тут
  • ❤ 2
Post #4734 2.15K
➡️ Что забирает до 90% времени на созвонах и как перестать проводить их впустую

Когда митапов больше, чем решений, пора что-то менять. Мы выработали способ делать онлайн-созвоны короче, полезнее и без «а что мы вообще решили?». Делюсь, как именно.

Читать...
  • ❤ 1
Post #4733 2.37K
⚙️ Что такое StandardScaler из scikit-learn и зачем он нужен?

StandardScaler — это инструмент из библиотеки scikit-learn, который стандартизирует данные: приводит их к распределению со средним 0 и стандартным отклонением 1. Это важно перед обучением моделей, особенно для алгоритмов, чувствительных к масштабу (например, SVM, KNN, линейная регрессия).

➡️ Пример:

from sklearn.preprocessing import StandardScaler
import numpy as np

X = np.array([[10, 200], [15, 300], [14, 250]])

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

print(X_scaled)


➡️ После трансформации признаки будут нормализованы, что помогает улучшить сходимость и стабильность модели.

🗣️ StandardScaler — must-have шаг в пайплайне предварительной обработки данных для большинства классических ML-моделей


🖥 Подробнее тут
  • 👍 4
Post #4732 2.37K
⚙️ Yandex Cloud представила апдейты своей платформы AI Studio на конференции Data&ML2Business.

Упор — на кастомизацию RAG под конкретные базы знаний при работе с AI Assistant API: поддерживаются таблицы, pdf, метаданные для чанков, рефразер запросов и batch-инференс. У инструмента появился визуальный интерфейс, так что не обязательно городить пайплайны руками.

Совместимость с OpenAI API упрощает интеграцию — решения на базе AI Studio легко встраиваются в LangChain, AutoGPT и другие популярные ML-стэки. При этом платформу теперь можно развернуть on-premise на собственной инфраструктуре. Также рассказали про обновления в речевой аналитике – теперь нейросети сами подберут смысловые теги для поиска нужной информации в диалогах.

Также компания представила новые решения для работы с данными – представила управляемые сервисы Spark и Trino. В Datalens добавили кастомизация графиков на JS и публичную витрину дашбордов.

Читать…
  • ❤ 1
  • 🔥 1
Post #4731 2.31K
🧘 Перезагружайся осознанно, а не прокрастинацией

Переутомился — и вместо отдыха залипаешь в YouTube, соцсети, чат с мемами. Отдохнул? Нет.

👉 Совет: включай «активный отдых» — прогулку, растяжку, даже 5 минут с закрытыми глазами. Это реально перезагружает мозг. Прокрастинация даёт иллюзию паузы, но не даёт ресурса на следующий рывок.
  • ❤ 8
  • 👍 7
  • 👎 1
Post #4730 2.66K
➡️ Объяснимый ИИ в ML и DL

Разбираемся, зачем нужен объяснимый ИИ, как подступиться к интерпретации моделей и что с этим делать на практике — от EDA до XAI на примере. Всё на русском, без магии.

Читать...
  • ❤ 4
Post #4729 2.44K
Post #4728 2.48K
⚙️ Что такое Feature Scaling в ML и зачем он нужен?

Feature Scaling (масштабирование признаков) — это приведение всех признаков к одному масштабу, чтобы модель обучалась корректно.

Некоторые алгоритмы (например, k-NN, SVM, градиентный спуск) чувствительны к разнице в диапазонах данных

➡️ Пример:

from sklearn.preprocessing import StandardScaler
import numpy as np

X = np.array([[1, 100], [2, 300], [3, 500]])

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

print(X_scaled)


🗣️ В этом примере признаки приводятся к виду с нулевым средним и единичным стандартным отклонением.


Без масштабирования одна "большая" переменная может полностью доминировать над другими..

🖥 Подробнее тут
  • 🔥 3
  • ❤ 2
Post #4727 2.37K
🤔 На START, внимание, марш: как победить галлюцинации и научить LLM точным вычислениям

START — опенсорсная LLM для точных вычислений и проверки кода. В START решены две главные проблемы большинства обычных моделей: галлюцинации и ошибки в многоэтапных расчетах. В статье разберемся, зачем и как именно эти проблемы решены..

Читать...
  • ❤ 4
  • 🔥 1
Post #4725 2.49K
🖥 Играемся с RTX 5090 (GB202) для инференса

Автор тестирует RTX 5090 в хостинге, сравнивает с 3090 и A100, гоняет gpu-burn и инференс-сетку, проверяя, есть ли прирост для ML-задач. Без фанатизма, но с графиком.

Читать...
  • ❤ 2
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →