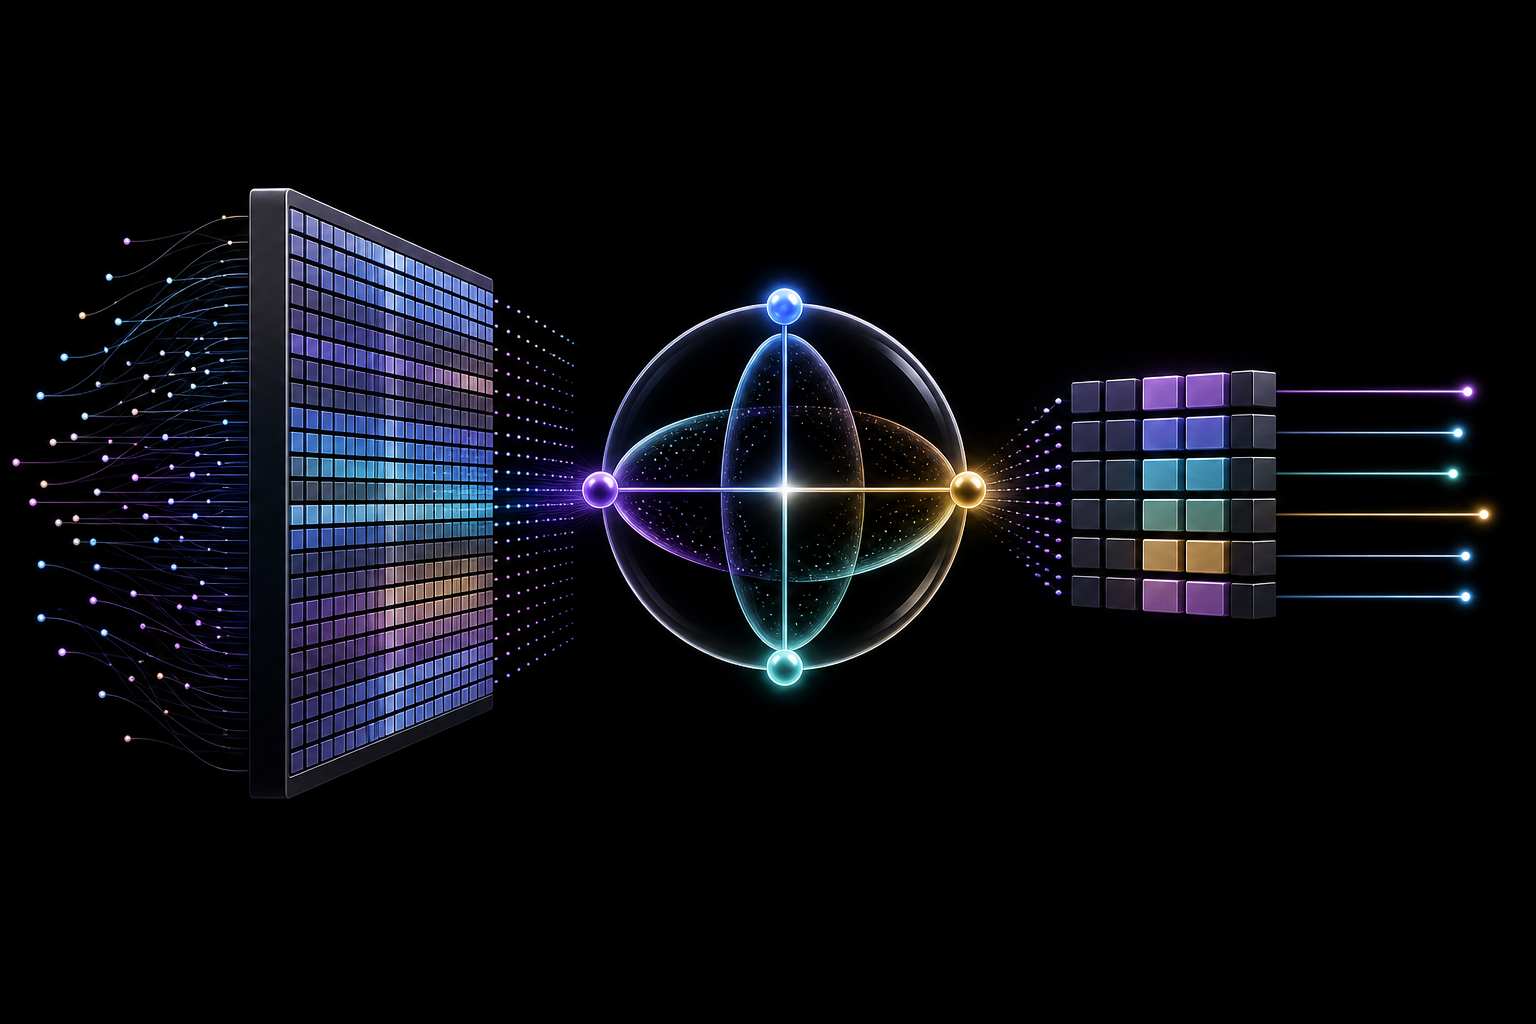
Работа с категориальными признаками, имеющими миллионы уникальных значений (user_id, video_id, search_query), создает классическую проблему: embedding-таблицы занимают больше памяти, чем сами веса модели. Стандартный подход — loss-aware pruning — часто приводит к необратимой потере информации для редких категорий. Элегантная альтернатива — кватернионные представления, которые снижают память в 4 раза без отбрасывания данных.
Базовая идея
Вместо full-rank вектора размерности d для каждой категории хранится всего 4 компоненты — кватернион (a, b, c, d). Выходной вектор восстанавливается через кватернионное умножение на learnable вес. Категория описывается вращением и гомотетией в 4D пространстве, что дает сильную геометрическую регуляризацию.
Реализация в production
Пример lookup для PyTorch-like inference:
class QuaternionEmbedding(nn.Module):
    def __init__(self, num_ids, dim=64):
        super().__init__()
        self.emb = nn.Embedding(num_ids, 4)
        self.w = nn.Parameter(torch.randn(4, dim // 4))

    def forward(self, ids):
        q = self.emb(ids)
        q = q / (q.norm(dim=-1, keepdim=True) + 1e-8)
        return torch.matmul(q, self.w)
Память падает с O(num_ids * d) до O(4 * num_ids + d). Lookup ускоряется за счет меньшего объема загружаемых параметров — до 40% снижения latency на high-cardinality фичах.
Скрытые trade-offs и когда это выгодно
Кватернионные embeddings работают при dim >= 8. Для меньших размерностей сжатие теряет expressiveness, и модель начинает проседать по метрикам (ROC-AUC падает на 2-5% на моих A/B-тестах с dim=4). Ключевое преимущество для rare categories: кватернионная нормализация предотвращает выучивание случайных шумовых векторов, стабилизируя градиенты. Но этого не происходит без явной norm-constraint — градиенты на низкочастотных ID взрываются, добавляя 10% outliers в распределении норм эмбеддингов.
Практический совет
Для production систем с ограничением GPU памяти (например, 200+ embedding-слоев в recommendation engine) используйте кватернионы как альтернативу hashing trick или adaptive embedding (e.g., Albert). Перед rollout обязателен offline тест: сравните distributional shift эмбеддингов на validation set и проверьте, что кватернионные представления не ухудшают recall@k для long-tail запросов более чем на 0.5%.
Вывод:
Кватернионные embedding-таблицы — инженерный прием, снижающий memory footprint в 4 раза без потери категорий, но требующий тщательной настройки нормализации и проверки минимальной размерности для сохранения качества.