В production рекомендательных системах и NLP-сервисах узкое место часто — генерация эмбеддингов. Когда на один user request нужно проинференсить десятки кандидатов, каждый запрос требует векторного представления каждого объекта. Латенси растет, и специалисты часто упускают простой оптимизационный трюк: кэширование в рамках батча, а не глобальное.
Почему batch-level caching?
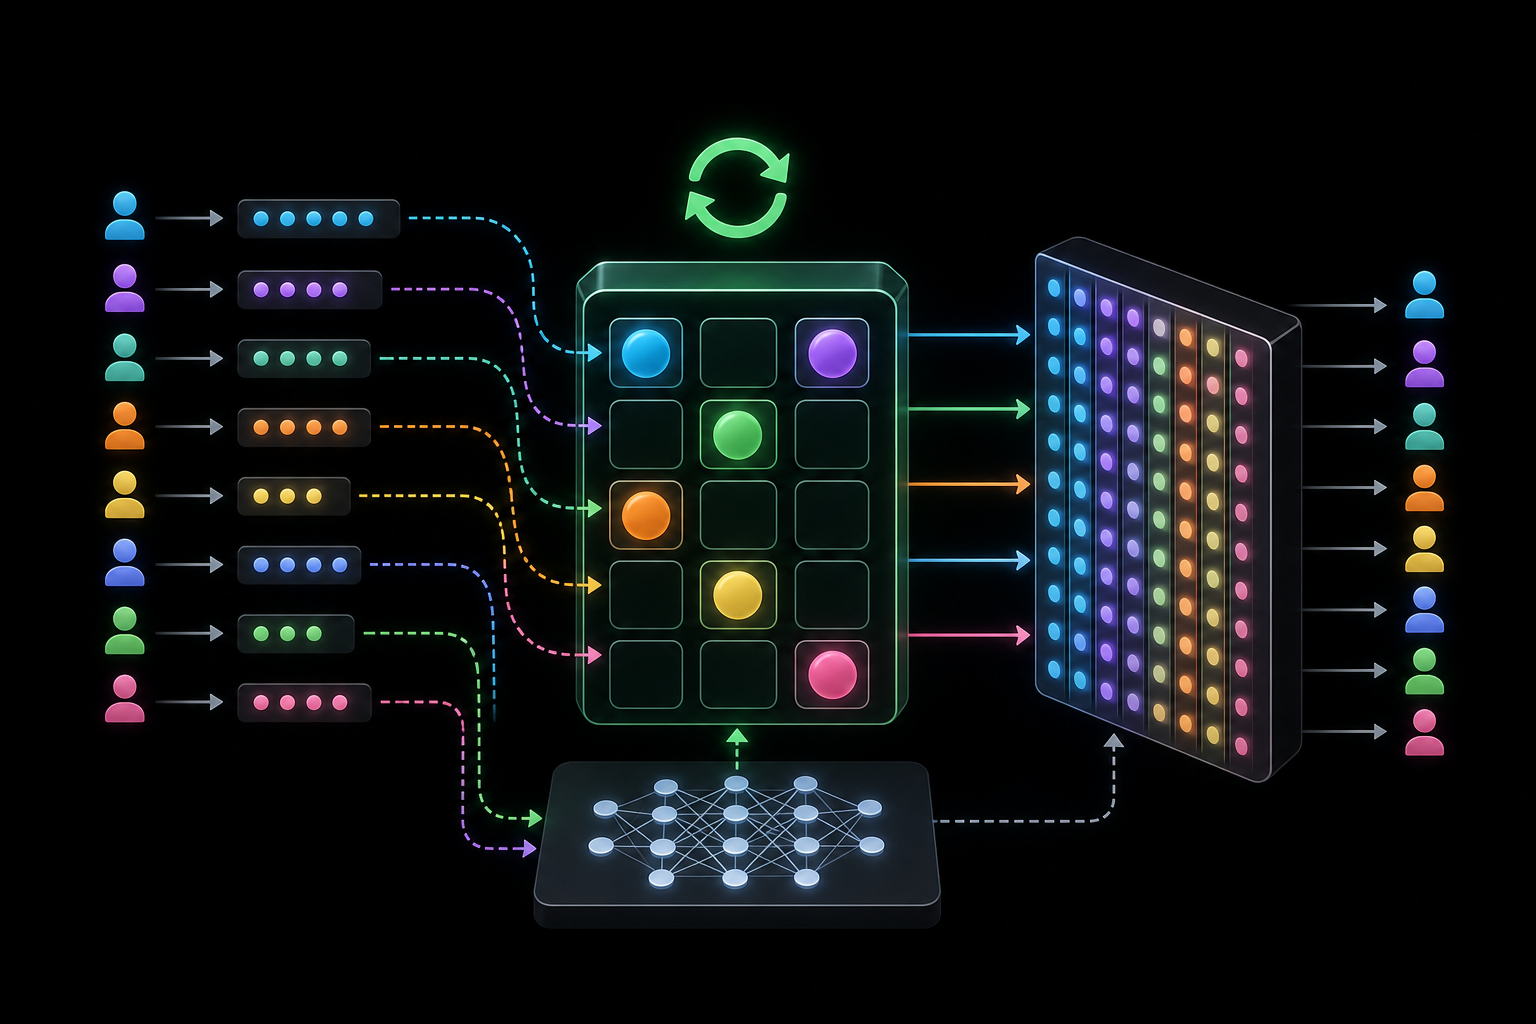
Запросы к инференс-сервису приходят батчами. Если вычислять эмбеддинги для каждого кандидата заново, число вызовов модели растет линейно с числом запросов и объектов в каждом. Однако многие объекты повторяются между запросами: топ-рекомендуемые товары, популярные тексты, частые сущности. Batch-level caching решает это дедупликацией ID внутри одного батча, минимизируя повторные вычисления.
Как это работает
Собираете все ID объектов из всех запросов батча, дедуплицируете их, вычисляете эмбеддинги только для уникальных ID, затем раздаете результаты через маппинг. Пример на Python:
def process_batch(batch_requests):
    all_unique_ids = {}
    for req in batch_requests:
        for item_id in req['item_ids']:
            all_unique_ids[item_id] = True
    unique_ids_list = list(all_unique_ids.keys())
    embeddings_map = compute_embeddings(unique_ids_list)
    results = []
    for req in batch_requests:
        req_embeddings = [embeddings_map[i] for i in req['item_ids']]
        results.append(compute_scores(req['user_vec'], req_embeddings))
    return results
Производственный пример
Допустим, у вас сервис для скоринга объявлений в real-time: 100 запросов в батче, каждый с 50 item'ами, но уникальных — всего 200. Без кэширования — 5000 вызовов модели эмбеддингов, с batch-level — 200. Сокращение в 25 раз. Для критичного по latency пайплайна это разница между SLA violation и стабильной работой.
Практический совет и trade-offs
Добавьте LRU-кэш второго уровня для hot items с TTL в 1 минуту. Batch-level — первый фильтр, отсекающий дубликаты внутри батча, глобальный кэш ловит переиспользование между батчами. Но не забывайте: требуется синхронизация внутри пайплайна — нужно собрать все ID до вычислений. Это может стать узким местом для batch size > 1000 или при асинхронной обработке. Типичная ошибка: путать batch-level с глобальным TTL-кэшем и терять дубликаты внутри одного батча.
Вывод:
Batch-level caching — самый простой способ снять duplicate-нагрузку на генерацию эмбеддингов в real-time, сокращая latency в разы без значительных overhead по памяти или инфраструктуре.