Новички в ML часто слышат:
«Всегда нормализуй данные».
И начинают масштабировать всё подряд.
А потом качество модели… падает.
Почему так происходит?
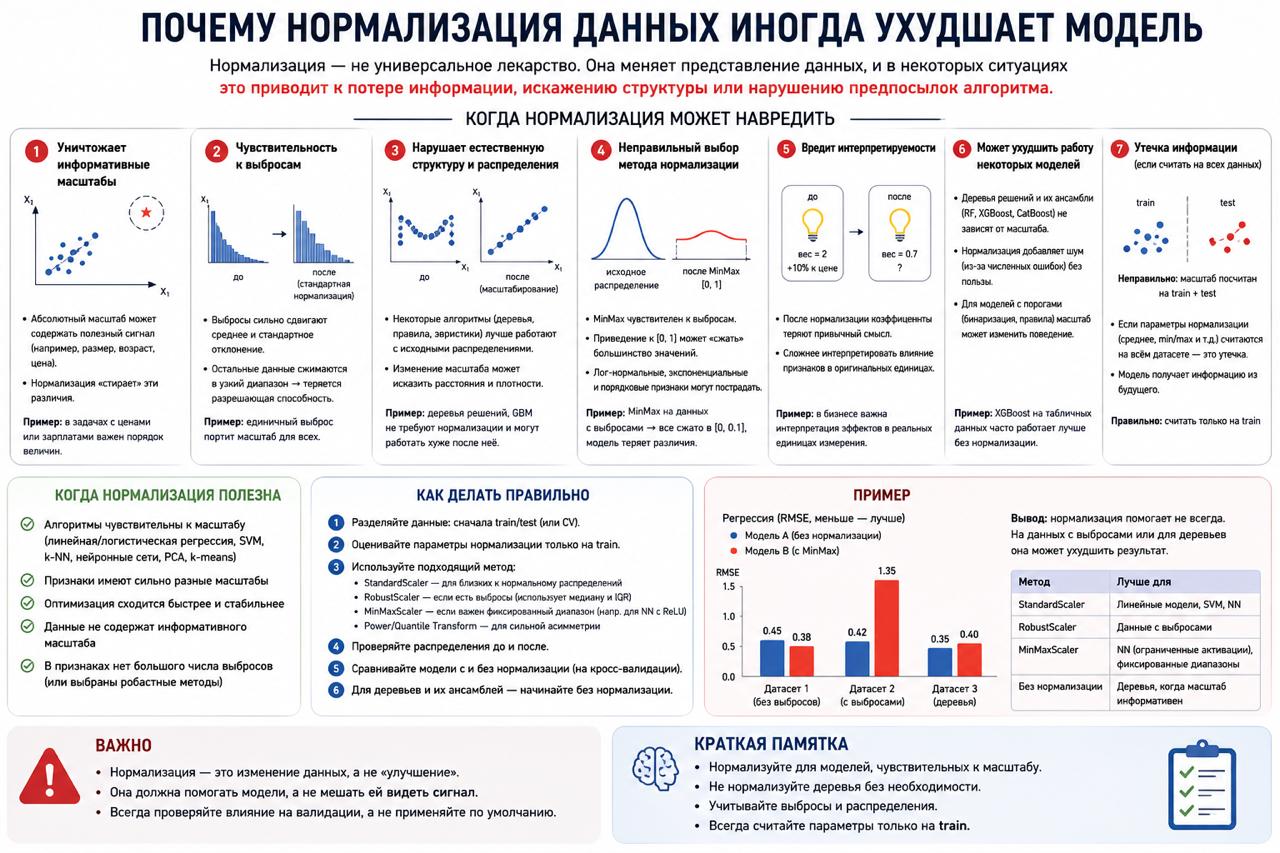
Потому что нормализация нужна не всегда.
Что вообще делает нормализация
Она приводит признаки к одному масштабу.
Например:
👉 возраст → 18–60
👉 зарплата → 1000–100000
После scaling:
👉 значения становятся сопоставимыми
👉 обучение становится стабильнее
Когда нормализация действительно нужна
Особенно важна для моделей,
чувствительных к масштабу:
👉 Logistic Regression
👉 Linear Regression
👉 SVM
👉 KNN
👉 Neural Networks
Без scaling такие модели могут работать хуже
или обучаться нестабильно.
А теперь главное
Деревьям scaling обычно не нужен.
Это:
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
Почему?
Потому что деревья делают split’ы:
feature < threshold
Им неважно:
👉 0.5 это или 5000
👉 масштаб почти не играет роли
Как нормализация может ухудшить модель
1. Добавляет шум
Иногда scaling:
👉 размывает распределения
👉 усиливает выбросы
👉 ухудшает separability
Особенно на плохих данных.
2. Ломает интерпретируемость
Было:
👉 доход = 5000
Стало:
👉 доход = -0.73
Бизнесу это уже сложнее объяснять.
3. Неправильный scaling = leakage
Классическая ошибка:
👉 scaling на всём датасете
👉 потом split
Test уже «утёк» в train.
4. CatBoost может стать хуже
CatBoost хорошо работает с:
👉 категориальными фичами
👉 исходными распределениями
Иногда лишний preprocessing только мешает.
Самый важный инсайт
Scaling — это не «улучшение данных».
Это инструмент под конкретную модель.
Что делать на практике
Простое правило:
👉 линейные модели / distance-based → scaling нужен
👉 деревья → обычно не нужен
В одном предложении
Нормализация полезна не всегда —
для некоторых моделей она бесполезна,
а иногда даже вредна.