В мире ML есть странный культ сложных моделей.
Если задача табличная —
многие сразу запускают:
👉 XGBoost
👉 LightGBM
👉 CatBoost
А потом удивляются,
что простая логистическая регрессия работает не хуже.
Иногда — даже лучше.
Почему все недооценивают Logistic Regression
Потому что она:
👉 старая
👉 простая
👉 «не хайповая»
Но у неё есть огромный плюс:
Она очень хорошо обобщает.
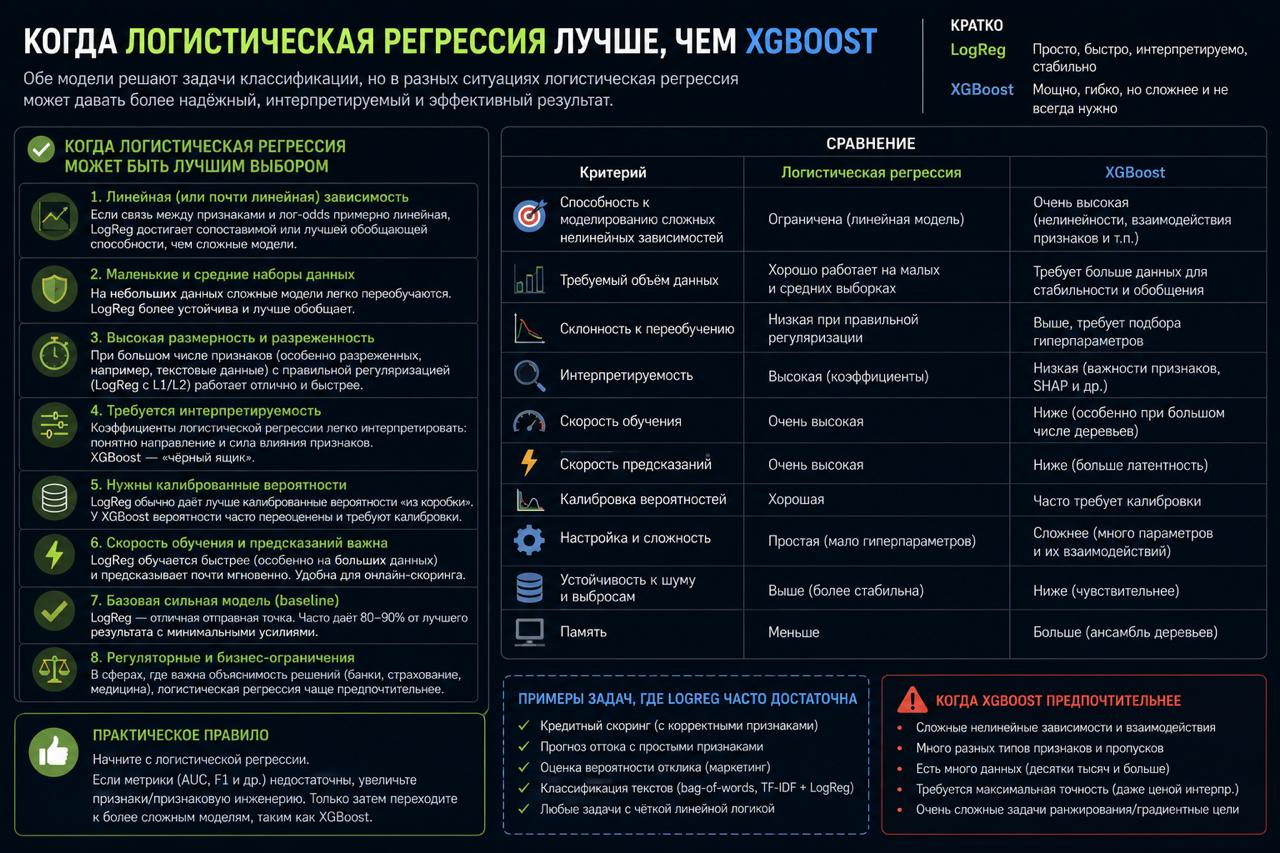
Когда Logistic Regression выигрывает
1. Мало данных
Если у тебя:
👉 маленький датасет
👉 мало наблюдений
👉 мало signal
Бустинг легко переобучается.
Логистическая регрессия:
👉 проще
👉 стабильнее
👉 менее чувствительна к шуму
2. Линейная зависимость
Если данные разделяются почти линейно:
Сложная модель просто не нужна.
XGBoost будет:
👉 строить сложные деревья
👉 искать несуществующие паттерны
3. Высокая размерность
Особенно:
👉 NLP
👉 sparse features
👉 TF-IDF
Logistic Regression здесь очень сильна.
Почему:
👉 хорошо работает с разреженными данными
👉 быстро обучается
👉 эффективно регуляризуется
4. Нужна интерпретируемость
Логистическая регрессия:
👉 прозрачна
👉 объяснима
👉 понятна бизнесу
Можно сказать:
👉 какой признак влияет
👉 насколько влияет
👉 в какую сторону влияет
Для финтеха, медицины и скоринга это критично.
5. Ограничения по скорости
Logistic Regression:
👉 быстро обучается
👉 быстро работает
👉 мало потребляет памяти
Иногда latency важнее +2% качества.
Где XGBoost всё-таки сильнее
Когда:
👉 сложные нелинейные зависимости
👉 interaction effects
👉 много данных
👉 хороший feature engineering
Тогда бустинг почти всегда победит.
Самая частая ошибка
Люди сравнивают:
👉 плохо настроенную Logistic Regression
👉 и хорошо настроенный XGBoost
А потом говорят:
«Линейные модели умерли».
Нет.
Часто baseline даже не пытались нормально сделать.
Главный инсайт
Сложная модель не делает тебя хорошим ML-инженером.
Умение понять, когда хватит простой модели — делает.
В одном предложении
Если задача простая, данных мало или нужна интерпретируемость —
Logistic Regression может быть лучше XGBoost.