
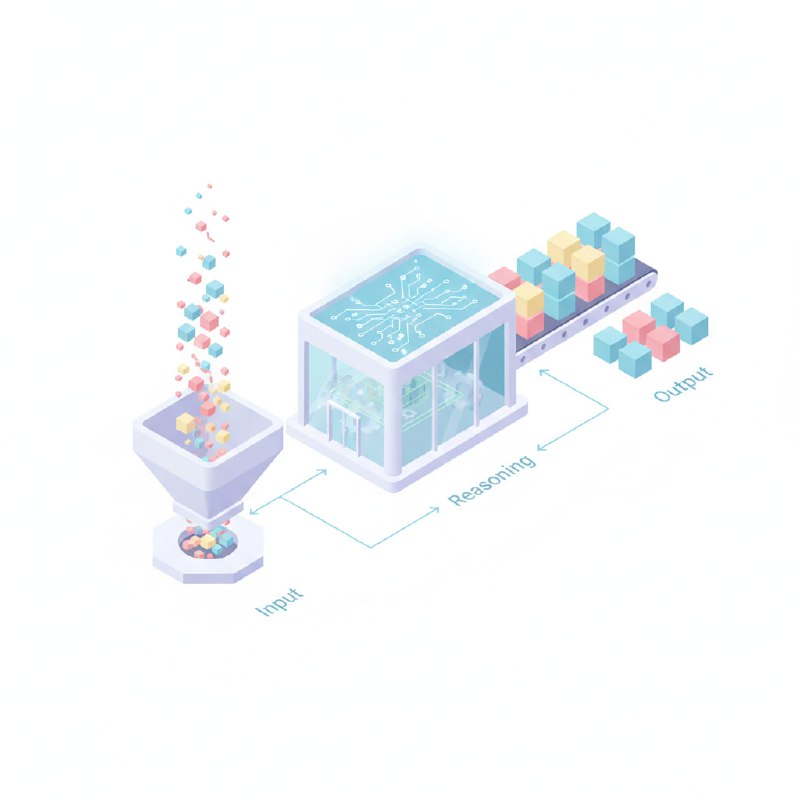
Когда речь идет о больших языковых моделях (LLM), большинство людей думают, что всё сводится к поиску «хитрого» промпта. Но это не так. На самом деле, успешная работа с LLM в продакшн-среде зависит не только от того, что мы ей даём, но и от того, как управляем её рассуждениями и как обрабатываем результат. Сегодня хочу поделиться своими мыслями о паттернах, которые я использую, чтобы превратить эту мощную технологию в инструмент, способный решать реальные задачи.
Что за паттерны?
Задумайтесь: мы работаем с LLM как с набором инструментов, а не как с волшебной коробочкой, которая даст вам готовый ответ на всё. Тут важно понимать, как и на каких этапах можно вмешиваться в процесс. Итак, рассмотрим паттерны работы с LLM по этапам: от ввода (Input) до вывода (Output). Я собрал основные подходы, которые помогут вам извлечь максимум пользы из нейросетей.
✔️ Входные данные: как настроить контекст
Всё начинается с контекста. Даем ли мы LLM достаточно информации для правильного понимания задачи? От этого зависит, как она сгенерирует ответ. Промптинг — это базовый шаг, где вы формулируете запрос, подставляя в него все необходимые переменные. Здесь важно быть максимально точным и учесть все нюансы. Вы также можете использовать такие технологии, как Retrieval-Augmented Generation (RAG), чтобы дополнить запрос свежей информацией из базы данных.
✔️ Управление рассуждениями: как заставить модель думать
Теперь, когда LLM понимает задачу, важно, чтобы она правильно решала её. Часто модели делают ошибки, пытаясь «сразу ответить». Чтобы этого избежать, можно разбить задачу на шаги. Например, используйте технику Chain of Thought (CoT), чтобы попросить модель «думать по шагам».
Другой интересный паттерн — это агенты и инструменты, которые предоставляют модели дополнительные возможности для работы с внешними системами, такими как поиск в интернете или доступ к API. С помощью инструментов модель может «вызывать» внешние функции, например, искать информацию в интернете или работать с базой данных.
✔️ Структурированные выводы: как гарантировать правильность результата
Порой важно, чтобы вывод был не только точным, но и структурированным. Для этого можно использовать структурированные выводы, например, Pydantic-классы, которые задают схему данных. Это поможет избежать ошибок в форматировании, а модель будет следовать правилам, не выходя за рамки нужной структуры.
✔️ Работа с результатом: как его обрабатывать и улучшать
После того как модель сгенерировала ответ, важно его проверить и отформатировать. Если ответ оказался ошибочным, используйте исправляющие промпты, чтобы модель перегенерировала результат с учётом ошибок.
Также не забывайте про Guardrails — фильтры безопасности, которые могут предотвратить нежелательные или опасные ответы. Это может быть полезно, например, для исключения токсичного контента или нежелательных результатов.
Как видите, работа с LLM требует грамотного подхода на каждом этапе: от формирования запроса до обработки результатов. Здесь важно не только дать машине информацию, но и контролировать её мышление. Успех в продакшн-среде зависит от того, насколько чётко вы выстроите взаимодействие с моделью.
Data Science