Как заставить AI-модели летать в проде не сжигая бюджеты на GPU
Обучить модель - это только часть дела. Значительная часть проявляется на этапе деплоя: какая точность весов нужна, какая ширина контекста требуется и будет ли это использоваться пользователями или автономными агентами. Знакомая ситуация?
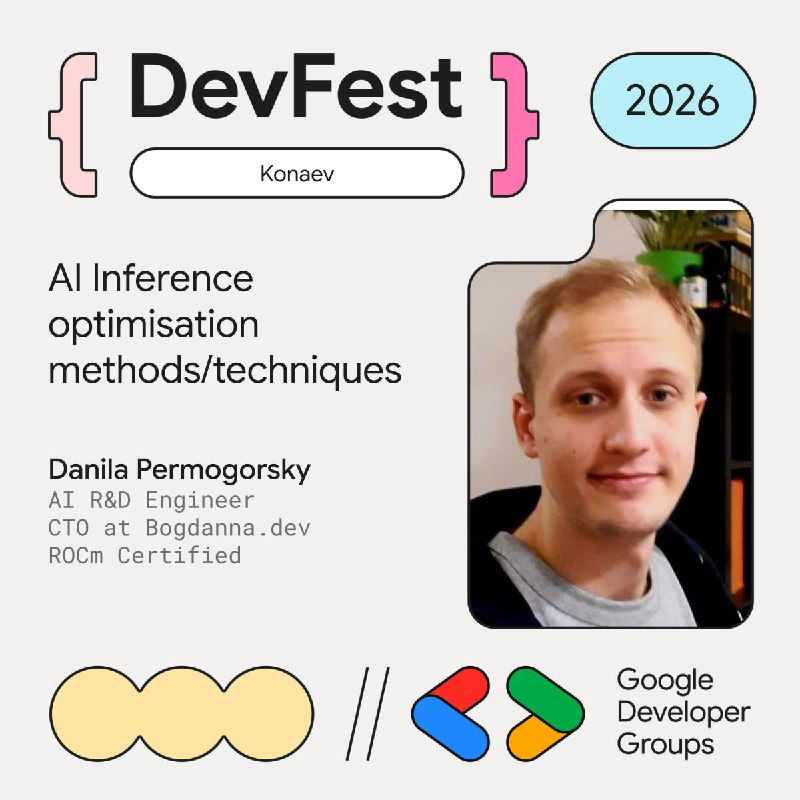
На нашем предстоящем митапе в Конаеве эту тему разберет по косточкам Данила Пермогорский — AI R&D Engineer, CTO в Bogdanna.dev и контрибьютор библиотек AMD ROCm.
🔥 Тема доклада: Методы и техники оптимизации AI-инференса.
Что будем обсуждать:
• Как выжать максимум производительности из доступного железа.
• Техники снижения latency и потребления памяти (без критической потери качества).
• Как правильно готовить модели к production-нагрузкам.
• Инсайты от инженера с практическим опытом оптимизации, включая уровень вычислений (hardware level).
• Развеем мифы о AMD, NVIDIA, поговорим про RISC V GPU, рассмотрим их отличия и выясним почему цена на чипы высокая.
Если вы деплоите LLM, работаете с компьютерным зрением или просто хотите понимать, как устроен production ML «под капотом» — этот доклад точно нельзя пропускать. Будет много технического мяса! 🥩
📍 Встречаемся в Конаеве. Точное время доклада — 16:20.
👇 Пишите в комментариях свои боли с инференсом или вопросы Даниле — самые интересные разберем прямо на митап. Регистрация здесь. https://gdg.community.dev/events/details/google-gdg-konaev-presents-devfest-konaev-2026/ @devs_kz
Post #7339
569
- ❤ 2