TGViewer
Channel Public Channel
KazDevOps

KazDevOps

@devopskaz

Канал о DevOps во всех проявлениях: K8s, CI/CD, HighLoad, AI/ML, Cloud, Linux
Возьмем на поддержку DevOps: https://core247.kz/
По рекламе @UlKonovalova
Subscribers
6.87K
Photos
1.7K
Videos
28
Links
1.6K

Showing posts older than #1455 · Back to latest

Older Posts 11 shown
Post #1454 1.64K
🔥 CORE 24/7 приглашает на вакансию DevOps-инженера

Алматы/Астана, офис
Опыт работы: 2-3 года
Полная занятость
ЗП: 450 000 — 1 000 000 тг.


Задачи:
— Поддерживать production так, чтобы бизнес был спокоен
— Спасать клиентов в случае аварий
— Выстраивать процессы CI/CD
— Переносить приложения в Kubernetes. Запускать и настраивать их
— Конфигурировать СУБД, серверы очередей и прочий софт. Делать более надежными и быстрыми.
— Разрушать стену между разработкой и администрированием

С кем вы будете работать:
— С клиентом, тимлидом и ПМом
— С командой разработки инструментов, сервисов и технологий для упрощения работы (автоматизация наше все)

Требования:
— Отличные знания Linux-систем - ежедневная эксплуатация от 3 лет, опыт в DevOps - от 1 года
— Понимание работы веб-приложений и опыт их эксплуатации - от 3 лет
— Понимание веб-стека (HTTP, TCP/IP), устройства и работы сетей, базовые навыки с iptables
— Понимание принципов СУБД, построения и эксплуатации распределенных систем
— Умение сформулировать алгоритм и писать скрипты

Что мы предлагаем:
— Погружение в передовые cloud-native-технологии и участие в разработке Open Source / AI продуктов.
— Уникальная открытая корпоративная культура: отсутствие строгой субординации, самостоятельность и доверие.
— Постоянное обучение у крутых коллег, которые готовы делиться опытом: у нас есть все необходимое для роста и развития.
— Курсы английского языка, отраслевую сертификацию, компенсацию тренажерного зала и прочие бонусы.

Писать сюда:
👉 aissabekova@core247.io
👉 @issaika

Полное описание вакансии

@DevOpsKaz 😛
  • ❤ 10
  • 👍 8
  • 😎 5
  • 🤡 3
  • 🥱 1
Post #1453 1.46K
🔥 Устройство файловых систем контейнеров

Контейнеры — это черный ящик для большинства инженеров. Предлагаем статью, которая позволяет лучше разобраться в том, как именно они устроены и работают.

После пояснения основных концептов на наглядных примерах создадим файловую систему контейнера, имитируя деятельность Docker.

👉 Читайте в блоге

@DevOpsKaz 😛
  • 👍 6
  • 😎 4
  • ❤ 3
Post #1451 1.58K
🔥 Митап для лидеров микрофинансового рынка

Rocket Tech и Halyk Bank приглашают топ-менеджеров и продуктовые команды обсудить ключевые тренды в микрофинансовых услугах.

📣 Ключевые участники встречи:

CTO, CPO, CIO, PO, PM, разработчиков и дизайнеров ведущих МФО, банков и финтех-компаний Центральной Азии.

В программе:

• Реальные кейсы
• Инсайты от лидеров индустрии
• Нетворкинг с ключевыми игроками

📅 16 мая
🕑 14:00
📍 Smart Point

Для гостей — кейтеринг: можно перекусить, пообщаться и завести полезные знакомства. Присоединяйтесь к обсуждению!

👉 Регистрируйтесь здесь

#партнерский_пост

@DevOpsKaz 😛
  • 👍 3
  • 😎 3
  • ❤ 2
  • ⚡ 2
Post #1450 1.38K
🔥 Как Amazon справилась с нехваткой GPU

В 2024 году Amazon столкнулась с глобальной нехваткой GPU из-за бума ИИ-технологий и дефицита чипов NVIDIA. Это сильно ударило по ретейл-подразделению, где внутренние проекты начали тормозить из-за недостатка вычислительных ресурсов.

Если инфраструктура не справляется с нагрузкой, это напрямую влияет на скорость разработки, доставку продуктов и, в конечном счёте, на прибыль компании.


💡 Решение: Project Greenland и новые правила распределения

Компания ввела строгие правила, основанные на следующих принципах:

⚪️ Приоритет по ROI: мощности GPU распределяются по проектам, которые приносят наибольшую финансовую выгоду или снижают затраты. Если проект не оправдывает ожиданий, выделенные ресурсы могут быть отозваны.
⚪️ Централизованное управление: все запросы на GPU теперь проходят через Project Greenland, что позволяет отслеживать использование ресурсов и перераспределять их между командами.
⚪️ Максимальная утилизация: платформа следит за простаивающими серверами и перераспределяет их на более приоритетные задачи.
⚪️ Долгосрочный рост: распределение ресурсов должно способствовать увеличению свободного денежного потока компании в будущем.

Результат:

К 2025 году ситуация улучшилась. Дефицит GPU устранён, а их собственный чип Trainium начал удовлетворять потребности ретейл-подразделения к концу года.

Project Greenland показывает, как централизованное управление и приоритизация по бизнес-целям помогают справляться с ограничениями ресурсов. DevOps-команды могут адаптировать этот подход, особенно если работают с ресурсоемкими ИИ.

@DevOpsKaz 😛
  • 👍 6
  • 🔥 3
  • ❤ 2
Post #1449 1.53K
🔥 Новости мира DevOps и не только

⚪️ Oracle Critical Patch Update

Oracle исправила 378 уязвимостей в MySQL, Java SE, VirtualBox и других продуктах в апрельском обновлении безопасности.

⚪️ Freedom Cloud в Казахстане

В Алматы началось строительство дата-центра Freedom Cloud с инвестициями 175 млрд тенге от Freedom Holding Corp. Проект усилит цифровую инфраструктуру, создаст рабочие места и будет соответствовать стандартам NVIDIA.

⚪️ Almaty Hub: трансформация инноваций

«Парк инновационных технологий» переименован в Almaty Hub (by Astana Hub). Новый гендиректор Ержан Тасмухан займётся развитием стартапов и привлечением инвестиций.

⚪️ Казахстанские стартапы в StartX

Наш клиент — Parqour (управление парковками), Aidentis (AI-диагностика в стоматологии) и TrustExam.ai (честность онлайн-обучения) прошли в летнюю программу акселератора StartX при Стэнфорде.

@DevOpsKaz 😛
  • 🔥 7
  • 👍 5
  • ❤ 3
  • 😎 1
Post #1448 1.59K
🔥 Участвуйте в AppSecFest 2025 — выигрывайте 4 Macbook-а и другие призы

Уже в эту пятницу 25 апреля мы встретимся на важном событии в мире IT, разработки и безопасности — AppSecFest 2025.
В программе:

⚪️ 2 конференц-зоны: App — инновации в разработке ПО, Sec — все о безопасности приложений
⚪️ 20+ ведущих спикеров: топовые эксперты поделятся своими знаниями и опытом
⚪️ 2+ панельные сессии: обсуждения горячих тем и трендов отрасли
⚪️ 1000+ участников — возможность для нетворкинга и обмена опытом
⚪️ Лидеры индустрии — познакомьтесь с ключевыми игроками и партнерами
⚪️ Игровая зона и дрон-футбол
⚪️ Подарки и розыгрыши
⚪️ OpenCTF

➡️ Регистрируйтесь здесь

Ждем вас на AppSecFest 2025 в Алматы!

#партнерский_пост

@DevOpsKaz 😛
  • 🔥 6
  • ⚡ 4
Post #1447 1.65K
🔥 CPU Limits в Kubernetes: Как избежать троттлинга и ускорить приложения

Статья по докладу о CPU Limits в Kubernetes объясняет их влияние на производительность контейнеров. Автор разбирает концепцию CPU Requests и Limits, их связь с cgroups v2 и даёт рекомендации по использованию.

Самое главное ниже 👇

CPU Requests задают минимально гарантированное процессорное время для контейнера, а CPU Limits — максимальное.

Limits ограничивают использование процессора в "окне" 100 мс (например, при лимите 0.4 ядра контейнер получит 40 мс из 100 мс). Это реализуется через cgroups v2 в Linux, которые управляют распределением ресурсов.


Проблемы с CPU Limits:

Для приложений, чувствительных к задержкам, throttling критичен: могут не сработать liveness probes, пропуститься heartbeat-события, увеличиться задержка ответа.

Даже при низкой загрузке процессора (например, 50%) контейнер может троттлиться из-за многопоточности или ошибок в ядре Linux.

Как работает throttling:

Если задаче нужно 200 мс процессорного времени, но у вас лимит 0.4 (40 мс на 100 мс), то 160 мс придётся ждать новых "окон". Итог: задача займёт 440 мс вместо 200 мс, так как 60 мс в каждом окне — это простой. Throttling (замедление) возникает, даже если у узла есть свободные ресурсы.

Когда использовать CPU Limits:

⚪️ Нужно: в редких случаях, например, для пакетных задач (batch jobs), где задержки некритичны, или если есть баг в приложении, из-за которого оно потребляет слишком много CPU.
⚪️ Не нужно: для большинства приложений, особенно чувствительных к задержкам (веб-серверы, базы данных). Лучше полагаться на CPU Requests, чтобы гарантировать минимум ресурсов без искусственного замедления.

Рекомендации:

➖ Устанавливайте только CPU Requests, чтобы гарантировать минимум ресурсов без троттлинга.
➖ Если Limits всё же нужны, делайте их значительно выше Requests (например, в 2–3 раза), чтобы учесть пиковые нагрузки.
➖ Регулярно мониторьте метрики и корректируйте настройки, особенно при росте нагрузки.
➖ Проверяйте логи приложений на увеличение времени обработки запросов.
➖ Обновляйте ядро Linux до версий без багов CFS (Completely Fair Scheduler), которые могут вызывать лишний троттлинг.

@DevOpsKaz 😛
  • 👍 8
  • ⚡ 4
  • 🔥 4
Post #1438 1.55K
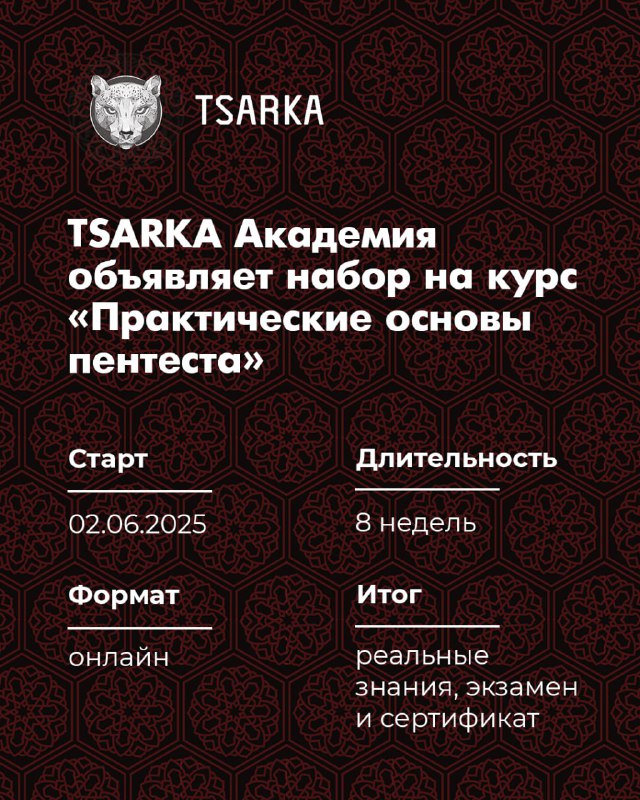
🔥 TSARKA Академия объявляет набор на курс «Практические основы пентеста»

Погрузитесь в этичный хакинг и научитесь видеть системы изнутри – глазами тех, кто их тестирует на прочность.

Старт — 2 июня
Длительность — 8 недель
Формат — онлайн
Итог — реальные знания, экзамен и сертификат


Курс подойдет, если вы:


— разработчик, который хочет делать по-настоящему защищённые приложения
— админ или devops-инженер, настраивающий инфраструктуру «без дыр»
— специалист по ИБ или стремящийся стать профессиональным пентестером —
этот курс для вас.

Вы получите:

— понимание, как ОС и фреймворки работают изнутри;
— реальные кейсы по выявлению уязвимостей;
— опыт практического пентеста под руководством экспертов;
— навыки, которые можно применять сразу.

❗️ Важно: нужен базовый уровень ИТ, ИБ и понимание программирования.

👉 Записаться на курс

#партнерский_пост

@DevOpsKaz 😛
  • 👍 3
  • 🔥 3
  • 🤮 3
  • ❤ 2
  • 😎 2
Post #1437 1.19K
MoE — это архитектура, где большая нейросеть разделяется на несколько специализированных подсетей (экспертов), а гейтинг-сеть (маршрутизатор) решает, кто лучше справится с конкретным запросом. Это позволяет экономить вычислительные ресурсы.

Как работает MoE:

⚪️ Эксперты: подсети (например, feed-forward сети), каждая из которых специализируется на определённой части данных. Например, в языковых моделях один эксперт может понимать синтаксис, другой — семантику.
⚪️ Гейтинг-сеть: решает, какие эксперты будут задействованы для конкретного запроса, присваивая каждому эксперту вес. Например, в Mixtral 8x7B для каждого токена выбираются два эксперта из восьми.
⚪️ Селективность: в отличие от классических моделей, где вся сеть работает всегда, MoE активирует только нужные части, что ускоряет обучение и инференс.

Плюсы MoE:

⚪️ Экономия ресурсов: увеличивает размер модели (больше параметров), но не увеличивает вычислительные затраты.
⚪️ Гибкость: эксперты могут специализироваться на разных задачах, что улучшает качество обработки сложных данных.
⚪️ Масштабируемость: MoE позволяет создавать модели с триллионами параметров, как в случае с GLaM или Switch Transformers.

Минусы и сложности:

⚪️ Балансировка нагрузки: если гейтинг-сеть плохо распределяет задачи, некоторые эксперты могут быть перегружены, а другие — простаивать. Для этого добавляют вспомогательные функции потерь (auxiliary loss).
⚪️ Обучение: требует тонкой настройки, так как гейтинг-сеть и эксперты обучаются одновременно. Нужны большие батчи данных, чтобы маршрутизация была эффективной.
⚪️ Специализация: эксперты не всегда учатся понимать конкретные домены (например, биологию), а скорее фокусируются на низкоуровневых аспектах, таких как синтаксис.

Примеры применения:

➖ В языковых моделях (NLP): Switch Transformers, Mixtral 8x7B, GLaM — для обработки текстов с высокой эффективностью.
➖ В компьютерном зрении: MoE помогает справляться с большими наборами данных, где разные эксперты могут фокусироваться на разном.
➖ В системах рекомендаций: MoE улучшает персонализацию, разделяя пользователей на кластеры и подбирая для каждого подходящего эксперта.

👉 Посмотреть тест-драйв технологии

@DevOpsKaz 😛
  • 🔥 5
  • 👍 4
  • 😎 3
Post #1436 1.18K
🔥 Почему Сложность Kubernetes — это не шутки

Сегодня пост для новичков, которые только осваивают Kubernetes или подумывают об этом. Разбираем сложность сервиса:

➖ Поднять базовый кластер k8s можно за 15 минут, но для реальной работы нужно глубокое планирование, которое занимает дни. Без подготовки придётся переделывать всё несколько раз.

➖ Один лишь неправильно настроенный лимит ресурсов может привести к эффекту домино, когда весь кластер рушится из-за одной ошибки.

➖ Нужно освоить 20–30 команд kubectl, разбираться в YAML-манифестах, а ещё понять такие сложные концепции, как namespaces, RBAC (Role-Based Access Control), ConfigMaps и Secrets.

➖ Даже базовые задачи вроде настройки Ingress или управления подами могут превратиться в квест на выживание. Неправильно настроенный под может съесть все ресурсы кластера, оставив вас с горящим сервером и нулевым пониманием, что пошло не так.

➖ Kubernetes любит унижать пользователей на разных этапах: от настройки сети до управления лимитами. Например, один неверный параметр в манифесте — и ваш кластер превращается в цирк.

➖ Без плана развертывания в Kubernetes вы будете как капитан корабля, который забыл, что море — это мокро.

➖ Написать код — быстро. А вот развернуть его в Кубере первый раз — это дни мучений! Сертификаты, связь между сервисами, настройка Argo CD с ключами — всё совершенно неинтуитивно.

Чтобы сразу не спуститься в ад и выдержать сложность сервиса, рекомендуем:

⚪️ Установите Minikube — чтобы попробовать Kubernetes в миниатюре и не убить себя морально.
⚪️ Используйте Kubespray для запуска кластера без лишних заморочек.
Для обучения используйте официальную документацию k8s (разделы Concepts и Tasks),
⚪️ Прочтите книги Production Kubernetes и Networking and Kubernetes (есть на русском).
⚪️ Попробуйте GUI для k8s — Lens, который спасёт ваши нервы, и методологию The Twelve-Factor App для проектирования приложений, чтобы не изобретать велосипед с квадратными колёсами.

Если самому — сложно. Рекомендуем курс «Kubernetes: База» для администраторов. Узнаете базу: как работать с системой автоматизации развёртывания, масштабирования и управления приложениями в контейнерах.

Старт — уже 12 мая.


@DevOpsKaz 😛
  • ❤ 7
  • 🔥 5
  • 👍 4
Post #1435 1.28K
🔥 Подборка инструментов для DevOps:

⚪️Rancher K3k (Kubernetes in Kubernetes)

K3k от Rancher — это инструмент, который позволяет запускать Kubernetes-кластеры внутри уже существующего кластера Kubernetes.

— Упрощает многопользовательскую работу: создавайте изолированные кластеры для разных команд или проектов.
— Изоляция ресурсов: задавайте лимиты и квоты, чтобы команды не мешали друг другу.
— Интеграция с Rancher: удобно управлять через интерфейс Rancher.

⚪️Git Cheat Sheet

Репозиторий от arslanbilal — это шпаргалка по командам Git и Git Flow.

— Помогает быстро вспомнить команды Git: от базовых до сложных (rebase, cherry-pick).
— Удобен для автоматизации CI/CD: правильное использование Git Flow помогает организовать ветки и релизы.

⚪️Pro DevOps Guy Tech Docs

Документация от Pro DevOps Guy Tech с гайдами по DevOps-инструментам и практикам.

— Пошаговые инструкции: настройка CI/CD, контейнеров, мониторинга.
— Практические советы: например, как оптимизировать пайплайны или настроить Kubernetes.

⚪️ Apache Iceberg (от Confluent)

Apache Iceberg — это движок для управления большими данными, который упрощает работу с таблицами в data lakes.

— Помогает управлять большими данными в реальном времени без сбоев.
— Работает с Apache Kafka, что полезно для потоковой обработки данных.
— Упрощает аналитику: данные легко доступны для аналитических запросов.

Делитесь впечатлениями и кидайте коллегам 🫡


@DevOpsKaz 😛
  • 🔥 7
  • 👍 6
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →