


В 2017 году GitLab пережил кошмарный инцидент: из-за ошибки в управлении данными они потеряли 300 ГБ производственной базы данных. Это был не просто сбой — это был урок, который до сих пор обсуждают в кругах DevOps.
Всё началось с обычной задачи: синхронизировать данные между основным сервером и его репликой. Но в тот день синхронизация застопорилась. Команда решила вручную запустить копирование данных с основного сервера на реплику, используя rsync.
И тут начались проблемы:
⚪️ Сбой синхронизации: реплика отставала на часы, данные не обновлялись.
⚪️ Спам-атака: в это же время кто-то устроил спам-атаку на платформу, что увеличивало нагрузку на базу данных и замедляло всё ещё сильнее.
⚪️ Человеческий фактор: усталый инженер случайно удалил основную базу данных вместо того, чтобы очистить staging-директорию на реплике.
В один момент 300 ГБ данных — проекты, репозитории, issues — просто исчезли. Это был не сбой, а классическая человеческая ошибка под давлением обстоятельств.
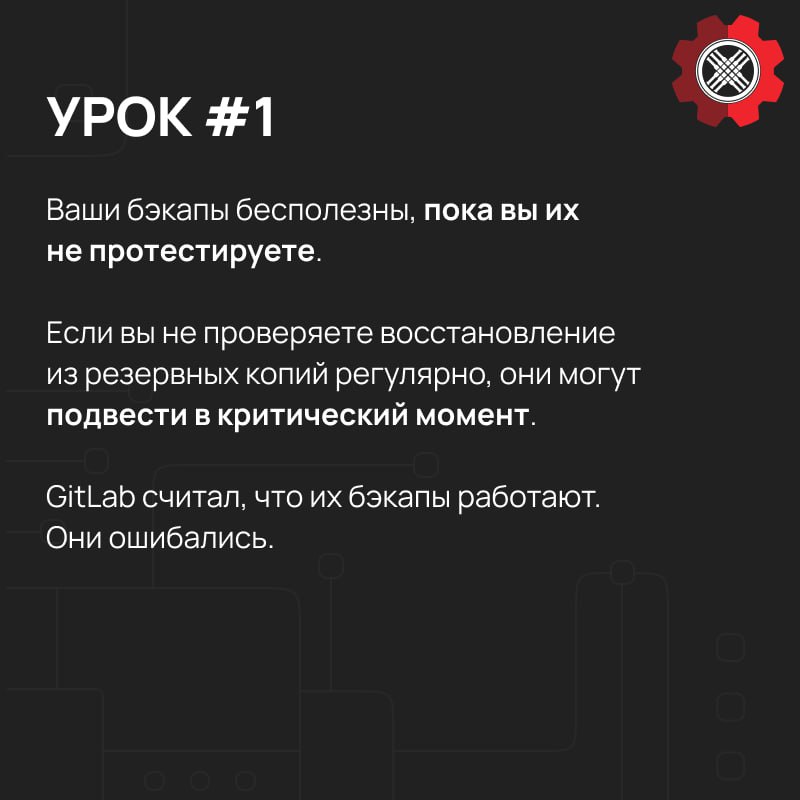
Уроки, которые Gitlab вынес из инцидента в карточках выше 👆
@DevOpsKaz 😛