
Крупные инциденты случаются даже в зрелых инфраструктурах. Масштаб не защищает от сбоев — он лишь увеличивает сложность и число точек отказа.
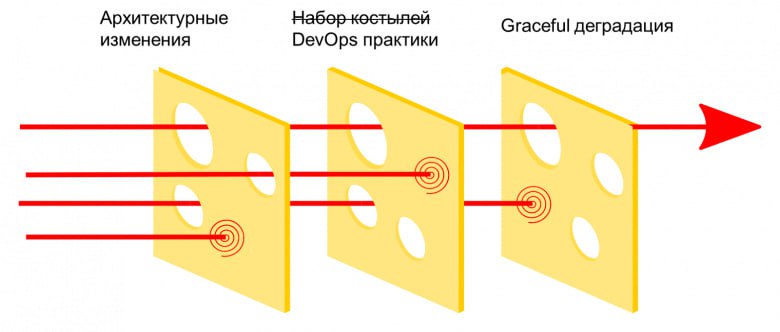
В конце 2024 года в Yandex Cloud отказал один сетевой контроллер — и это стало стартовой точкой цепочки взаимосвязанных ошибок, которая привела к потере внешней связности в нескольких зонах доступности. Классический пример «слоёного пирога» и «швейцарского сыра»: одна проблема тянет за собой каскад других.
Но важнее не сам факт сбоя, а то, как команда отреагировала и что сделала дальше. Константин Крамлих из Yandex Cloud опубликовал подробный инженерный разбор, где объясняет, какие изменения внедрили, чтобы сеть стала устойчивее.
Среди ключевых решений, которые уже внедрены в сеть, — режим Fail Safe, который позволяет ограничивать негативное влияние одного компонента на всю систему, и механизмы ограничения очередей, которые предотвращают нарастание задержек и деградацию сервиса при росте нагрузки.
Также изменили логику работы балансировщиков: управление зонами стало более гибким, что позволяет быстрее изолировать проблемную зону и перераспределить трафик без потерь доступности.
Отдельно улучшили процессы: релизы стали более “пошаговыми”, с обязательными проверками и откатом, а Incident Management — более структурированным, с чёткими ролями, триггерами и метриками восстановления.
Весь разбор доступен по ссылке.
Post #2038
3.8K

- ❤ 3
- 👍 3
- 🔥 3
- 🖕 1