TGViewer
Channel Public Channel
DevOps Ready | IT

DevOps Ready | IT

@devops_ready

Авторский канал по DevOps разработке.
Ресурсы, обучения, задачи, шпаргалки.
Ежедневно информация пополняется!

Cотрудничество: @energy_c
Subscribers
7.65K
Photos
872
Videos
77
Links
494

Showing posts older than #682 · Back to latest

Older Posts 10 shown
Post #680 1.15K
Как диагностировать нестабильные systemd-сервисы!

Если система в целом работает корректно, но отдельные сервисы периодически падают или перезапускаются, диагностику удобно начинать со systemd и его журналов.

Сервисы в ошибочном состоянии:
systemctl --failed


Показывает юниты, завершившиеся с ошибкой — базовая точка входа.

Перезапуски конкретного сервиса:
journalctl -u nginx --no-pager -g 'Starting|Stopped|Failed'


Позволяет быстро выявить циклические рестарты и их частоту.

Автоматические рестарты systemd:
journalctl -b | grep -Ei 'systemd\[1\].*(restart|Restart)'


Помогает обнаружить сервисы, которые systemd регулярно перезапускает.

Количество рестартов:
systemctl show nginx -p NRestarts


Счётчик рестартов с момента запуска systemd. Рост значения обычно указывает на нестабильность сервиса.

Причина остановки:
journalctl -xeu nginx


Даёт максимальный контекст ошибки и системные пояснения.

Проверка OOM-killer:
journalctl -k -b | grep -Ei 'oom|oom-kill|killed process'


Актуально, если сервис завершается без явных ошибок в собственных логах.

Конфигурация сервиса:
systemctl cat nginx


Позволяет проверить параметры рестарта, drop-in override’ы, зависимости и условия запуска.

🔥 Такой разбор покрывает большинство случаев нестабильной работы systemd-сервисов без дополнительных инструментов.

➡️ DevOps Ready | #практика
  • ❤ 6
  • 👍 5
  • 🔥 5
Post #678 1.16K
✍️ perf-tools — набор инструментов для анализа производительности!

Репозиторий от Brendan Gregg — одного из главных экспертов по performance и Linux-трейсингу. Здесь собраны готовые скрипты и утилиты для поиска узких мест по CPU, памяти, дискам и сети с использованием perf, ftrace, bcc и eBPF.

Оставляю ссылочку: GitHub 📱


➡️ DevOps Ready | #репозиторий
  • 🔥 8
  • ❤ 7
  • 👍 5
Post #677 1.18K
Знали, что можно сравнивать вывод команд напрямую — без временных файлов?

Bash и Zsh умеют подставлять вывод команд как псевдофайлы, что идеально для сравнения конфигов, списков и результатов команд.
diff <(ls /etc) <(ls /etc.backup)


<(...) превращает вывод команды в псевдофайл (обычно /dev/fd/* или FIFO), который программа читает как обычный файл.

Можно сравнить локальный и удалённый конфиг:
diff nginx.conf <(ssh server 'cat /etc/nginx/nginx.conf')


Или проверить, что изменилось после деплоя, без копирования и мусора в /tmp.

🔥 Process substitution (<(...)) отлично работает с diff, grep, sort, comm, wc. Это быстрый способ сравнивать данные, но он зависит от shell и не поддерживается в sh/dash.

➡️ DevOps Ready | #совет
  • 🔥 8
  • 👍 6
  • 🤝 5
Post #675 1.19K
Как посмотреть, какие systemd‑юниты тормозят загрузку?

Когда система грузится медленно, чаще всего виноваты несколько сервисов, которые стартуют дольше остальных. Их удобно найти штатными инструментами systemd — без сторонних профайлеров и сложных настроек.

Ключевой блок кода для шапки:
systemd-analyze blame | head


Основной приём — использовать  systemd-analyze :
systemd-analyze time
systemd-analyze blame


Первая команда покажет, сколько времени заняли загрузка ядра, initrd и пользователей.
Вторая выведет список юнитов с временем старта, отсортированный по убыванию — «топ тормозов» будет наверху.

Если нужно докопаться до деталей конкретного сервиса:
systemd-analyze critical-chain nginx.service


🔥 Так видно, какие юниты ждал  nginx.service , сколько занял каждый шаг и где именно цепочка загрузки «застревает».

➡️ DevOps Ready | #совет
  • ❤ 8
  • 👍 5
  • 🔥 4
Post #673 1.36K
📂 Напоминалка для работы с iptables!

Например, iptables -L позволяет быстро посмотреть текущие правила, а iptables -A — добавить новое правило для разрешения или блокировки трафика.

На картинке — полезные команды, которые стоит держать под рукой при работе с Linux-серверами, сетями и Docker.

Сохрани, чтобы не забыть!

➡️ DevOps Ready | #ресурс
  • 👍 5
  • 🔥 5
  • ❤ 4
Post #668 1.2K
🖼️ Продумываем lifecycle Docker-образов — экономим место и не тонем в легаси‑артефактах!

Если просто пушить образы в реестр на каждый коммит, хранилище быстро превращается в свалку: непонятные теги, старые версии и гигабайты, за которые уже платишь, хотя они давно не попадают в прод.

В этом посте:
• Разбираем, как выбрать стратегию тегирования (semver, latest, stable, датированные теги).

• Настраиваем retention‑политику в реестре, чтобы старые и неиспользуемые образы чистились автоматически.

• Добавляем регулярную очистку локальных образов и томов на нодах.

• Как один раз договориться о правилах lifecycle и забыть про «диск забит docker‑мусором».


Такой подход делает работу с Docker предсказуемой: образы живут полный, но ограниченный жизненный цикл, а инфраструктура не зарастает артефактами.

➡️ DevOps Ready | #гайд
  • 🔥 12
  • 👍 5
  • ❤ 4
Post #661 1.25K
Удобный способ смотреть логи и сразу находить проблемы!

Часто при анализе логов нужно видеть только важное, а не пролистывать тысячи строк вручную.

Самый базовый и рабочий вариант:
tail -f application.log | grep -i error


tail -f следит за обновлением файла,
grep -i ищет совпадения без учёта регистра.

Если нужно ловить сразу несколько типов проблем:
tail -f application.log | grep -i -E "(error|warning|failure)"


-E включает расширенные регулярные выражения.
-P стоит использовать, если реально нужны возможности PCRE (lookbehind и т.п.).

Иногда полезнее сделать наоборот, убрать шум и оставить всё остальное:
tail -f application.log | grep -v -i "info"


🔥 Это особенно удобно, когда exception занимает несколько строк, видно его целиком, без разрывов по уровню логирования.

➡️ DevOps Ready | #совет
  • 🔥 9
  • 👍 7
  • 🤝 6
Post #655 1.39K
🖼️ Проверяем Dockerfile прямо в CI и режем мусор ещё на этапе PR!

Один небольшой job ловит отсутствие HEALTHCHECK, запуск от root и кривую точку входа до того, как образ вообще начнёт собираться.

В этом посте:
• Пишем минимальные bash‑проверки для Dockerfile в пару строк.

• Ловим root, отсутствие FROM/ENTRYPOINT/CMD и базовые анти‑паттерны.

• Встраиваем проверки в GitHub Actions как отдельный шаг.

• Делаем так, чтобы плохой Dockerfile не проходил ревью автоматически.


Такой чекпоинт в CI экономит нервы и ревьюверам, и тем, кто потом дебажит контейнеры в проде. Сохрани формат — сможешь быстро дорастить проверки под свои требования.

➡️ DevOps Ready | #задача
  • ❤ 11
  • 🔥 7
  • 👍 6
Post #653 1.29K
❤️ ArchWiki — супер информативный справочник!

Это огромная база знаний про то, как работает Linux: загрузка системы, systemd, сеть, файловые системы, драйверы, безопасность и оптимизация. Статьи написаны точно и понятно, каждый раздел объясняет почему и как всё устроено. Даже если ты не используешь Arch, сайт объясняет общие принципы Linux, которые применимы в большинстве дистрибутивов.

📌 Оставляю ссылочку: wiki.archlinux.org

➡️ DevOps Ready | #ресурс
  • 🔥 10
  • 👍 6
  • 🤝 5
  • 😁 1
Post #648 1.39K
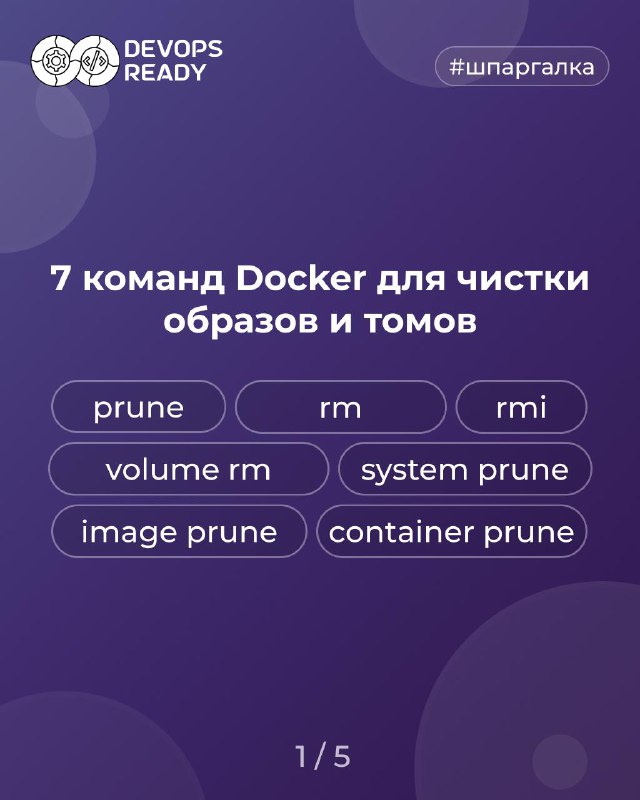
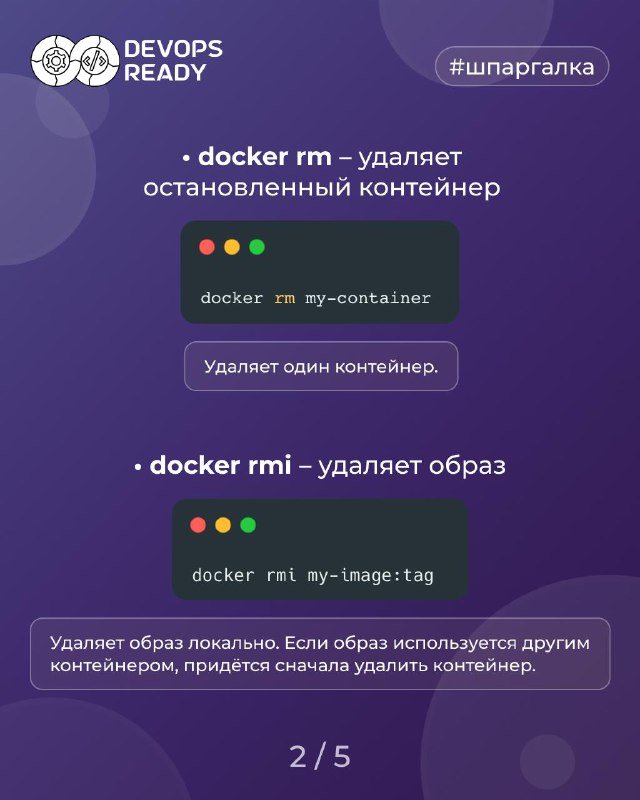
🖼️ Docker: 7 команд для чистки образов и томов!

Docker со временем накапливает кучу старых образов, контейнеров и томов, которые засоряют диск и замедляют работу. В этой шпоре собраны команды для быстрой и безопасной очистки.

➡️ DevOps Ready | #шпора
  • ❤ 8
  • 🔥 8
  • 👍 4
  • 😁 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →