TGViewer
Channel Public Channel
DevOps Ready | IT

DevOps Ready | IT

@devops_ready

Авторский канал по DevOps разработке.
Ресурсы, обучения, задачи, шпаргалки.
Ежедневно информация пополняется!

Cотрудничество: @energy_c
Subscribers
7.61K
Photos
866
Videos
76
Links
486

Showing posts older than #1257 · Back to latest

Older Posts 16 shown
Post #1256 1.35K
Проверяем свободное место перед backup-скриптом!

Очень частая проблема в автоматизации. Backup запускается по cron, архив начинает писаться, а потом диск заканчивается посередине процесса. В итоге получается битый файл, лишняя нагрузка и непонятная ошибка в логах.

Перед созданием архива лучше заранее проверить, хватает ли места.

Сначала зададим директорию и минимальный запас в килобайтах:
backup_dir="/var/backups/app"
min_free_kb=1048576


Теперь получим свободное место через df. Ключ -P делает вывод предсказуемым для скриптов:
free_kb=$(df -Pk "$backup_dir" | awk "NR == 2 {print $4}")


Если места меньше нужного, завершаем скрипт с ошибкой:
if [ "$free_kb" -lt "$min_free_kb" ]; then
echo "not enough disk space" >&2
exit 1
fi


После проверки можно спокойно запускать архивирование:
tar -czf "$backup_dir/app.tar.gz" /opt/app/data


Для cron полезно добавить дату в имя файла, чтобы старые архивы не перезаписывались:
stamp=$(date +%Y%m%d-%H%M%S)
archive="$backup_dir/app-$stamp.tar.gz"


И использовать переменную archive:
tar -czf "$archive" /opt/app/data


Если нужно контролировать размер каталога заранее, можно примерно оценить его через du:
need_kb=$(du -sk /opt/app/data | awk "{print $1}")


Тогда проверка станет ближе к реальности:
if [ "$free_kb" -lt "$need_kb" ]; then
echo "backup may not fit" >&2
exit 1
fi


Такой скрипт не делает backup умнее сам по себе, но убирает неприятный класс ошибок. Лучше упасть до начала операции, чем получить недописанный архив и узнать об этом только при восстановлении.

➡️ DevOps Ready | #практика
  • 👍 9
  • ❤ 7
  • 🔥 6
Post #1254 1.36K
Шпаргалка по Ansible!

Например, ad-hoc команды помогают быстро выполнить действие на группе серверов, inventory описывает хосты, а playbook позволяет хранить автоматизацию в YAML-файле.

Сохрани, чтобы не потерять!

➡️ DevOps Ready | #ресурс
  • ❤ 9
  • 👍 8
  • 🔥 5
Post #1253 1.34K
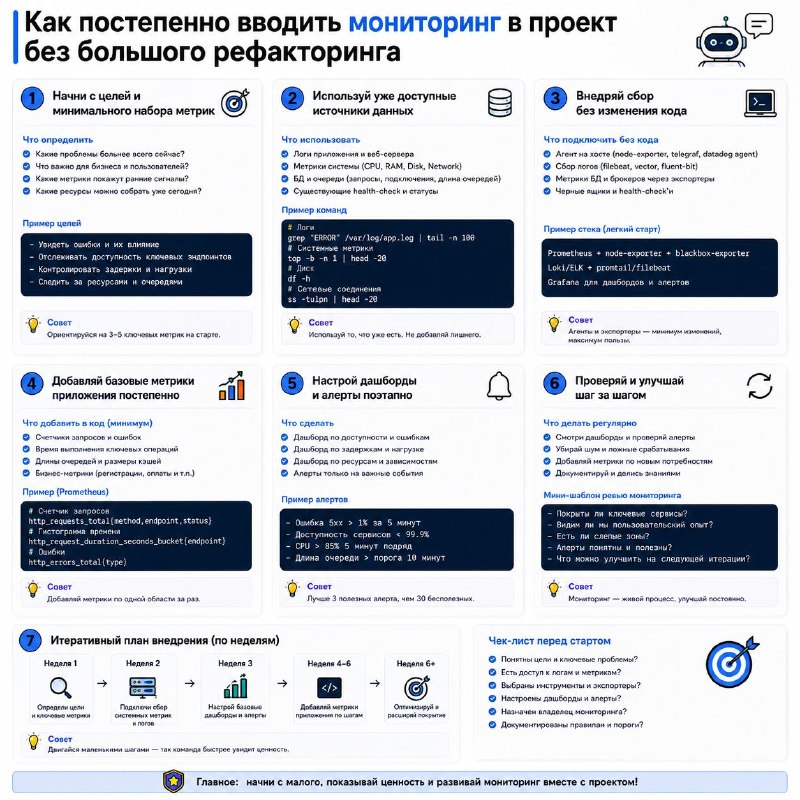
📂 Напоминалка по постепенному внедрению мониторинга в проект!

Мониторинг помогает раньше замечать ошибки, деградацию производительности и проблемы с доступностью, но для старого проекта необязательно сразу делать большой рефакторинг. На картинке показаны 7 шагов: от определения ключевых метрик и использования готовых логов до подключения агентов, добавления базовых метрик, настройки дашбордов и алертов, а также постепенного улучшения системы.

Сохрани, чтобы не потерять!

➡️ DevOps Ready | #ресурс
  • 👍 11
  • 🔥 8
  • ❤ 7
Post #1252 1.36K
Запускаем скрипт по расписанию через systemd timer!

Cron удобен, но в systemd есть свой способ запускать задачи по расписанию. Он хорошо дружит с логами journalctl, статусами юнитов и обычной системой сервисов.

Пусть есть простой скрипт обслуживания:
/opt/jobs/cleanup.sh


Сначала сделаем его исполняемым:
sudo chmod +x /opt/jobs/cleanup.sh


Теперь создадим service-unit. Именно он описывает, что запускать:
sudo nano /etc/systemd/system/cleanup.service


Минимально нужен тип oneshot:
Type=oneshot


Команду запуска указываем отдельно:
ExecStart=/opt/jobs/cleanup.sh


Теперь создаём timer-unit:
sudo nano /etc/systemd/system/cleanup.timer


Например, ежедневный запуск можно описать так:
OnCalendar=daily


Если сервер был выключен во время расписания, полезен Persistent:
Persistent=true


После создания файлов перечитываем конфигурацию systemd:
sudo systemctl daemon-reload


Включаем таймер:
sudo systemctl enable --now cleanup.timer


Проверить расписание можно так:
systemctl list-timers cleanup.timer


А логи последнего запуска смотрятся через journalctl:
journalctl -u cleanup.service


Service отвечает за действие, timer отвечает за расписание. Поэтому одну и ту же задачу можно запускать вручную, по расписанию и удобно проверять через стандартные инструменты systemd.

➡️ DevOps Ready | #практика
  • 👍 9
  • 🔥 5
  • ❤ 3
Post #1251 1.35K
40 собесов и оффер за 1 месяц

Алексей разработчик.

Искал работу с декабря - написание сопроводов и отклики занимали очень много времени.

Выхлоп - почти нулевой.

В какой-то момент понял:
так можно искать бесконечно.

И по совету друга попробовал ии-ассистента для автооткликов - Софи.

▫️За ~1 месяц прошел около 40 собеседований
▫️Получил оффер с вакансии, на которую, по его словам, не откликнулся бы сам

В описании она выглядела скучно, а по факту - одна из самых интересных компаний, с которыми я общался.


Весь процесс - от первого собеседования до оффера - занял 4 дня.

Зарегистрироваться и попробовать Софи можно здесь.

3 дня - бесплатно.
  • 👍 3
Post #1250 1.25K
Знали, зачем перед rsync --delete почти всегда делать dry-run?

rsync часто используют для деплоя, бэкапов и синхронизации директорий. Команда быстрая, удобная и хорошо переносит только изменившиеся файлы.

Ключ --delete полезен, когда целевая папка должна точно совпадать с источником. Например, в dist удалили старый JS-файл, значит на сервере он тоже должен исчезнуть.

Обычный деплой может выглядеть так.
rsync -av --delete ./dist/ server:/var/www/app/


Но именно --delete делает команду опасной. Если перепутать путь, слеш или переменную окружения, можно удалить не те файлы на удалённой стороне.

Особенно часто ошибаются с завершающим слешем. Эти две команды выглядят почти одинаково, но смысл у них разный.
rsync -av ./dist/ server:/var/www/app/
rsync -av ./dist server:/var/www/app/


В первом случае копируется содержимое папки dist. Во втором случае внутрь назначения может попасть сама папка dist.

Перед реальным запуском лучше посмотреть план изменений.
rsync -av --delete --dry-run ./dist/ server:/var/www/app/


--dry-run показывает, что команда собирается скопировать и удалить, но ничего не меняет. Это хороший предохранитель перед первым запуском или изменением пути.

Для более читаемого вывода можно добавить --itemize-changes.
rsync -av --delete --dry-run --itemize-changes ./dist/ server:/var/www/app/


Так проще увидеть, какие файлы будут добавлены, изменены или удалены. Особенно полезно смотреть строки удаления перед запуском без --dry-run.

Если команда собирается из переменных, dry-run становится ещё важнее.
SRC="./dist/"
DST="server:/var/www/app/"
rsync -av --delete --dry-run "$SRC" "$DST"


Так можно быстро заметить пустую переменную, неправильный путь или неожиданный каталог назначения.

Когда вывод выглядит нормально, можно запустить ту же команду без --dry-run.
rsync -av --delete ./dist/ server:/var/www/app/


В CI/CD удобно делать dry-run отдельным ручным шагом для новых deploy-команд. А для регулярных задач стоит хотя бы использовать его при первом запуске после изменения путей.

Перед опасной синхронизацией можно отдельно проверить, сколько удалений планируется.
rsync -av --delete --dry-run --itemize-changes "$SRC" "$DST" | grep "^\*deleting"


Если удалений внезапно слишком много, запуск лучше остановить и перепроверить переменные.

Ещё полезно держать источник и назначение в логах.
echo "SRC=$SRC"
echo "DST=$DST"


Это звучит просто, но в реальном deploy-скрипте такая печать часто экономит много времени при разборе инцидента.

➡️ DevOps Ready | #совет
  • ❤ 8
  • 👍 5
  • 🔥 4
Post #1248 1.51K
Test Your Sysadmin Skills - большая база вопросов для Linux и DevOps!

В этом репозитории собраны сотни вопросов и ответов по Linux, сетям, безопасности, webops, базам данных, системным задачам и диагностике. Материал удобно использовать для самопроверки, подготовки к собеседованиям и поиска тем, которые стоит подтянуть.

Оставляю ссылочку на GitHub

➡️ DevOps Ready | #репозиторий
  • 👍 9
  • 🔥 8
  • ❤ 3
  • 👎 2
Post #1243 1.46K
Разбираем SSH 7 команд для подключения и диагностики!

SSH нужен не только для входа на сервер. С ним удобно проверять проблемы подключения, ходить через bastion-host, пробрасывать локальные порты, копировать ключи и переносить файлы.

Полезно для ежедневной работы с серверами, staging-средами, приватными сетями и диагностики доступа.

➡️ DevOps Ready | #шпора
  • 🔥 15
  • 🤝 12
  • 👍 5
  • ❤ 3
Post #1242 1.76K
Шпаргалка по Linux permissions!

Например, chmod 755 даёт владельцу полный доступ, а группе и остальным оставляет чтение и запуск. А chmod 600 часто используют для приватных ключей и конфигов с секретами.

На картинке разобраны права владельца, группы и остальных пользователей, числовые значения r/w/x, а также SUID, SGID и sticky bit.

Сохрани, чтобы не потерять!

➡️ DevOps Ready | #ресурс
  • 👍 12
  • ❤ 7
  • 🔥 4
  • 👎 1
Post #1241 1.59K
Настраиваем ротацию логов через logrotate!

Если приложение постоянно пишет в один файл, лог может незаметно вырасти до гигабайтов. В итоге диск заполняется, поиск ошибок становится медленнее, а сервис может начать падать просто из-за нехватки места.

Допустим, приложение пишет сюда:
/var/log/myapp/app.log


Для таких файлов удобно завести отдельное правило в logrotate.

Создадим конфиг:
sudo nano /etc/logrotate.d/myapp


Сначала указываем, какие логи нужно обрабатывать:
/var/log/myapp/*.log {


Теперь добавим ежедневную ротацию:
daily


Оставим только последние семь архивов:
rotate 7


Чтобы старые логи занимали меньше места, включим сжатие:
compress


Если файла временно нет, это не должно ломать весь запуск logrotate:

missingok


Пустой лог тоже нет смысла перекладывать в архив:

notifempty


Для простых приложений часто добавляют copytruncate. Он копирует текущий лог в архив, а исходный файл обрезает до нуля:

copytruncate


Это полезно, когда приложение не умеет переоткрывать лог-файл после сигнала. Минус тоже есть: в момент копирования можно потерять несколько строк, если приложение пишет очень активно.

В конце закрываем правило:

}


Перед применением лучше проверить конфиг в debug-режиме:

sudo logrotate -d /etc/logrotate.d/myapp


Так команда покажет, что собирается сделать, но не будет реально трогать файлы.

Если всё выглядит нормально, можно принудительно выполнить ротацию:

sudo logrotate -f /etc/logrotate.d/myapp


Потом проверяем каталог с логами:

ls -lh /var/log/myapp


В рабочей системе logrotate обычно запускается автоматически по таймеру или cron. Поэтому после настройки достаточно один раз проверить правило и дальше следить, что архивы появляются ожидаемо.

Такой подход помогает держать логи под контролем и не ждать момента, когда один шумный файл заполнит весь диск.

➡️ DevOps Ready | #практика
  • 👍 7
  • ❤ 4
  • 🔥 4
Post #1239 1.74K
Killercoda - DevOps-лабы прямо в браузере!

На сайте можно запускать готовые сценарии по Linux, Docker, Kubernetes, Git, Grafana, Argo, Istio, Falco и другим инструментам. Всё открывается как интерактивная среда с терминалом, поэтому можно не просто читать, а сразу выполнять команды.

Ресурс полезен для тренировки реальных действий. Можно открыть Kubernetes playground, пройти сценарий по Docker или потрогать инструменты CNCF без локальной установки.

Оставляю ссылочку на Killercoda

➡️ DevOps Ready | #ресурс
  • 🔥 9
  • ❤ 6
  • 👍 4
Post #1238 1.57K
Знали, зачем в curl использовать --fail вместе с проверками в скриптах?

Обычный curl может завершиться успешно даже тогда, когда сервер вернул HTTP-ошибку:
curl https://example.com/missing


Если сервер ответил 404, команда всё равно может вернуть exit code 0, потому что сетевой запрос технически выполнился.

В shell-скриптах это опасно:
curl "$URL" -o app.tar.gz
tar -xzf app.tar.gz


Можно скачать HTML-страницу с ошибкой вместо архива и узнать об этом только на следующем шаге.

Для таких случаев добавляют --fail:
curl --fail "$URL" -o app.tar.gz


Теперь HTTP-коды 400/500 будут считаться ошибкой команды.

Чаще всего это комбинируют с --silent и --show-error:
curl --fail --silent --show-error \
"$URL" -o app.tar.gz


Для CI/CD или deploy-скриптов удобно сразу останавливать выполнение:
curl --fail --silent --show-error "$URL" -o app.tar.gz
tar -xzf app.tar.gz


Если нужен retry:
curl --fail --retry 3 --retry-delay 2 \
"$URL" -o app.tar.gz


Так временные сетевые ошибки можно пережить, а настоящие HTTP-ошибки не будут замаскированы под успешную загрузку.

➡️ DevOps Ready | #совет
  • 👍 11
  • ❤ 5
  • 🔥 4
Post #1236 1.53K
📂 Напоминалка по архитектуре минимального, но рабочего CI/CD-пайплайна!

Часто при настройке автоматизации возникает соблазн сразу построить огромный комбайн с кучей проверок, из-за чего пайплайн постоянно падает, а релизы застревают.

На этой схеме — пошаговый гайд о том, как спроектировать лаконичный и стабильный CI/CD-пайплайн для одного микросервиса, который закроет 80% потребностей команды и не будет перегружен лишней логикой.

Сохрани в закладки, чтобы использовать как готовый шаблон для своих проектов!

➡️ DevOps Ready | #ресурс
  • 👍 9
  • ❤ 6
  • 🔥 4
Post #1235 1.76K
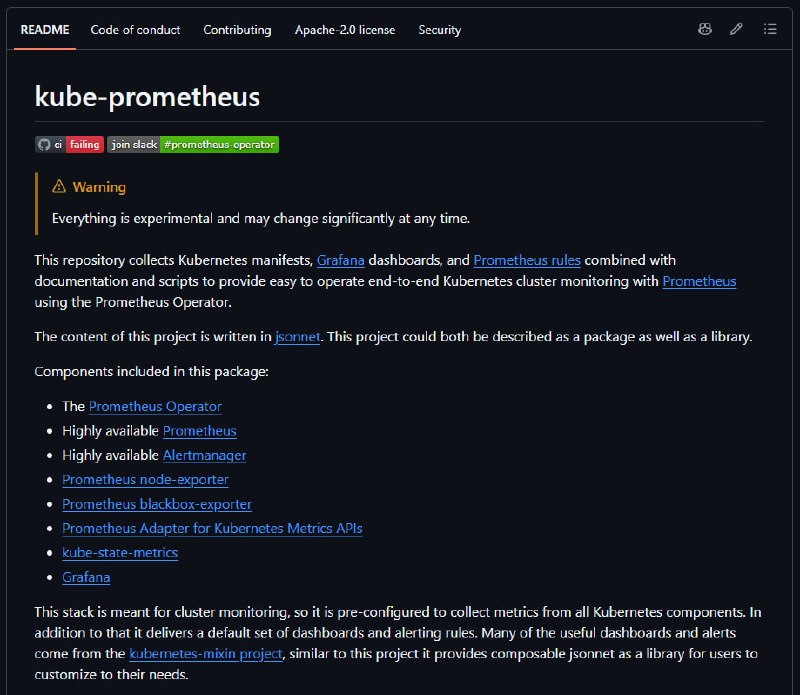
kube-prometheus — готовая база для мониторинга Kubernetes!

В этом репозитории собран полноценный monitoring stack для Kubernetes: Prometheus Operator, Prometheus, Alertmanager, Grafana, node-exporter, kube-state-metrics, готовые dashboards и alert rules. Хороший вариант, чтобы посмотреть, как в реальности собирают наблюдаемость кластера не из одного контейнера, а из набора Kubernetes-манифестов и связанных компонентов.

Оставляю ссылочку: GitHub


➡️ DevOps Ready | #репозиторий
  • ❤ 13
  • 🔥 7
  • 👍 6
Post #1234 1.61K
Знали, как не дать cron-задаче запуститься второй раз поверх первой?

Иногда скрипт запускается по расписанию, но предыдущий запуск ещё не закончился. Например, backup, импорт данных, rsync или очистка логов могут выполняться дольше обычного.

Обычный cron выглядит так:
* * * * * /opt/jobs/backup.sh


Если backup занимает больше минуты, следующий запуск начнётся параллельно:
backup.sh
backup.sh
backup.sh


Это может привести к битым архивам, двойной нагрузке, конфликтам файлов и странным ошибкам.

Для таких случаев используют flock:
flock -n /tmp/backup.lock /opt/jobs/backup.sh


Файл /tmp/backup.lock здесь не хранит данные. Он нужен как точка блокировки.

Ключ -n означает: если lock уже занят, не ждать, а сразу выйти:
flock -n /tmp/backup.lock ./backup.sh


В cron это можно записать так:
* * * * * flock -n /tmp/backup.lock /opt/jobs/backup.sh


Если первый запуск ещё работает, второй просто не стартует.

Для более явного варианта можно использовать shell:
flock -n /tmp/backup.lock \
bash -c 'echo start; ./backup.sh'


А если нужно немного подождать lock, есть timeout:
flock -w 10 /tmp/backup.lock ./backup.sh


Так команда подождёт до 10 секунд, а потом завершится, если блокировка всё ещё занята.

➡️ DevOps Ready | #совет
  • 🔥 7
  • ❤ 4
  • 👍 4
Post #1232 1.29K
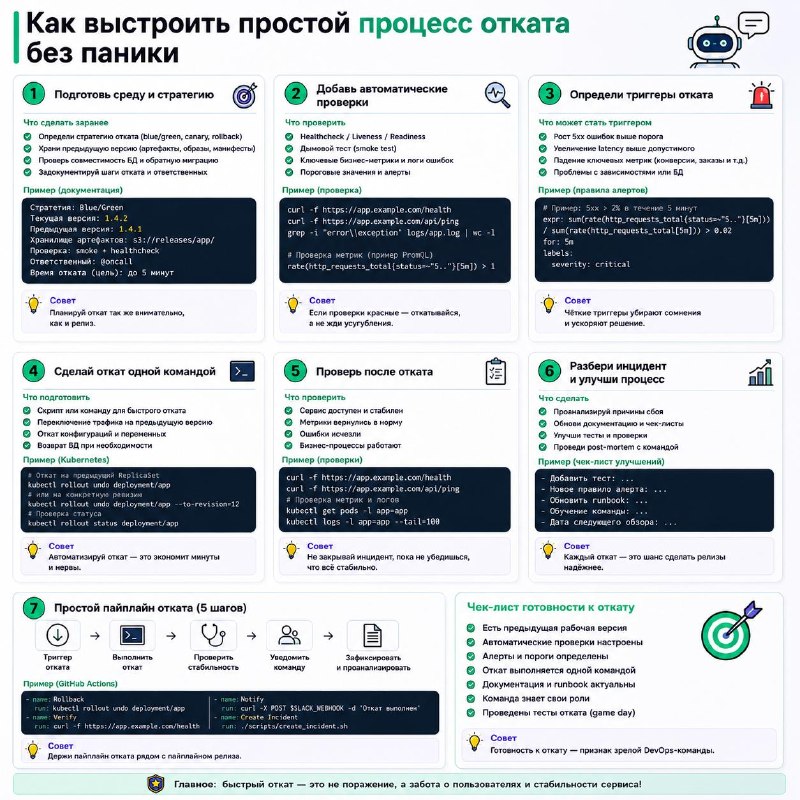
📂 Напоминалка по организации безопасного отката релизов!

Даже после тщательного тестирования новый релиз может привести к ошибкам, деградации производительности или недоступности сервиса. Чётко выстроенный процесс отката позволяет быстро восстановить стабильную версию и минимизировать влияние инцидента на пользователей.

На картинке — 7 шагов построения процесса отката: подготовка стратегии и предыдущей версии, настройка автоматических проверок, определение триггеров для rollback, выполнение отката одной командой, проверка состояния системы после восстановления, разбор причин инцидента и улучшение процесса, а также простой пайплайн отката с чек-листом готовности.

Сохрани, чтобы не потерять!

➡️ DevOps Ready | #ресурс
  • ❤ 4
  • 🔥 4
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →