TGViewer
Channel Public Channel
DevOps не горит

DevOps не горит

@devops_not_burn

Девопс не горит — канал про инфраструктуру, Kubernetes, Observability и Platform Engineering. Продакшен, интересные инструменты, инженерные грабли и немного конференционной движухи. Иногда всё-таки горит =)
Связаться с автором - @mrgreyves
Subscribers
505
Photos
41
Videos
0
Links
75

Showing posts older than #108 · Back to latest

Older Posts 11 shown
Post #107 954
Одна_CLI_чтобы_управлять_всем_миром.pptx18 MB
Коллеги, всем привет!=)
Big Tech Night отгремел, а я, как и обещал, делюсь свое презентацией
Формат pptx оставил специально потому что там есть подстрочник
Авторская орфография конечно же сохранена
Enjoy ^_^
  • 🔥 13
  • ❤ 4
  • 👍 4
  • 👏 1
Post #106 1.08K
Big Tech Night
Коллеги, всем привет! =)
12 сентября буду выступать на конференции Big Tech Night
В офисе коллег из Lamoda Tech я расскажу “как при помощи одной cli управлять всем миром”
Ох и не простое это было приключение, начиная от дизайна и заканчивая тем как мы это внедряли. Сложности начались с дизайна и закончились на этапе нотификаций. Мы перепробовали кучу всего, некоторые части компонентов переписывали вообще несколько раз.
Хотя, казалось бы ага, цель у нас была простая, дать разработчикам возможность влиять на инфраструктуру при этом не выстрелив в ногу командам эксплуатации
Приходи, будет интересно =)
ЗЫ - после конференции я конечно же приложу запись и все материалы =)
  • 👍 11
  • 🔥 7
  • 👏 4
Post #105 839
Terragrunt и обработка ошибок
Коллеги, всем привет! =)
Иногда, а именно когда мы раскатываем инфраструктуру пепелайном с terragrunt/terraform, мы можем столкнуться с ошибками. Конечно же ошибки нужно фиксить системно, но всегда это быстро или возможно в принципе. По этому приходится что-то придумывать.
Для связки pipeline+terragrunt/terraform можно выделить 2 типа ошибок:
1 - мы не можем поработать со стейтом, провайдером, модулем, api инфры
2 - что-то уж совсем не так с api инфры
Проблемы под номером “РАЗ” вполне себе могут решаться ретраем, сделать это можно двумя способами:
— используя утилиту retry (да, оно будет работать, но бинарь придется собирать самостоятельно и ретрай будет всегда когда exit code ≠ 0, что не всегда удобно)
— используя встроенный обработчик ошибок terragrunt (это вариант нам как раз и подходит, так как работать с ошибками можно достаточно гранулярно)
На практике нам достаточно добавить блок errors в привыйный нам terragrunt.hcl
Пример:

errors {
retry "source_fetch" { #имя ошибки
retryable_errors = [".*Error refreshing state: .*"] #регулярка для поиска конкретной ошибки
max_attempts = 3 #количество ретраев
sleep_interval_sec = 5 #ожидание между ретраями
}
}

В конфигурацию мы можем добавить ретраи для нескольких ошибок или написать мега регулярку. Обязательно стоит помнить что использовать .* в случае инфры может быть не самой лучшей затеей
Enjoy =)
PS - да, да, я снова пишу редко, как говорит мой батя “То пьянка, то партсобрание”
PSS - в ближайшие пару дней будет несколько анонсов =)
  • 🔥 11
  • 👍 6
Post #104 1.02K
TOD`25

Коллеги, всем привет!)
19 мая поучаствовал в T-bank Observability Days
В этот раз формат был немного другим и состоял из круглых столов и инженерных сессий
Мы с коллегами по участвовали в инженерной сессии, где весело и задорно пообсуждали тренды Observability, Observability 2.0, обсудили боли/проблемы и вот это вот все =)
Запись инженерной сессии доступна тут
ЗЫ - а еще я тут научился открывать результаты компьютерной тамографии в полевых условиях на маке, но это совсем другая история =)
YouTube Технологический вектор развития платформ наблюдаемости и связанных с ними компонентов Разобрали, какие подходы, платформы и инструменты актуальны для решения задач наблюдаемости, мониторинга и инцидент-менеджмента. Таймкоды: 00:00:00 Доклад: «O11y: технологический радар. Сводный технологический радар на основе опыта Thoughtworks» 00:30:45…
  • 🔥 9
  • 👍 7
Post #103 1.16K
DevOps Conf 2025 - Итоги
Коллеги, всем пятнички! =)
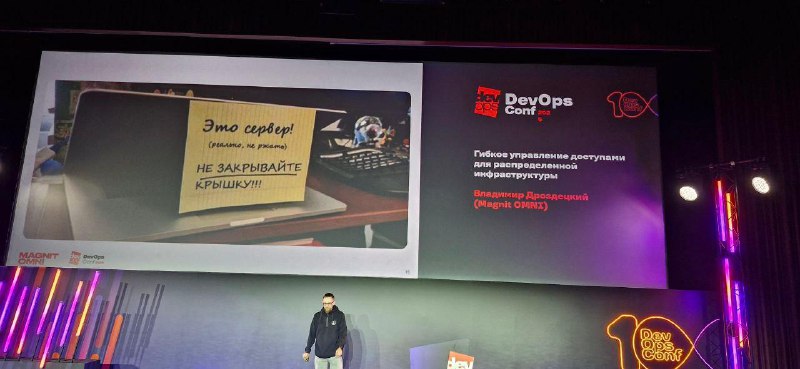
А вот и ссылка на мой доклад Гибкое управление доступами для распределенной инфраструктуры с прошедшего DevOps Conf 2025
Как говорится “лайк, шер”
Отдельно хочу выразить благодарность Диме, Ване и Саше за помощь в подготовке, ревью и советы =)
ЗЫ - если во время подготовки к конференции вам предлагают записаться к коучу который помогает с презентациями и выступлениями - не скипайте. Из такой встречи вы можете вынести много полезного
  • 👍 11
  • 🔥 7
  • ❤ 1
  • 💯 1
Post #102 1.39K
Коллеги, всем привет!=)
Напоминаю, что сегодня состоится Omni Infrastructure Meetup
Как оффлайн в офисе, так и онлайн
Ссылка на трансляцию - https://facecast.net/w/q45mdd
Приходи лично или подключайся к трансляции, будет интересно =)
UPD - ссылка на чатик митапа https://t.me/+9jmwV2imOLEyZWIy , если вы в онлайне, в нем вы можете задать вопрос спикерам
  • 👍 8
  • 🔥 4
Post #101 1.58K
Коллеги, всем привет! =)
Список полезных материалов к моему докладу “Гибкое управление доступами для распределенной инфраструктуры”
Netbird - официальный сайт
Github - официальный github репозиторий проекта
API документация - документация API
Keycloak Intergration - настройка интеграции с KK
Troubleshooting - траблшутинг “клиентской” части
  • 🔥 14
  • 👍 4
  • 🌚 1
Post #100 1.33K
Коллеги, всем привет!)
Небольшая минутка спойлеров моего будущего доклада =)
  • 😁 15
  • 🔥 11
  • 👍 1
Post #90 1.18K

Forwarded from DevOps // Human Help

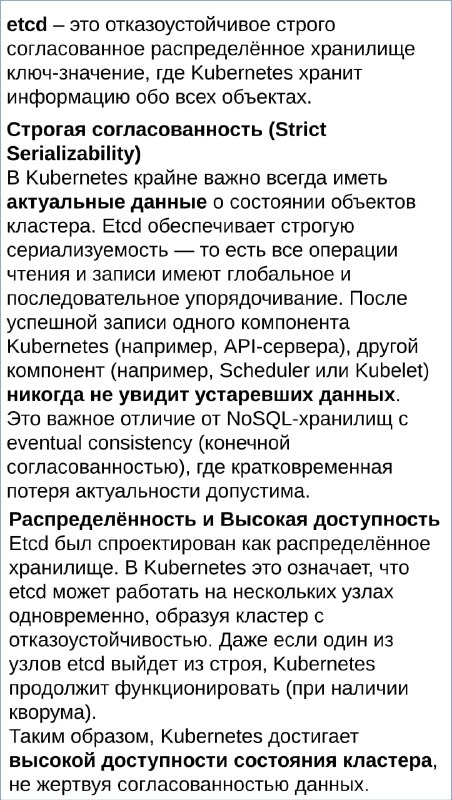
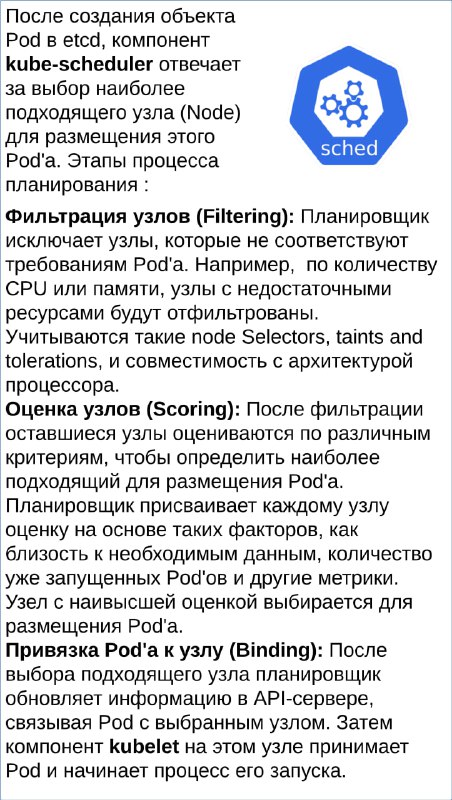
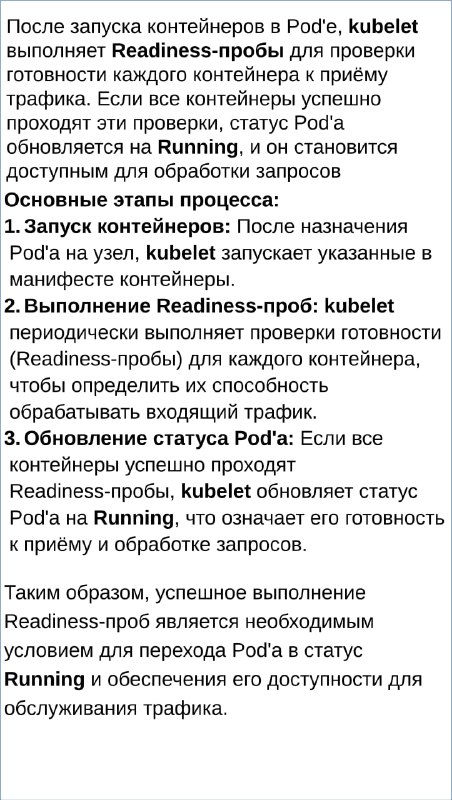
⌨️ K8s. Вопрос о деплое пода

#k8s

Опишите путь, который проходит Pod от момента деплоя его манифеста до статуса Running
  • 🔥 15
  • 👍 4
Post #89 737
Коллеги, всем хорошей пятнички!=)
Иии, это первый гостевой пост
Глеб в своем канале пишет всякое-интересное и не только про k8s
А еще у него крутые карточки, как вот эти, вдруг вы захотите вспомнить, а как оно там работает =)
  • 👍 4
Post #88 2.45K
Оооочень интересный дебаг
Коллеги, всем привет! =)
После небольшое затишься, очередной, надеюсь интересный пост про то как мы дебажили историю “а почему поды не разворачиваются”
Вводная: k8s 1.31, cilium, Istio, 30-03-2025 авария в я.облаке
Все началось с классического запроса от разработчика “сервисы не деплоятся, обновления не катятся”. Хммм, подумал я и пошел дебажить.
helm upgrade - отваливается по таймауту. Последствия воскресного инцидент я.облака и возможно какая то часть инфры находится в залипшем состоянии, а мы и не вкурсе. Проверил раннеры, обновил версию helm`а (чисто на всякий случай, текущая была не сильно новой) - проблема сохраняется. Хмм подумал я второй раз и решил попробовать развернуть сервис “начисто”. У сервиса в чарте сабчартом подключен redis.
Ииии redis разворачивается, а подов сервиса нет 0_о
В events совершенно ничего интересно. Посмотрел всякое, посмотрел телеметрию - ничего сильно страшного не видно. Иииии потом я вспоминаю, что deployment сервиса, на самом деле “внтури” replicaset (вы же знаете, что весь k8s - это абстракция на абстракции). Посмотрел, что там с replicaset и увидел следующее:

Warning FailedCreate 26s replicaset-controller Error creating: Internal error occurred: failed calling webhook "object.sidecar-injector.istio.io": failed to call webhook: Post "https://istiod.istio-system.svc:443/inject?timeout=10s": dial tcp ${istio-pod-ip}:15017: connect: connection timed out

Опппа, контроллер не может отправить вебхук в истио, что бы он добавил сайдкар в наш под. Становится интересно.
Из неймспейса проверяю связность при помощи nc, curl - все хорошо. Replicaset все еще не может отправить вебхук в истио.
Перезапускаю istio контроллер (просто делаю роллаут) и на всякий случай “пинаю” mutatingwebhook istio. Результата нет. На всякий случай “собираю” отдельный деплоймент и тестирую его в отдельном неймспейсе, что бы исключить сетевые политики, после тестирую размещение на разных нодах - результат тот же.
Ооооокай, что там у нас с cilium?
Проверяю ns kube-system и вижу что там, после “воскресных приключений”, ооочень много подов istio-operator висят в статусе containerstatusunknown. Подчищаю контейнеры и делаю роллаут подов cilium. Результат все тот же. Все кому нужно “хукануть” истио, что бы произошел инжект сайдкара не могут этого сделать.
Штош, тут мои полномочия все, оформляю критикал тикет в саппорт.
Саппорт отвечает быстро, и предлагает выполнить команду

k get ciliumnodes.cilium.io

На выходе мы получаем список нод нашего кластера, которые “входят в сеть cillium”
И видим мы там ооочень интересные вещи, а именно:

NAME CILIUMINTERNALIP
master-a 1.1.1.1
master-c 1.1.1.2
master-d 1.1.1.2
k8s-master-a 1.1.1.1
k8s-master-b 1.1.1.3
k8s-master-c 1.1.1.2
k8s-master-d 1.1.1.2
#адреса конечно же не такие, следите за последним октетом

И первый же мой вопрос: “Чегооооо? Откуда у меня мастера в зоне С которую мы разорабрали 2 квартала назад? И почему мастеров так много если их должно быть 3?”
Естественно я уточнил, а какой мастер актуален для кластера на данный момент. Саппорт уточнил актуального мастера и рекомендовал, удалить старые. Старые мастера удалены, вебхуки работают, приложения деплоятся/обновляются, все счастливы.
Произойти такое могло, скорее всего из-за той мега аварии в я.облаке 30-03-2025 (но это не точно, так как старые мастера у меня были достаточно давно)
Мораль сего приключения такова - не забывайте, что в k8s много абстракций =)
Фан факт - коллеги с соседних бизнес доменом с таким сталкивались ранее и ответили мне быстрее чем саппорт =)
ЗЫ1 - как это можно обнаружить заранее - логи управляющих компонентов, там по идеи все должно быть видно =)
ЗЫ2 - весь пост написан от моего лица, но на самом деле нас было двое, Серег, спасибо большое ^_^
ЗЫ3 - коллеги, из соседнего домена, Дим, Макс, Лех, спасибо за помощь в дебаге ^_^
  • 👍 13
  • 🔥 11
  • 🤯 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →